Cuantifiqué mi LLM casero de 300 millones de parámetros y comparé la velocidad y la precisión en CPU
El modelo de 320 millones de parámetros para RAG en croata que hice en el artículo anterior. Como está pensado para ejecutarse en CPU, esta vez probé a cuantificarlo para ver cuánto podía reducirse y acelerarse, y hasta qué punto bajaba la precisión.
Primero, la conclusión.
- Q6_K es el punto ideal. Ocupa 1/5 del tamaño (254 MB), genera unas 4 veces más rápido y mantiene la misma precisión que el modelo original
- Q2_K se rompe. Es rápido, pero empieza a responder «no hay respuesta» incluso a preguntas que sí la tienen
- Sorprendentemente, Q3_K_M fue más preciso que Q4_K_M
Lo que hice
Convertí el modelo creado en PyTorch a un formato que puede ejecutar llama.cpp, muy usado para inferencia en CPU (GGUF), y lo guardé con ocho niveles de precisión.
- Exporté el modelo en el mismo formato que Qwen3 y lo convertí a GGUF
- Como el tokenizador es propio, llama.cpp rechazó la conversión al considerarlo un «tokenizador desconocido». Comparé las reglas de segmentación de palabras y eran idénticas, carácter por carácter, a las de Qwen2, así que lo registré como Qwen2 y pude continuar
- Comprobé que la conversión fuera correcta. La tokenización de 160 textos coincidió por completo con la versión de PyTorch. En 20 preguntas, al generar eligiendo siempre la palabra con mayor probabilidad, las salidas también coincidieron completamente en las 20
- Generé desde F16 hasta Q2_K con
llama-quantize
Por tanto, el F32 de la tabla tiene el mismo contenido que la versión de PyTorch. Es la referencia de comparación.
Cómo lo medí
- La CPU es un i7-13700K. No usé GPU
- La configuración de llama.cpp fue 8 hilos para generación y 16 para cargar el texto (al probarlo, era la más rápida)
- Hice que cada modelo respondiera 400 veces: 100 preguntas × 4 tipos de contexto de evaluación
- Párrafo: un párrafo de unas 100 tokens que contiene la respuesta
- Texto largo: un texto de unas 3.000 tokens que contiene la respuesta (también incluye artículos no relacionados)
- Sin respuesta (párrafo/texto largo): texto que no contiene la respuesta. Rechazarla cuenta como acierto
- El artículo anterior se midió con 300 preguntas, así que las cifras varían un poco
Resultados: precisión
| Formato | Tamaño | Aciertos en párrafos | Aciertos en textos largos | Rechazos en textos largos | Invenciones (sin respuesta: párrafo/texto largo) | Precisión tras verificación |
|---|---|---|---|---|---|---|
| F32 (referencia) | 1.233MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81,9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81,3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84,4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75,9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80,4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72,2% |
La «precisión tras verificación» es el porcentaje de respuestas correctas después de comprobar por programa que la cita del modelo realmente aparece en el texto y, si no aparece, sustituirla por «sin respuesta».
- F16, Q8_0 y Q6_K son casi idénticos a la referencia. Solo hay una diferencia de una o dos preguntas
- A partir de Q5_K_M, aumentan más los «rechazos» que los errores. Parece conservar tal cual el comportamiento que le enseñé en el artículo anterior: cuando pierde confianza, rechaza responder. Las invenciones no han aumentado
- Q4_K_M es peor que Q3_K_M. En textos largos, 37% frente a 48%. Con 100 preguntas puede haber cierta variación, pero 11 puntos es mucho. Aún no he investigado la causa
- Q2_K rechaza el 78% de los textos largos. Ya es otro modelo
Resultados: velocidad
| Formato | Velocidad de generación | Tiempo medio por ejecución |
|---|---|---|
| PyTorch fp32 (referencia) | Párrafo 14,6 · texto largo 6,7 tok/s | — |
| F32 | 18,7 tok/s | 2,76 segundos |
| F16 | 35,9 tok/s | 2,08 segundos |
| Q8_0 | 59,0 tok/s | 1,93 segundos |
| Q6_K | 73,1 tok/s | 1,33 segundos |
| Q5_K_M | 81,2 tok/s | 1,26 segundos |
| Q4_K_M | 89,1 tok/s | 1,10 segundos |
| Q3_K_M | 103,4 tok/s | 1,12 segundos |
| Q2_K | 119,9 tok/s | 1,07 segundos |
Las cifras de llama.cpp son el promedio de 400 ejecuciones (párrafos, textos largos y casos sin respuesta juntos). Las cifras de PyTorch son las que medí en el artículo anterior.
- La velocidad de generación es casi inversamente proporcional al tamaño. En CPU, depende más de la velocidad de leer los pesos desde memoria que de los cálculos, así que cuanto más pequeño, más rápido
- Incluso con el mismo F32, llama.cpp es más rápido que PyTorch
- Sin embargo, a partir de Q6_K, el tiempo por ejecución apenas se reduce. Con esta longitud, el tiempo inicial de cargar el texto pasa a ser mayor
Vídeo: hice que respondieran la misma pregunta de texto largo en CPU
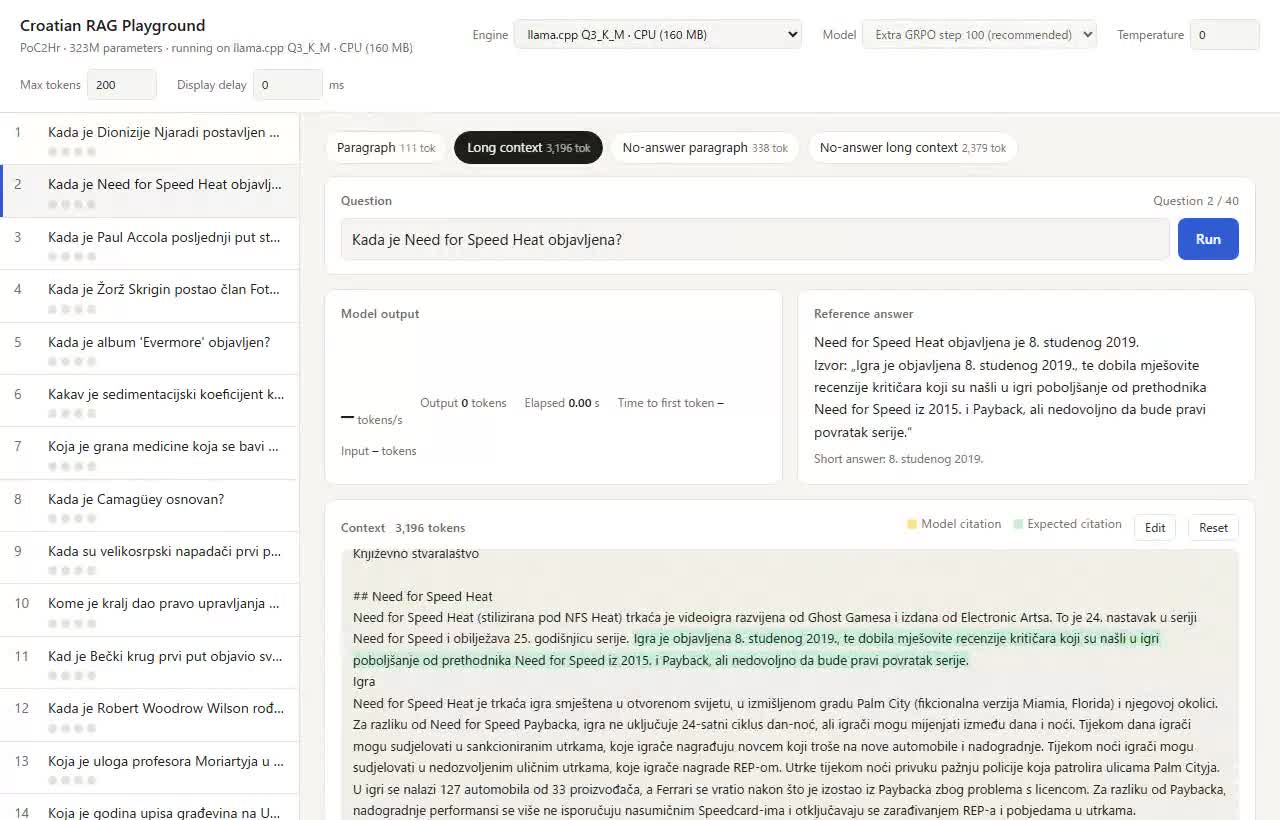
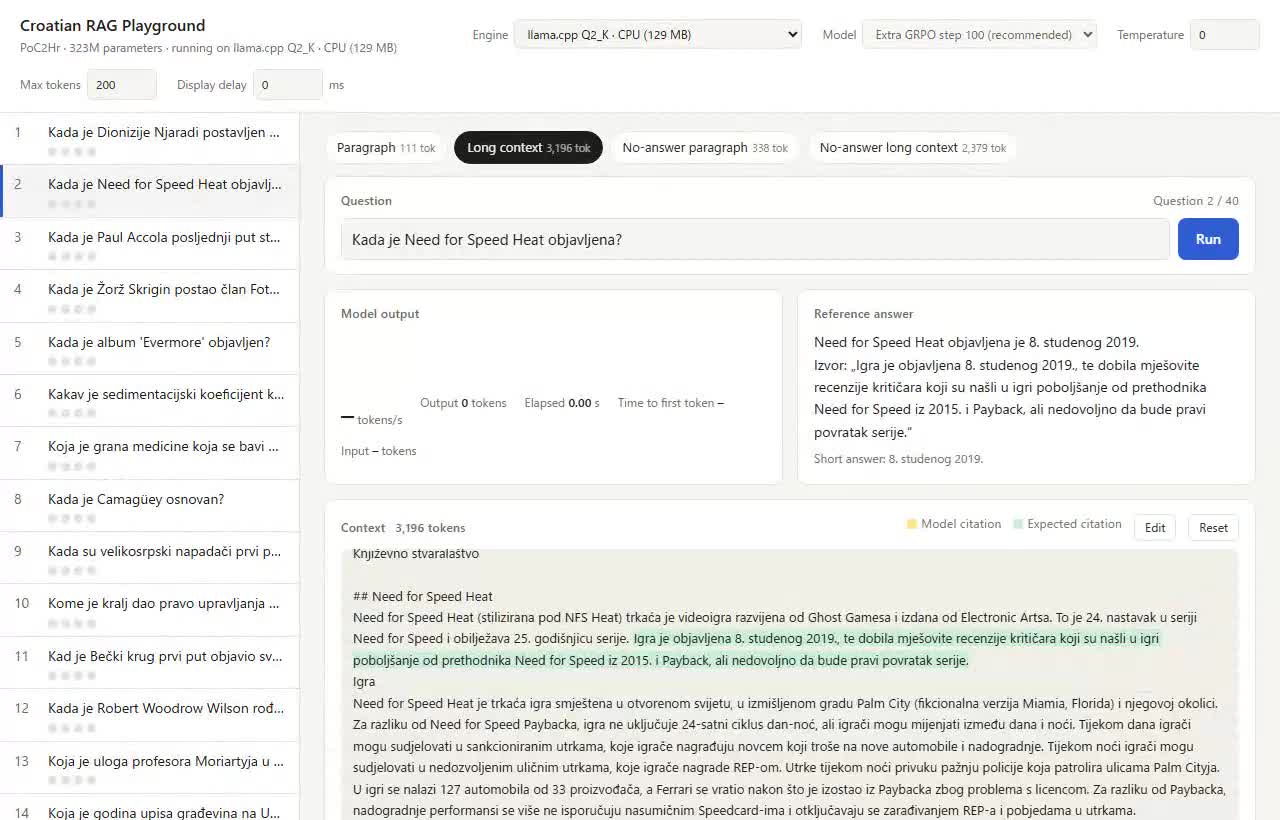
Le di un texto de unas 3.200 tokens y pregunté: «¿Cuándo se lanzó Need for Speed Heat?». La respuesta correcta es el 8 de noviembre de 2019.
Como está ejecutándose mientras grabo y el navegador también dibuja la pantalla, las velocidades del vídeo son inferiores a las de la tabla anterior. Hay que verlo como una comparación en paralelo.
| Formato | Velocidad de generación en el vídeo | Hasta el primer carácter | Total | Resultado |
|---|---|---|---|---|
| PyTorch fp32 | 5,5 tok/s | 4,8 segundos | 18,5 segundos | Correcto |
| F32 | 14,2 tok/s | 2,8 segundos | 8,1 segundos | Correcto |
| F16 | 25,9 tok/s | 3,5 segundos | 6,4 segundos | Correcto |
| Q8_0 | 38,2 tok/s | 4,0 segundos | 5,9 segundos | Correcto |
| Q6_K | 41,6 tok/s | 2,6 segundos | 4,4 segundos | Correcto |
| Q5_K_M | 46,3 tok/s | 2,6 segundos | 4,3 segundos | Correcto |
| Q4_K_M | 47,2 tok/s | 2,3 segundos | 4,7 segundos | Correcto (respuesta algo larga) |
| Q3_K_M | 56,7 tok/s | 2,5 segundos | 4,5 segundos | Correcto (respuesta algo larga) |
| Q2_K | 61,3 tok/s | 2,7 segundos | 2,8 segundos | Rechazó responder |
Desde F32 hasta Q5_K_M, tanto la respuesta como la cita son idénticas, carácter por carácter, a la versión de PyTorch. Q4_K_M y Q3_K_M alargaron la frase de respuesta, pero la cita era correcta. Q2_K respondió «no hay respuesta en el texto» pese a que sí la había.
PyTorch fp32 (modelo original)
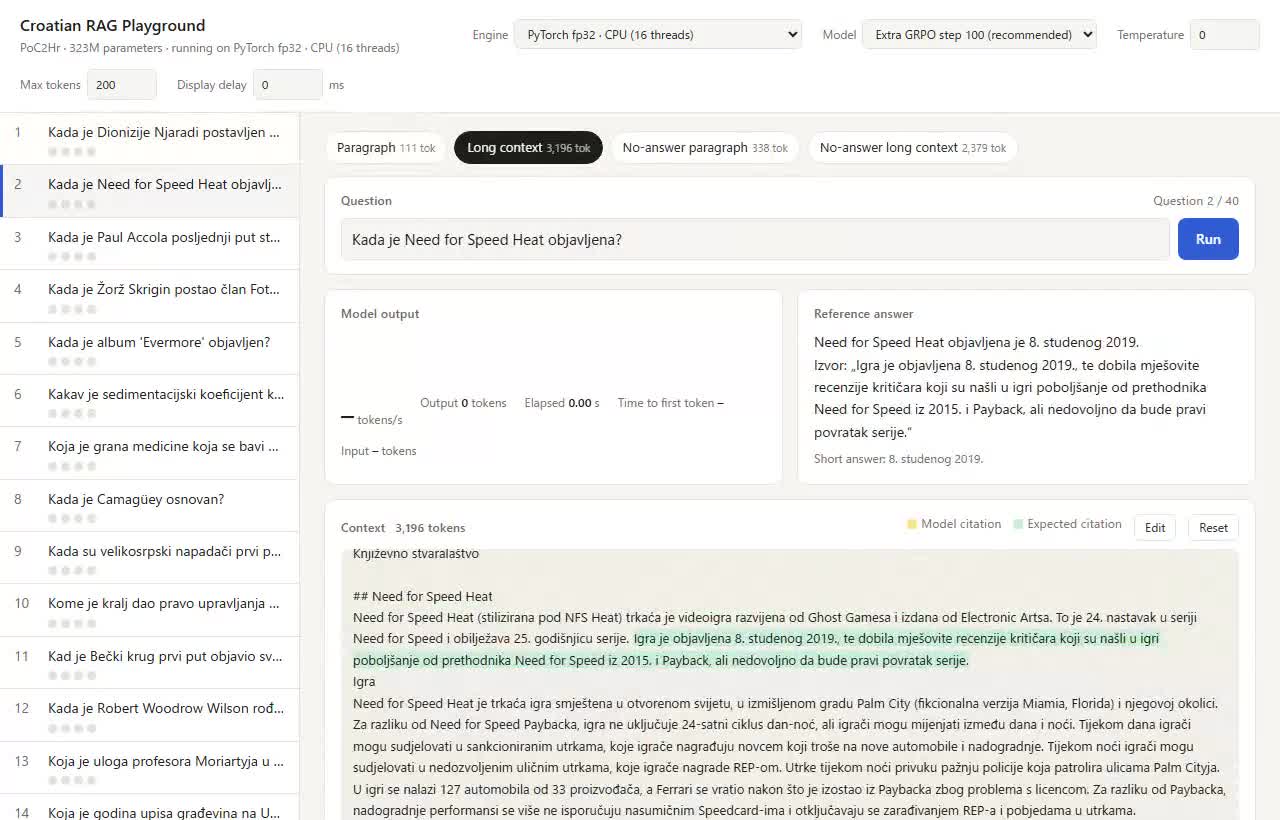
llama.cpp F32 (1.233MB)
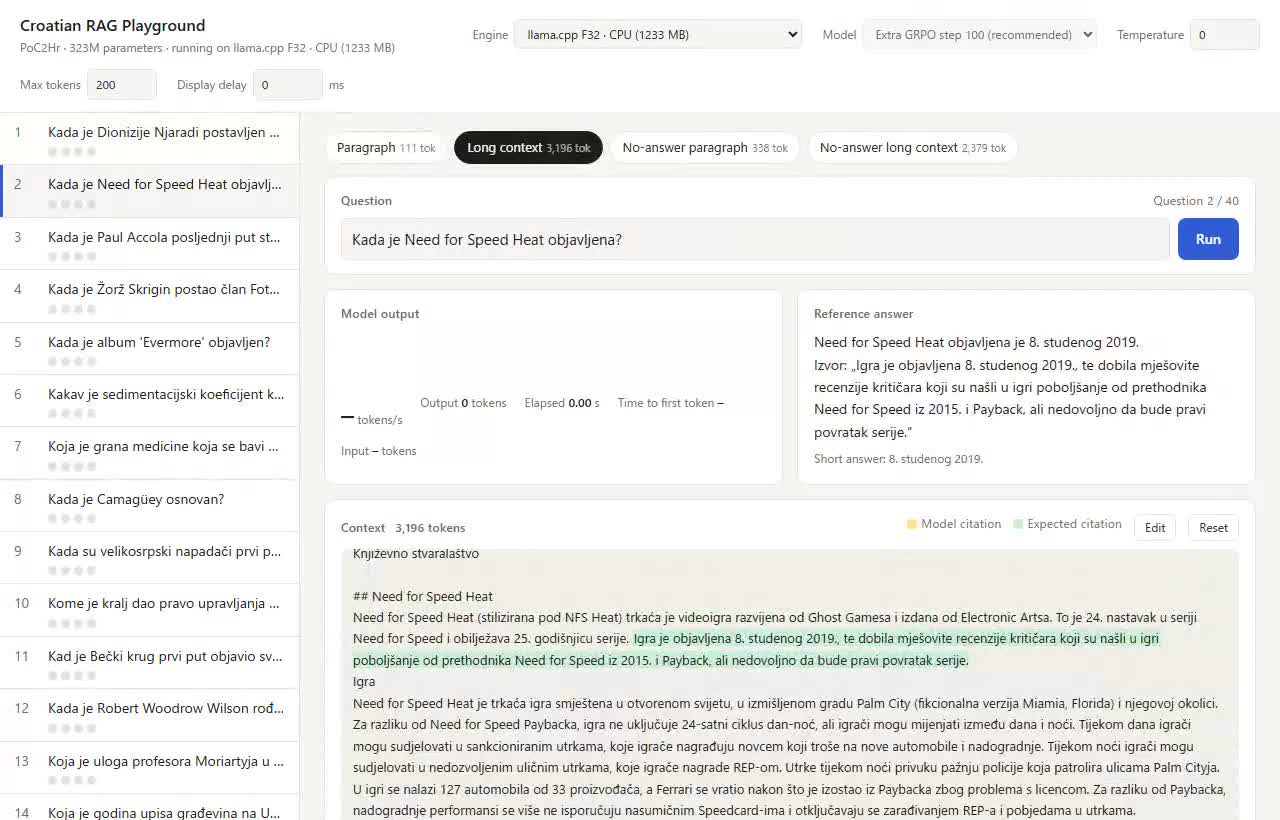
llama.cpp F16 (617MB)
llama.cpp Q8_0 (329MB)
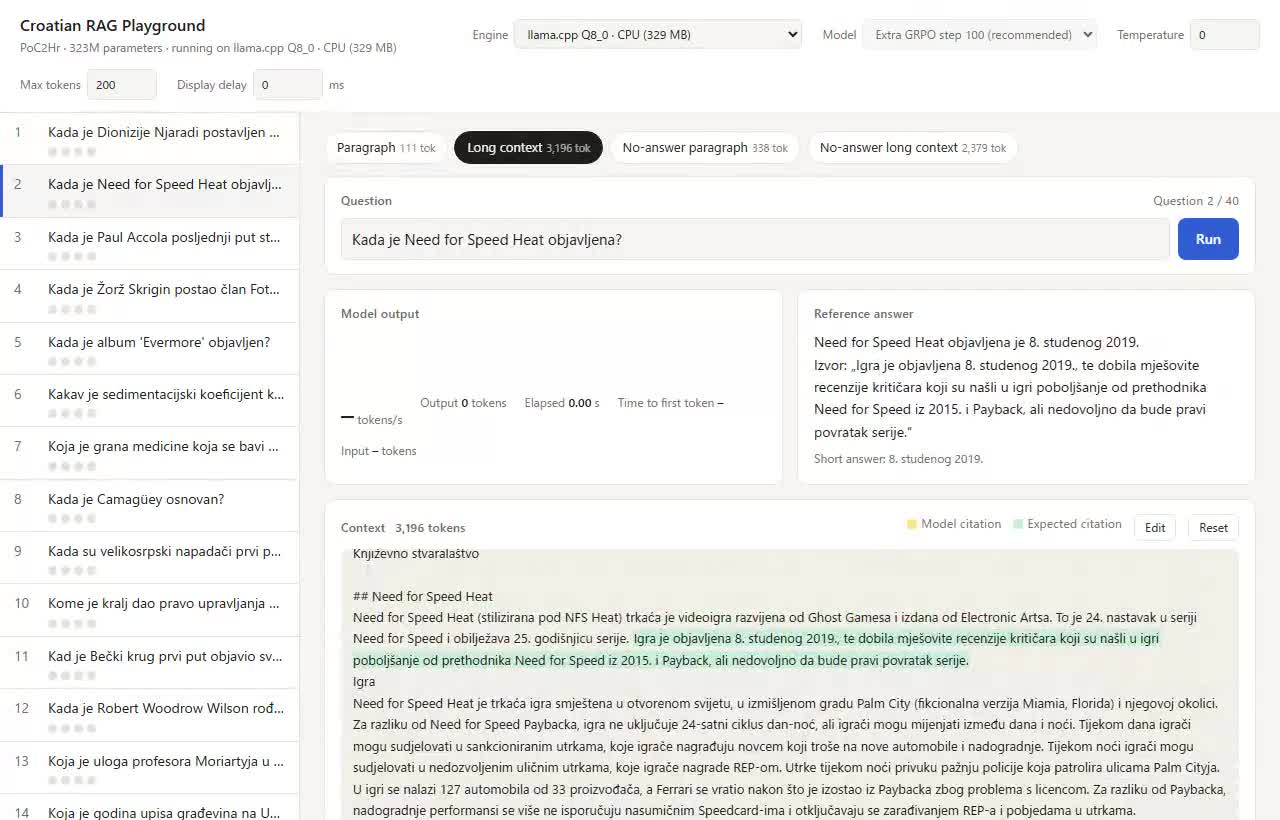
llama.cpp Q6_K (254MB)
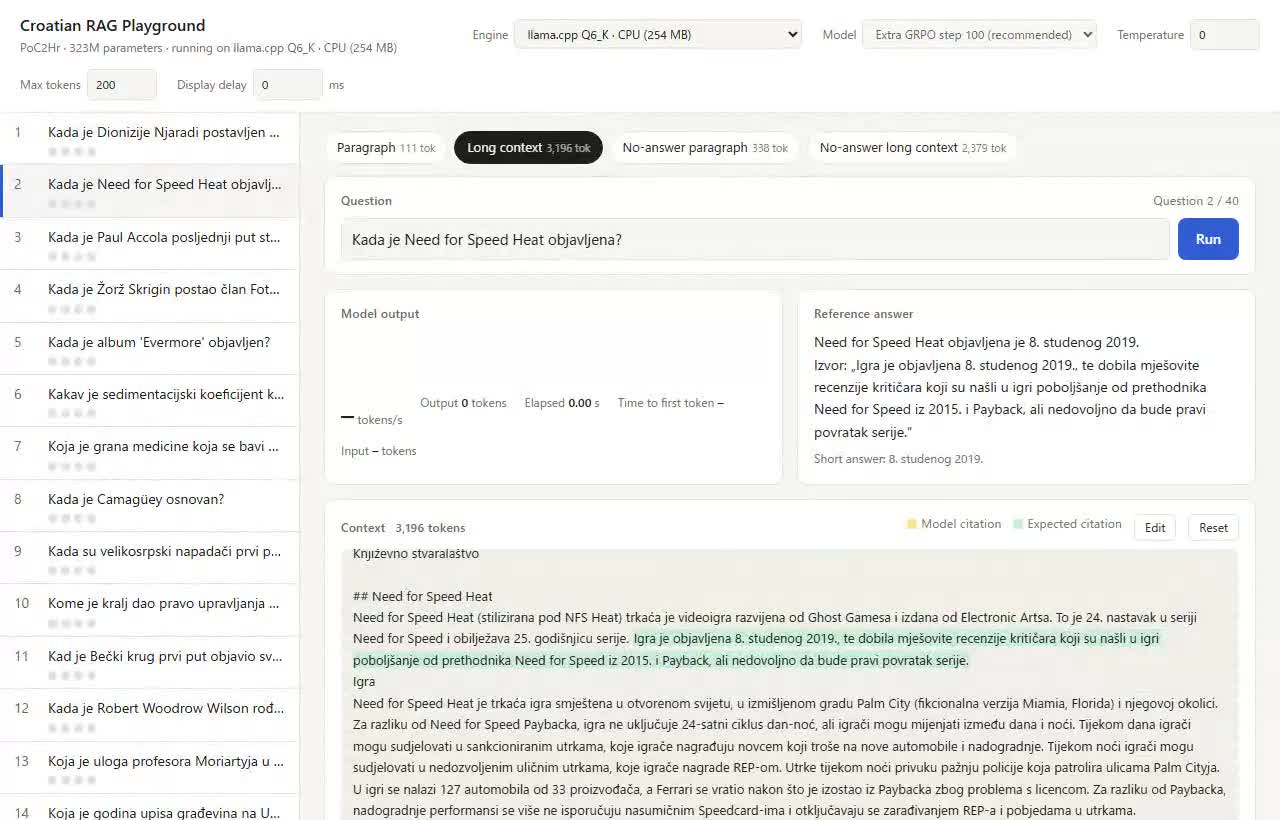
llama.cpp Q5_K_M (223MB)
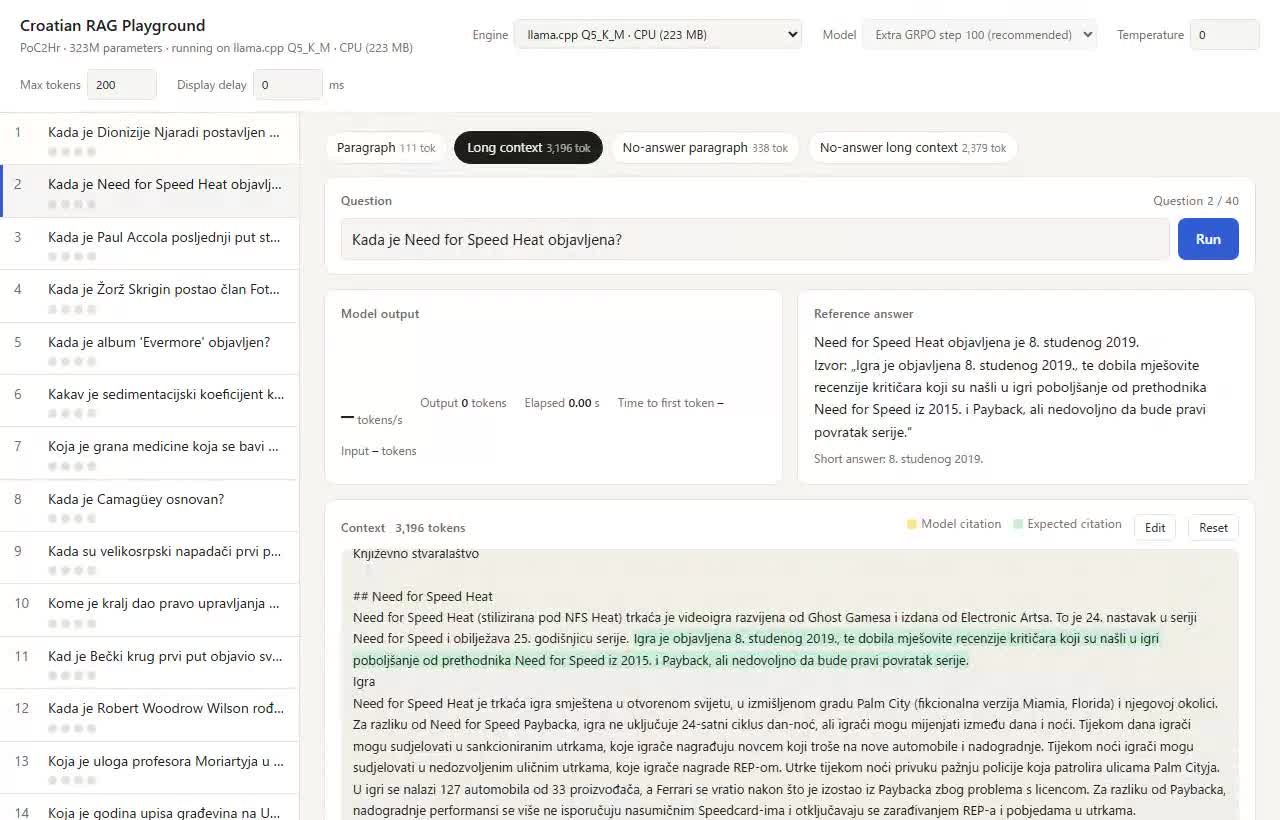
llama.cpp Q4_K_M (193MB)
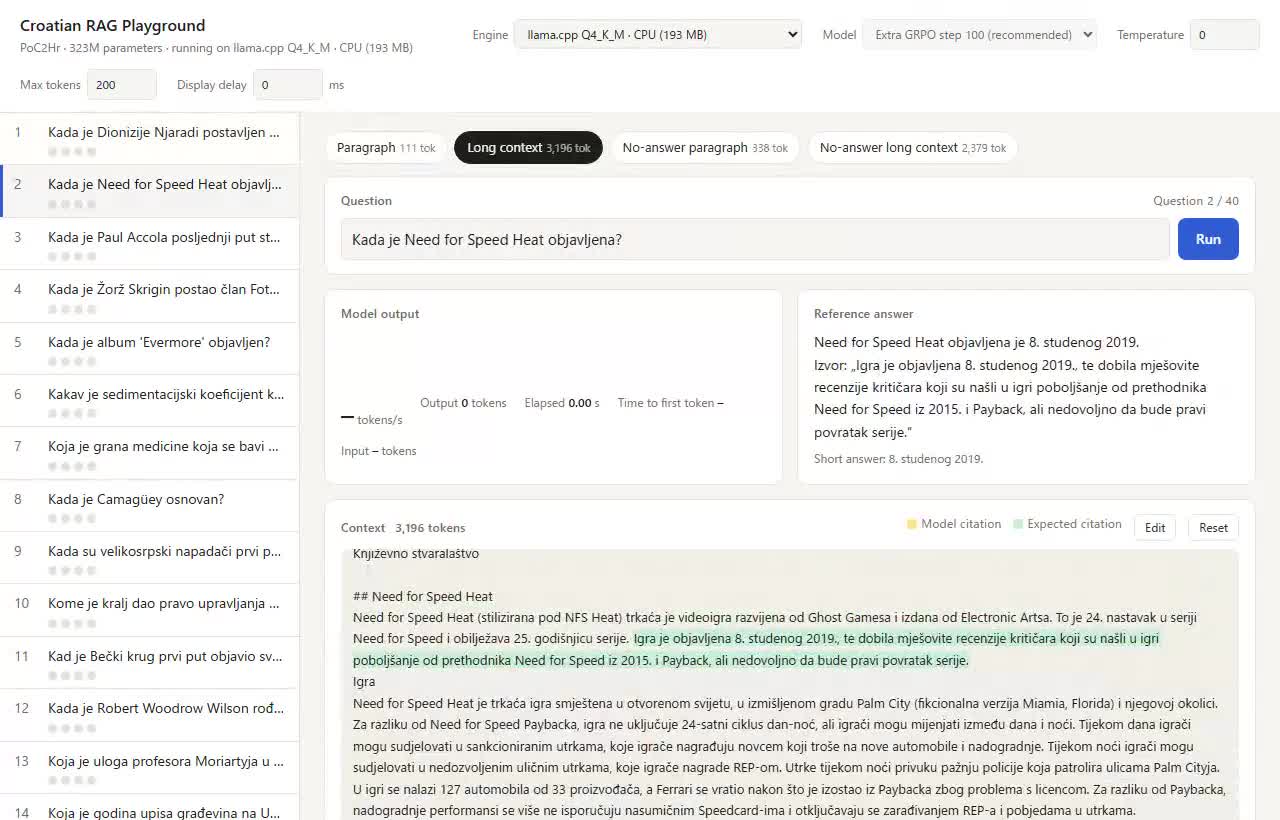
llama.cpp Q3_K_M (160MB)
llama.cpp Q2_K (129MB)
Reflexiones
- Para ejecutar este modelo en CPU, Q6_K. Mantiene la precisión del original, ocupa 1/5 y genera unas 5 veces más rápido que PyTorch. No hay razón para dudar
- Q8_0 si priorizas la tranquilidad. Es casi idéntico al original y ocupa 329 MB. Sigue siendo suficientemente pequeño
- Los modelos pequeños de 300 millones de parámetros son vulnerables a la cuantificación. Se dice que los modelos grandes apenas se degradan incluso con Q4, pero en este caso la caída fue visible desde Q5. Es un modelo que ya tenía poco margen, así que reducirlo le afecta
- Que se rompa en forma de rechazos es de agradecer. Para RAG, rechazar es más seguro que inventar. El efecto de haberle enseñado a rechazar mediante aprendizaje por refuerzo en el artículo anterior también aparece aquí
- En los modelos pequeños, las diferencias de velocidad se estrechan. A partir de Q6_K, aunque la generación sea más rápida, sigue quedando el tiempo de cargar el texto, así que la diferencia percibida apenas cambia. En el vídeo, de Q6_K a Q3_K_M quedaron todos en torno a los 4 segundos
- Sigue sin estar claro por qué Q4_K_M perdió frente a Q3_K_M. Quiero investigarlo con más preguntas y examinando cómo se cuantifica cada capa