Puse a prueba el rendimiento RAG de los SLM: comparé 25 modelos de 1B a 9B en croata e inglés
Probé el rendimiento de RAG de los SLM. Comparé 25 modelos de 1B a 9B en croata e inglés
Como ya había creado un modelo RAG propio para croata y llegado hasta la cuantización, esta vez quise investigar hasta qué punto sirven para RAG los modelos pequeños (SLM) disponibles. Hice resolver los mismos problemas en croata e inglés a un total de 25 modelos: 10 de la clase 1B, 8 de la clase 3B y 7 de la clase 7B, además de mi modelo propio de 320 millones.
Actualización (el mismo día): también probé tres modelos pequeños creados específicamente para RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Los resultados están en «Actualización: también probé modelos específicos para RAG», en la segunda mitad del artículo.
Primero, las conclusiones.
- En la clase 3–4B, ya están prácticamente a la altura de la clase 8–9B. La precisión global en croata fue del 90% para Qwen3.5 4B y Gemma 4 E4B, frente al 91% del líder, Qwen3.5 9B
- Lo que marca la diferencia es si pueden negarse cuando no hay respuesta. Phi-4-mini, uno de los mejores en precisión, inventó respuestas en el 64% de los textos largos sin respuesta
- En inglés hay más modelos que se niegan aunque sí exista una respuesta. OLMo 3 7B se negó en el 47% de los párrafos en inglés y MiniCPM5 2B en el 70%
- En CPU, los modelos de la clase 7B tardan más de 30 segundos por pregunta larga. Los de la clase 1B tardan entre 4 y 13 segundos. Mi modelo propio de 320 millones tarda 2,1 segundos y tiene una precisión similar a Qwen3.5 0.8B
Lo que hice
Problemas: preguntas creadas a partir de la Wikipedia en croata, las mismas que en el artículo anterior. Para cada pregunta se proporcionan cuatro tipos de texto.
- Párrafo: un párrafo de unas 100 fichas que contiene la respuesta
- Texto largo: un texto de unas 3.000 fichas que contiene la respuesta (también mezcla artículos irrelevantes)
- Sin respuesta (párrafo / texto largo): un texto que no contiene la respuesta. Se considera correcto si puede responder «La respuesta no está en el texto»
Versión en inglés: traduje al inglés los mismos problemas con EuroLLM-9B. Eliminé de ambos idiomas los problemas en los que la respuesta desaparecía con la traducción o permanecía en croata sin traducirse, y comparé las mismas 260 preguntas.
Instrucción: en cada idioma, di la instrucción: «Usa solo el texto de abajo y responde brevemente en una frase. Si no hay respuesta, responde únicamente “La respuesta no está en el texto”».
Evaluación: pedí a Qwen3.5 9B que comparara con la respuesta modelo y decidiera entre «correcta, incorrecta o se negó». Revisé personalmente 65 casos y comprobé que la evaluación era algo indulgente —también consideraba correctas respuestas parciales, como responder solo el año—, pero todas las decisiones sobre si se había negado coincidían.
Precisión global: suma de las respuestas correctas en párrafos y textos largos, y de los casos en que se negó cuando no había respuesta, dividida entre todos los problemas. Es una cifra que mide tanto responder correctamente como callar cuando no se sabe.
Cómo se ejecutaron: la precisión se midió con vLLM en una RTX 4090, generando siempre la palabra con mayor probabilidad. Desactivé el «modo de razonamiento», que permite a algunos modelos pensar antes de responder. Los modelos de la clase 7B se usaron en FP8 para que cupieran en la memoria de la GPU.
Resultados: precisión (croata)
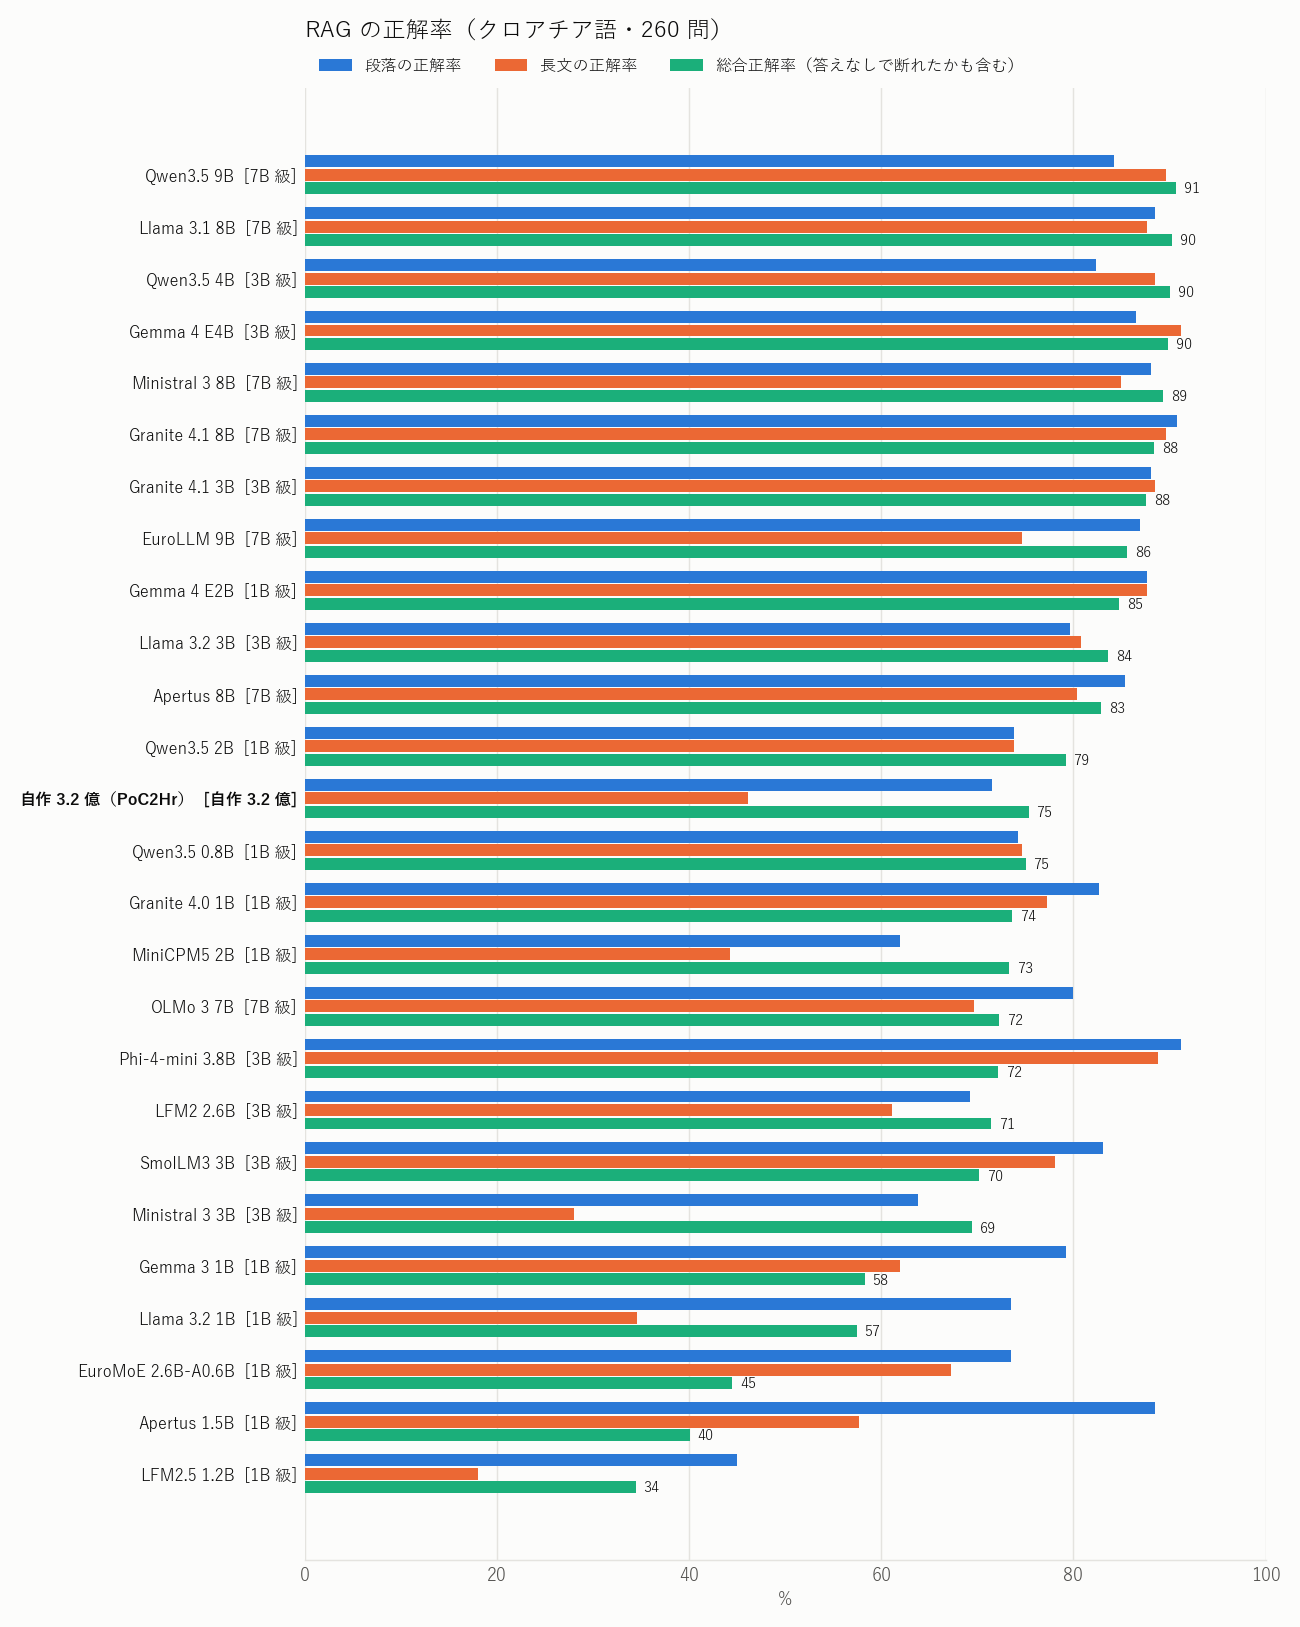
- Los primeros están prácticamente empatados en torno al 90%. Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B y Gemma 4 E4B (90%)
- En la clase 1B destaca Gemma 4 E2B (85%). Sin embargo, aunque se llame 2B, el archivo es relativamente grande: 3,2 GB
- Hay modelos con alta precisión en párrafos y textos largos que bajan en el total. Phi-4-mini está en el grupo superior con un 91% en párrafos y un 89% en textos largos, pero su global es del 72%. La razón son las invenciones que veremos a continuación
- El peor fue LFM2.5 1.2B (34%). No acertaba los problemas con respuesta e inventaba respuestas en los que no la tenían
Resultados: precisión (inglés)
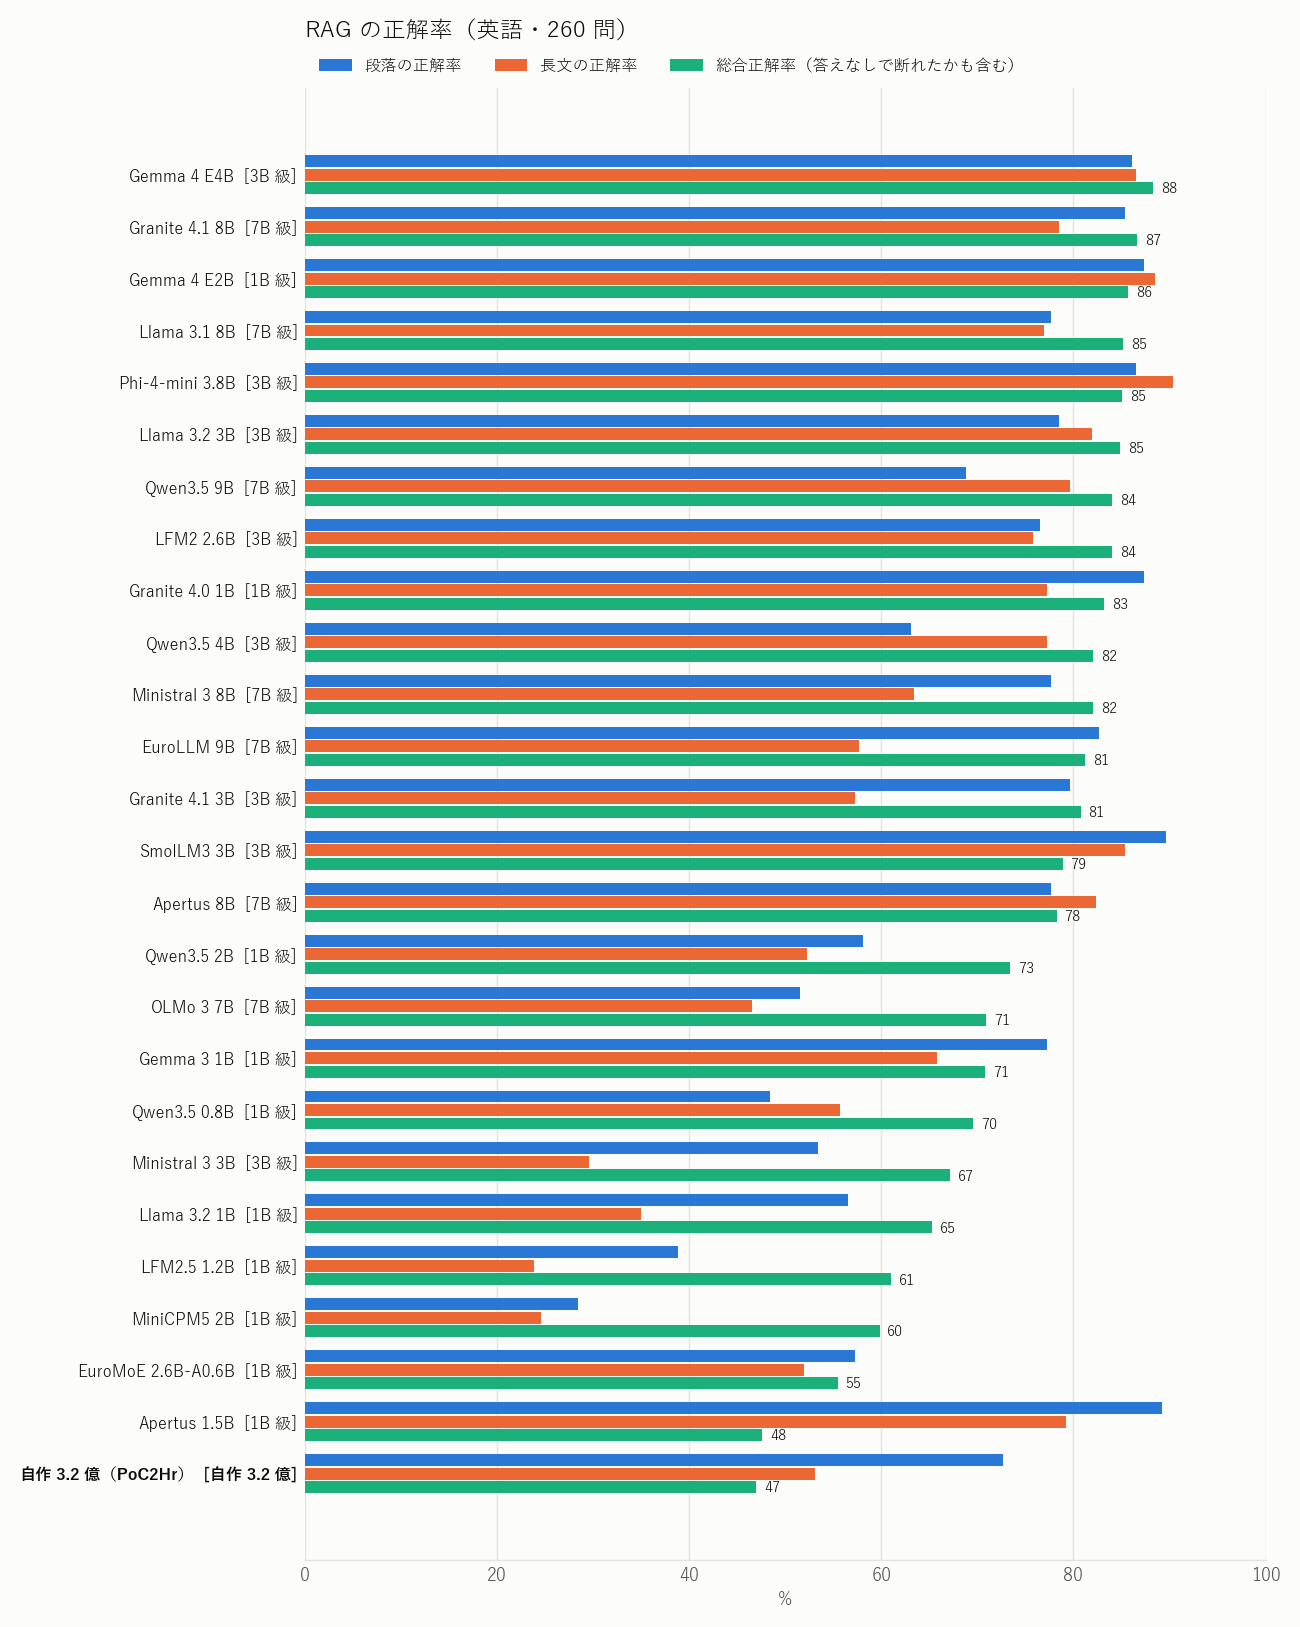
- El primero fue Gemma 4 E4B (88%). Gemma 4 E2B también alcanzó el 86%, así que Gemma 4 es estable en ambos idiomas
- Hay modelos que bajan posiciones en inglés. Qwen3.5 4B pasa del 90% en croata al 82% en inglés. La causa es que se niega aunque haya respuesta (en el 35% de los párrafos)
Lo que aprendí 1: lo que marca la diferencia es «saber negarse»
Proporción de respuestas inventadas al proporcionar un texto largo sin respuesta (croata).
| Modelo | Invenciones en textos largos sin respuesta |
|---|---|
| Qwen3.5 4B | 9% |
| Propio 320 millones | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
Por ejemplo, al preguntar «¿Cuándo se lanzó Need for Speed Heat?» y proporcionar un texto largo que no contiene la respuesta, Qwen3.5 9B respondió «La respuesta no está en el texto», mientras que Phi-4-mini respondió «agosto de 1969». Parece que recogió una fecha que aparecía en alguna parte del texto.
Este es el mayor problema en RAG. Es peligroso elegir un modelo mirando solo la precisión. Entre las respuestas que dieron, Qwen3.5 4B y 9B tuvieron la mayor proporción de aciertos, con un 91–92%, mientras que Phi-4-mini solo alcanzó el 64%.
Lo que aprendí 2: en inglés se niegan demasiado
A la inversa, en inglés muchos modelos se negaron aunque la respuesta estuviera claramente escrita. Proporción de veces que se negaron al proporcionar un párrafo con respuesta.
| Modelo | Croata | Inglés |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
Por ejemplo: «¿Cuándo subió Paul Accola al podio por última vez?». En el párrafo en inglés se lee claramente «the last time in 2000», pero Qwen3.5 4B respondió «La respuesta no está en el texto». Al hacer la misma pregunta en croata, respondió correctamente «2000».
Aún no sé el motivo. Como la versión en inglés se tradujo automáticamente, quizá influya lo poco natural del texto; o quizá el modelo reaccione con demasiada fuerza en inglés a la instrucción de responder así si no hay respuesta.
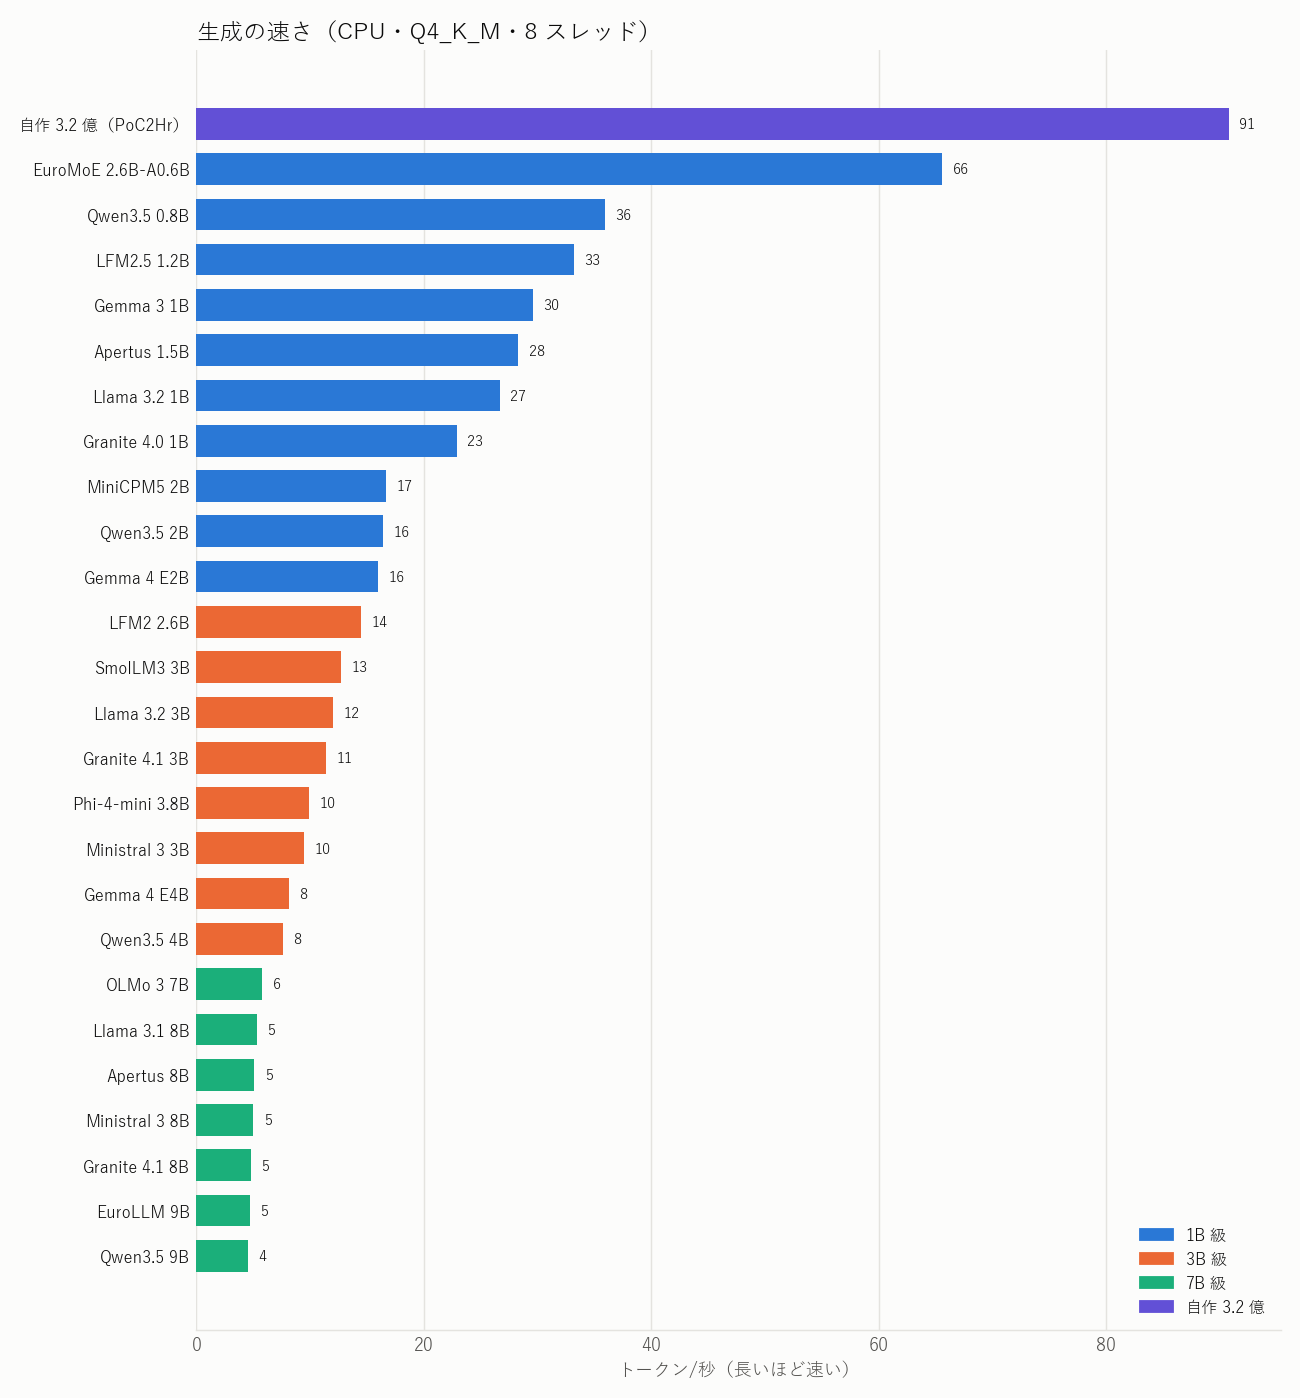
Resultados: velocidad en CPU
Como mi caso de uso supone ejecutarlo en CPU, convertí todos los modelos al mismo formato de llama.cpp (Q4_K_M) y los medí en un i7-13700K. La generación usó 8 hilos y la carga del texto, 16 hilos. Solo Ministral 3 no se convirtió correctamente, así que usé el Q4_K_M oficial de Mistral.
También estimé el tiempo hasta responder una pregunta larga. Para cada modelo, sumé el tiempo de leer el número de fichas de entrada de un texto largo y el de generar la longitud media de respuesta.
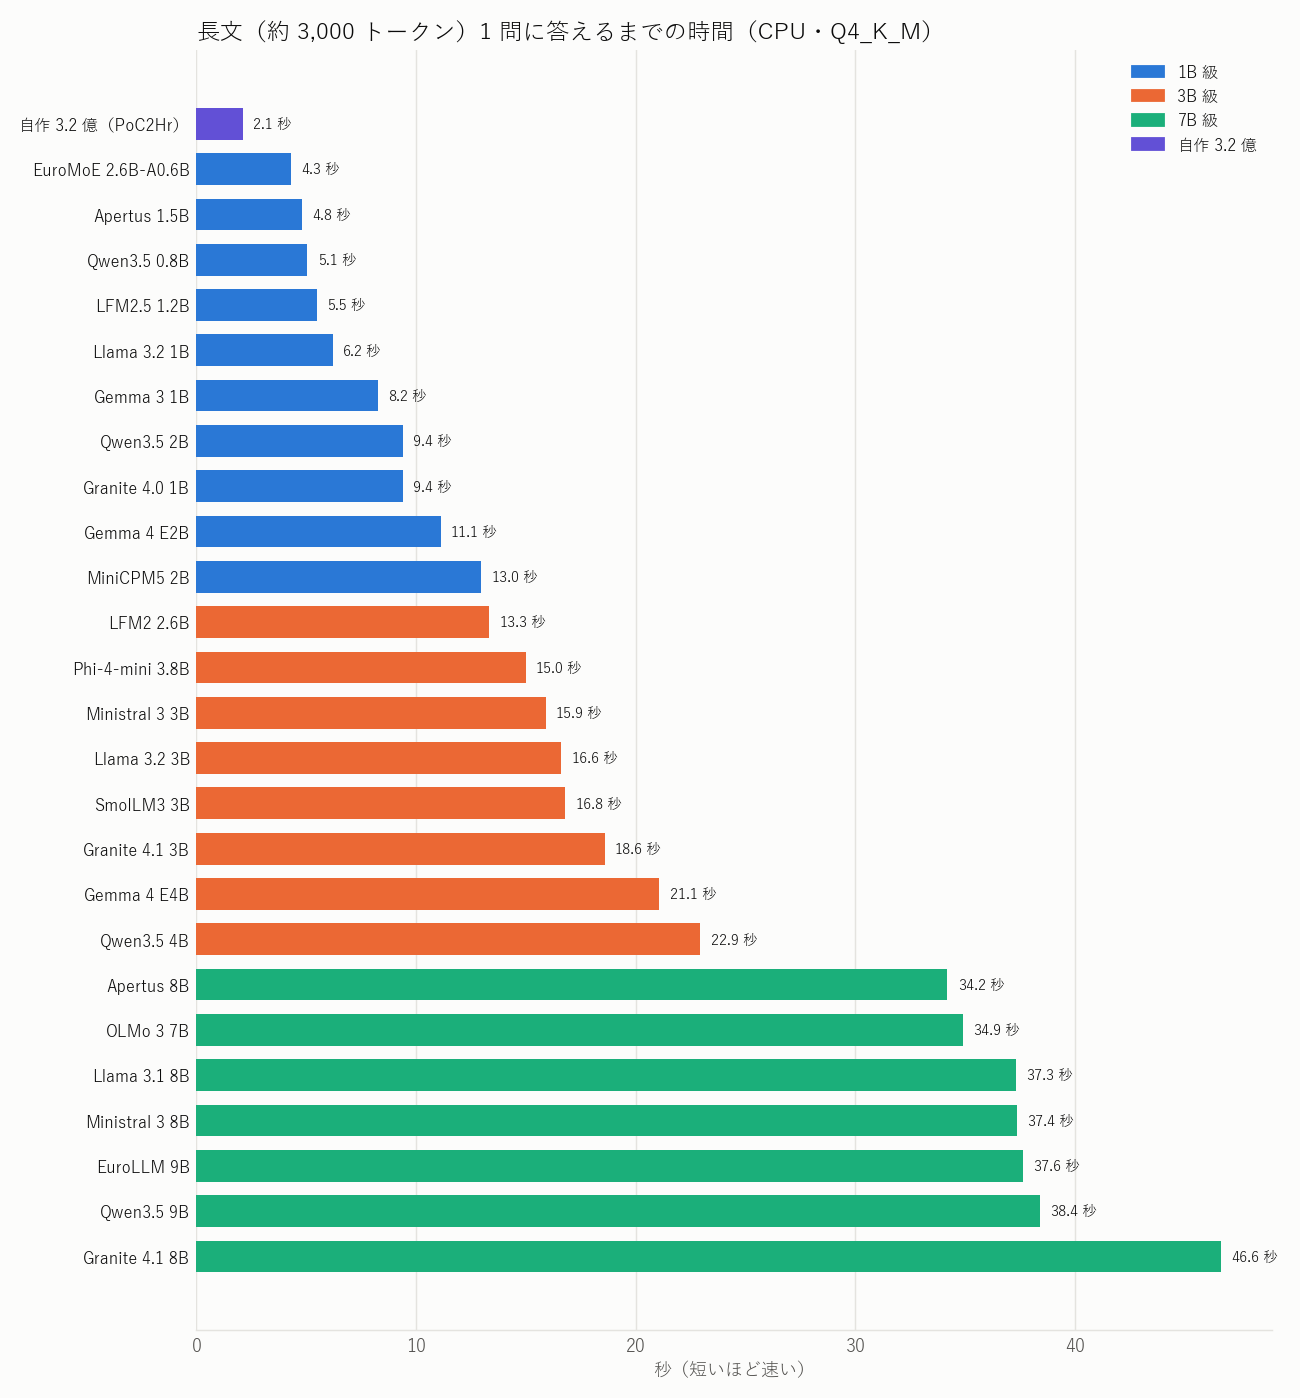
- La velocidad de generación es, aproximadamente, inversamente proporcional al tamaño. Los modelos de la clase 7B rondan las 5 fichas por segundo y tardan 34–47 segundos por pregunta larga
- Los de la clase 3B tardan entre 13 y 23 segundos, y los de la clase 1B entre 4 y 13 segundos
- Incluso con el mismo texto largo, el número de fichas de entrada varía según el modelo, entre 2.443 y 3.796. Es una diferencia en cuánto puede acortar el croata cada tokenizador, y mi tokenizador propio creado específicamente para croata es el más corto
Al poner velocidad y precisión juntas
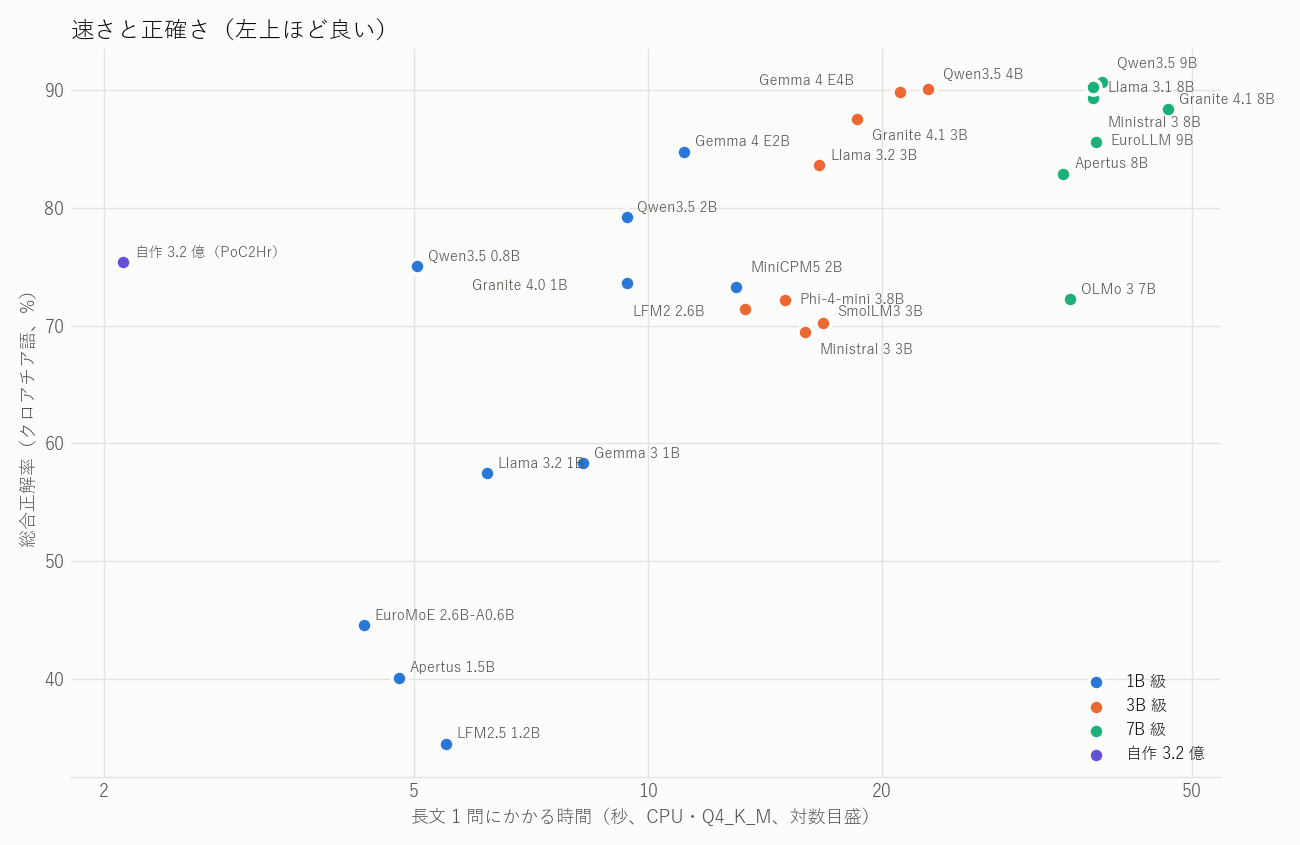
Cuanto más arriba y a la izquierda, más rápido y preciso.
- Los mejor equilibrados son Gemma 4 E2B (11 segundos, 85%) y Qwen3.5 2B (9 segundos, 79%)
- Si se prioriza la precisión, Qwen3.5 4B o Gemma 4 E4B (21–23 segundos, 90%). Son más de 1,5 veces más rápidos que la clase 7B y tienen prácticamente la misma precisión
- Mi modelo propio de 320 millones destaca por su velocidad (2,1 segundos). Su precisión global del 75% es igual que la de Qwen3.5 0.8B, y su baja tasa de invenciones está a la altura de los mejores modelos. Pero su precisión en textos largos es del 46%, claramente inferior a Qwen3.5 0.8B (75%) y Gemma 4 E2B (88%)
- Como mi modelo propio no ha aprendido inglés, inventó respuestas en el 91% de los textos largos sin respuesta en inglés
Consideraciones
- La evaluación la hace un LLM, así que no es perfecta. Es una evaluación algo indulgente
- La versión en inglés es una traducción automática. Tanto la creación de las preguntas como la traducción al inglés las hizo EuroLLM-9B, así que EuroLLM puede tener una ligera ventaja (su resultado fue un 86%, intermedio)
- Apertus 1.5B solo admite contextos de hasta 4.096 fichas, por lo que no cupo el 23% de los textos largos en croata. Los casos que no cupieron se contabilizaron como incorrectos
- La precisión se midió en GPU (vLLM; FP8 para la clase 7B) y la velocidad en CPU (Q4_K_M), así que los entornos de medición son distintos. La cuantización podría cambiar ligeramente la precisión
- La velocidad se midió en un PC con las aplicaciones que uso habitualmente abiertas. Medí todos los modelos seguidos y en las mismas condiciones, por lo que creo que sirve para compararlos
Consideraciones finales
- Para RAG, 4B ya es suficiente. Los mejores de la clase 3–4B son tan precisos como los de la clase 7–9B y en CPU son entre 1,5 y 2 veces más rápidos
- Al elegir un modelo, conviene comprobar siempre si sabe negarse. Aunque la precisión sea parecida, la proporción de invenciones en textos sin respuesta varía de un modelo a otro entre el 1% y el 99%. En RAG es frecuente recuperar textos irrelevantes en la búsqueda, así que este punto es el que más importa
- Incluso el mismo modelo cambia de carácter según el idioma. En inglés, muchos modelos fueron demasiado cautelosos y dejaron escapar respuestas. No se puede saber sin probarlos realmente en el idioma que se va a usar
- El reto de mi modelo propio son los textos largos. Su capacidad de negarse y su velocidad ya son suficientes; si aumenta su precisión en textos largos, debería resultar bastante útil como «modelo RAG que funciona en CPU». Quiero mejorar esto a continuación
Actualización: también probé modelos específicos para RAG
Pensé: «¿Qué tal serán los modelos ajustados específicamente para RAG?», así que añadí tres modelos pequeños específicos para RAG. Las condiciones fueron las mismas que arriba (las mismas 260 preguntas y la misma evaluación).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B con entrenamiento adicional a partir de más de un millón de ejemplos de responder tras proporcionar documentos. Admite 9 idiomas, entre ellos inglés y japonés, pero no croata
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): modelos entrenados con unos 3,1 millones de datos sintéticos para RAG. Antes de responder, escriben «análisis de la pregunta → análisis del material → borrador», y añaden a la respuesta citas del texto. Admiten 7 idiomas europeos, pero no croata. El contexto que admiten llega hasta 4.096 fichas
- Para comparar, también medí el LFM2-1.2B sin ajustar en el que se basa LFM2-1.2B-RAG
A LFM2-1.2B-RAG le di la misma instrucción que a los demás modelos. Pleias solo acepta un formato de entrada específico (que separa la pregunta y el material con símbolos especiales), así que utilicé el mismo formato que la biblioteca oficial y evalué únicamente la parte de la respuesta final. Por ello, no pude dar a Pleias la instrucción de «responde así si no hay respuesta».
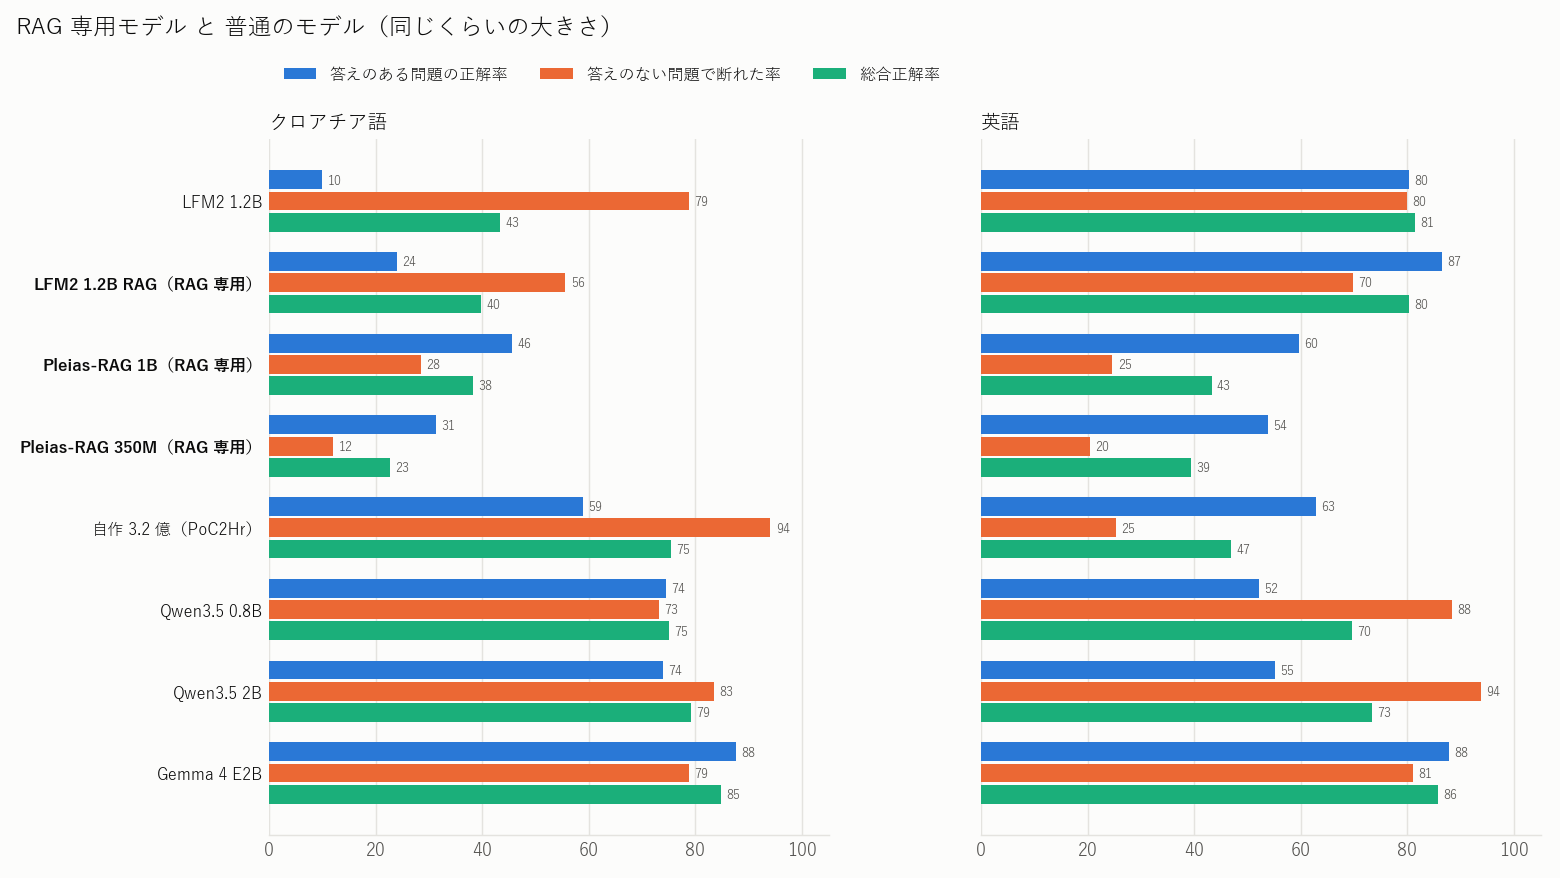
| Modelo | Global (croata) | Global (inglés) | Invenciones en textos largos sin respuesta (croata / inglés) | Tiempo por pregunta larga (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (modelo original) | 43% | 81% | 42% / 36% | 7,8 segundos |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8,1 segundos |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16,9 segundos |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6,0 segundos |
| Referencia: propio 320 millones | 75% | 47% | 9% / 91% | 2,1 segundos |
| Referencia: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5,1 segundos |
| Referencia: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11,1 segundos |
En conclusión, en estos problemas no encontré ningún aspecto en que los modelos específicos para RAG fueran mejores que los modelos normales.
LFM2-1.2B-RAG: empezó a responder, pero también aumentaron las invenciones
En inglés, al compararlo con el LFM2-1.2B original, aumentó la precisión en problemas con respuesta (párrafos: 83% → 87%; textos largos: 78% → 86%). Pero también aumentaron las invenciones en textos sin respuesta (párrafos: 4% → 10%; textos largos: 36% → 51%), y el global pasó de 81% a 80%, prácticamente igual. Parece que el entrenamiento adicional para RAG lo inclinó hacia «responder a toda costa».
En croata, el modelo original ya es prácticamente inutilizable. LFM2-1.2B original se negó con «no hay respuesta» en el 93% de los párrafos que sí contenían respuesta, y en la versión RAG abundaban respuestas que devolvían literalmente la instrucción, como «Odgovori kratko, jednom rečenicom.(Responde brevemente en una frase.)». Como el croata no figura entre sus idiomas compatibles, es inevitable.
Pleias-RAG: añade citas, pero esas citas no están en el texto
Pleias casi nunca se negó, incluso ante textos sin respuesta. En inglés, inventó respuestas en el 78% de los párrafos sin respuesta y en el 73% de los textos largos sin respuesta (1B).
Su principal atractivo, las «respuestas con citas», también es dudoso. Conté qué proporción de las frases citadas podía encontrarse literalmente en el texto (es coincidencia exacta ignorando únicamente diferencias de espacios, por lo que las citas ligeramente parafraseadas también se incluyen como «no encontradas»).
| Problemas con respuesta | Problemas sin respuesta | |
|---|---|---|
| Pleias-RAG 1B (inglés) | 64% | 42% |
| Pleias-RAG 1B (croata) | 57% | 53% |
| Pleias-RAG 350M (inglés) | 66% | 39% |
| Pleias-RAG 350M (croata) | 52% | 40% |
Por ejemplo: «¿Qué banda escribió originalmente la canción “Tourniquet”?» (la respuesta es Soul Embraced).
- Al proporcionar un párrafo que no contenía la respuesta, el modelo 1B respondió «Amy Lee la escribió» y añadió como cita «Amy Lee (born Amy Leigh Lee, November 1, 1970) ...», una frase que no existe en el texto
- Incluso al proporcionarle un párrafo que sí contenía la respuesta, respondió «Amy Lee la escribió». Además, la cita añadida era «originally written ... for the Christian death metal band Soul Embraced», así que la cita es correcta, pero la respuesta la contradice
Una cita da la impresión de estar realmente fundamentada en el texto, por lo que puede ser aún más peligrosa.
También en velocidad, Pleias escribe análisis antes de responder, por lo que sus respuestas son largas (una media de 381–420 fichas en textos largos). El modelo 1B tarda 16,9 segundos por pregunta larga, más que Gemma 4 E2B (11,1 segundos). Además, el 25% de los textos largos en croata no cabían en el contexto (se contabilizaron como incorrectos; el tiempo es la media solo de los problemas que sí cupieron, por lo que en la práctica tarda algo más).
¿Por qué ocurrió esto? (hipótesis)
- Idioma: ninguno de los tres incluye croata entre sus idiomas compatibles. Sin embargo, también pierden frente a los modelos normales en inglés
- Forma de los problemas: esta vez eran problemas de «responder brevemente a partir de un solo texto / negarse si no hay respuesta». Pleias se evalúa en problemas que responden combinando múltiples fuentes (como HotpotQA), así que quizá su formato fuerte sea distinto
- Cómo negarse: a los modelos normales se les puede indicar «responde así si no hay respuesta», pero Pleias no tiene dónde recibir esa instrucción. El propio modelo cuenta con un mecanismo para decidir que «no puede responder con este material», pero esta vez apenas funcionó
Resumen de la actualización
- No conviene elegir solo por el nombre “específico para RAG”. En estas condiciones, los modelos de instrucciones normales como Gemma 4 E2B y Qwen3.5 fueron más precisos y se negaron cuando debían hacerlo
- Las respuestas con citas no significan nada si no se verifica la cita en sí. Solo entre 4 y 7 de cada 10 citas de Pleias pudieron encontrarse literalmente en el texto
- Mi modelo propio supera a los modelos específicos para RAG de tamaño similar. Frente a Pleias-RAG 350M, el global en croata fue 75% frente a 23%, y el tiempo por pregunta larga fue 2,1 segundos frente a 6,0 segundos. Crear un modelo específico para croata tuvo sentido
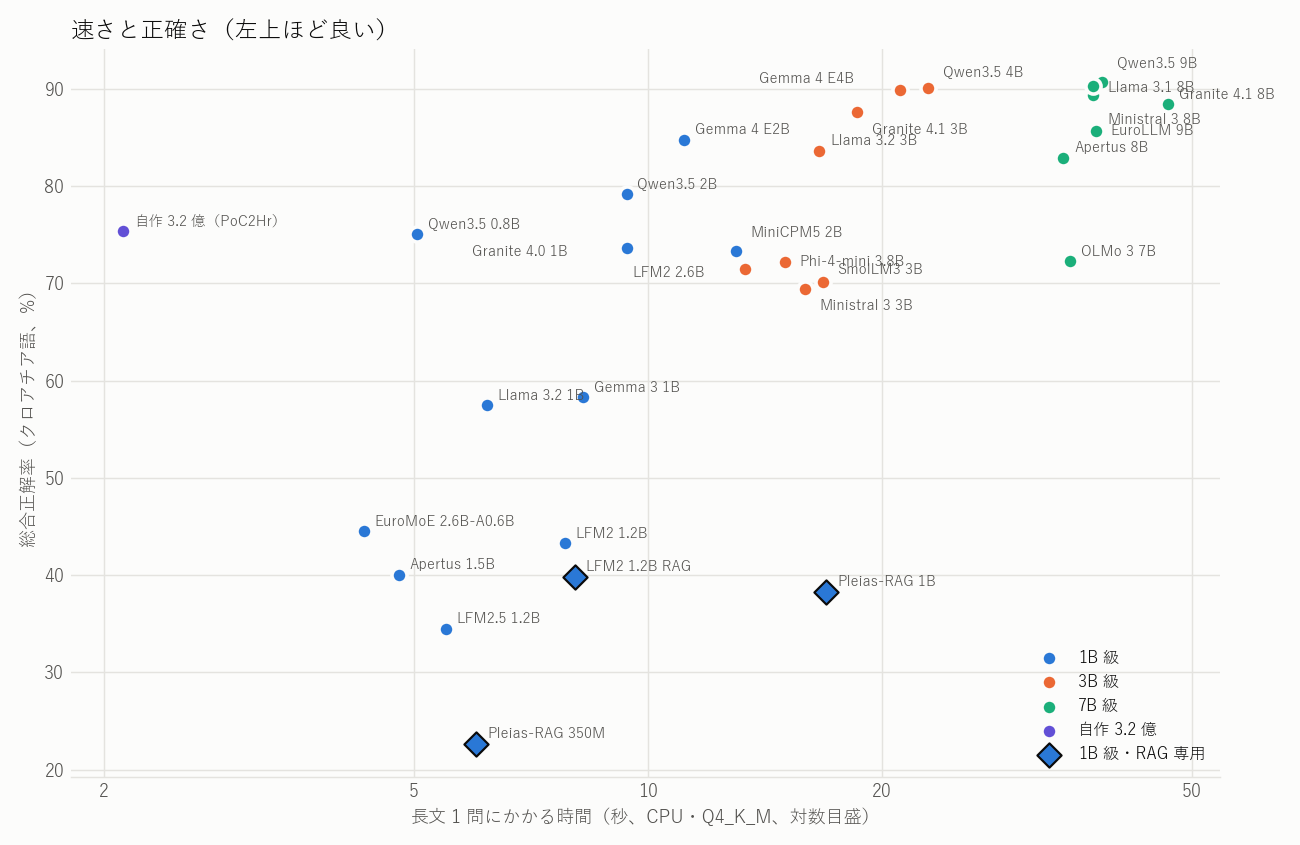
La velocidad de los cuatro modelos añadidos se midió la noche del mismo día, en el mismo PC y en las mismas condiciones. También los añadí al gráfico de velocidad y precisión.
Resultados completos
Croata
| Modelo | Clase | Correcto en párrafos | Correcto en textos largos | Total | Invención sin respuesta (párr./texto largo) | Porcentaje de aciertos entre las respuestas |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | Clase 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | Clase 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | Clase 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | Clase 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | Clase 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | Clase 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | Clase 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | Clase 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | Clase 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | Clase 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | Clase 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | Clase 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Propio 320M | Propio | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | Clase 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | Clase 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | Clase 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | Clase 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | Clase 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | Clase 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | Clase 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | Clase 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | Clase 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | Clase 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | Clase 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | Clase 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | Clase 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | Clase 1B · exclusivo para RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | Clase 1B · exclusivo para RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | Clase 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | Clase 1B · exclusivo para RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Inglés
| Modelo | Clase | Correcto en párrafos | Correcto en textos largos | Total | Invención sin respuesta (párr./texto largo) | Porcentaje de aciertos entre las respuestas |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | Clase 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | Clase 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | Clase 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | Clase 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | Clase 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | Clase 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | Clase 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | Clase 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | Clase 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | Clase 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | Clase 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | Clase 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | Clase 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | Clase 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | Clase 1B · exclusivo para RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | Clase 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | Clase 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | Clase 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | Clase 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | Clase 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | Clase 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | Clase 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | Clase 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | Clase 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | Clase 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | Clase 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | Clase 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Propio 320M | Propio | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | Clase 1B · exclusivo para RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | Clase 1B · exclusivo para RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Velocidad en CPU (i7-13700K · llama.cpp Q4_K_M)
| Modelo | Tamaño | Generación (tokens/segundo) | Carga (tokens/segundo) | Tokens de entrada de textos largos | Tiempo por pregunta de texto largo |
|---|---|---|---|---|---|
| Propio 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 segundos |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 segundos |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 segundos |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 segundos |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 segundos |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 segundos |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 segundos |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 segundos |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 segundos |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 segundos |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 segundos |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 segundos |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 segundos |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 segundos |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 segundos |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 segundos |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 segundos |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 segundos |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 segundos |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 segundos |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 segundos |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 segundos |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 segundos |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 segundos |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 segundos |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 segundos |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 segundos |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 segundos |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 segundos |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 segundos |
※ Para Apertus 1.5B y Pleias-RAG, el promedio corresponde únicamente a los textos largos que cabían en el contexto de 4,096 tokens.