Entrené GPT-2 desde cero con una sola RTX 4090. Superó al original en un día y además consiguió chatear
Probé a entrenar GPT-2 (124M) desde cero con una sola RTX 4090 en casa. Hice todo en mi propio PC: desde preparar los datos y el preentrenamiento hasta el ajuste de instrucciones (SFT) para que pudiera conversar.
La conclusión, por adelantado, es esta:
- El preentrenamiento terminó en unas 21 horas. Alcanzó un 30,5 % en HellaSwag, una prueba de razonamiento de sentido común. Superó el 29,4 % del GPT-2 124M original.
- El SFT duró algo menos de dos horas. Apenas cinco minutos después de empezar a entrenar, ya daba respuestas que parecían una conversación.
- Eso sí, estaba lleno de alucinaciones. Decía sin problema cosas como «París tiene 2.400 millones de habitantes» o «12+7=30».
Me resultó muy interesante ver cómo GPT-2 se iba volviendo más inteligente, así que he recopilado el proceso.
Entorno
- GPU: RTX 4090 (24 GB)
- CPU: i7-13700K / 64 GB de memoria
- SO: Windows 11 (sin WSL; directamente en Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
El código sigue el mismo enfoque que nanoGPT/build-nanogpt de Karpathy. Le pedí a Claude Code que hiciera «un GPT-2 que este PC pudiera entrenar en un día con su GPU», y me ayudó con todo: desde la propuesta de estructura y la creación de scripts hasta la supervisión del entrenamiento.
Preparación de datos: 10B tokens listos en 12 minutos
Los datos de entrenamiento fueron la versión de 10B tokens de FineWeb-Edu (texto web en inglés de alta calidad y orientado a la educación). Ocupa unos 27 GB en parquet.
Al principio, la descarga estándar de Hugging Face iba a solo 1,7 MB/s, así que el cálculo era que tardaría más de cuatro horas en bajarlo todo. Al instalar hf_transfer, subió a 60–70 MB/s: un archivo de 2 GB se descarga en 30 segundos. El cuello de botella pasó a ser la tokenización y, entre descarga y tokenización, todo estuvo listo en unos 12 minutos.
Por cierto, al principio puse HF_HOME, que cambia la ubicación de la caché, después del import de huggingface_hub. Como consecuencia, la configuración no surtía efecto y los datos se descargaban en otra unidad. Esta variable de entorno se lee al importar, así que hay que configurarla antes del import. Es un detalle fácil de pasar por alto.
Configuración del entrenamiento
| Elemento | Contenido |
|---|---|
| Modelo | GPT-2 small (12 capas, dimensión 768; 124 millones de parámetros) |
| 1 paso | Unos 520.000 tokens (16×1024 con acumulación de gradiente 32 veces) |
| Número de pasos | 16.000 (unos 8,4B tokens) |
| Velocidad | Unos 120.000 tokens/segundo |
| VRAM | Unos 12 GB |
A menudo se dice que en Windows torch.compile no funciona y que hay que usar WSL, pero en este entorno con triton-windows funcionó directamente.
Con los 10B tokens completos se superaban las 24 horas, así que lo reduje a 8,4B tokens para que cupiera en un día.
Como pequeño truco, redondeé el tamaño del vocabulario de 50257 a 50304 (múltiplo de 128). Es una conocida técnica de Karpathy que acelera las operaciones matriciales de la GPU, y luego resultó útil de una forma inesperada al convertirlo en chatbot.
Incidente: el entrenamiento se detuvo a las 2,5 horas
Al revisar el progreso, vi que el entrenamiento se había parado. La causa eran los datos de evaluación de HellaSwag. El código tipo nanoGPT descarga los datos desde rowanz/hellaswag en GitHub, pero ese repositorio había pasado a mostrar «451 Unavailable For Legal Reasons» (retirado por razones legales). El error 404 hizo que el entrenamiento se cayera junto con la evaluación.
Lo corregí para leer desde Rowan/hellaswag en Hugging Face (las mismas 10.042 preguntas), y reanudé desde un checkpoint que guardaba cada 500 pasos. Además, envolví la evaluación con try/except para que el entrenamiento no se detuviera aunque fallara.
En entrenamientos largos, no hay que dejar que un fallo de algo «ajeno al núcleo», como la evaluación o los logs, derribe el entrenamiento. Esto es importante.
Resultado: superó al GPT-2 original
La loss en los datos de validación fue así. Cayó rápidamente durante la primera hora y después siguió bajando poco a poco.
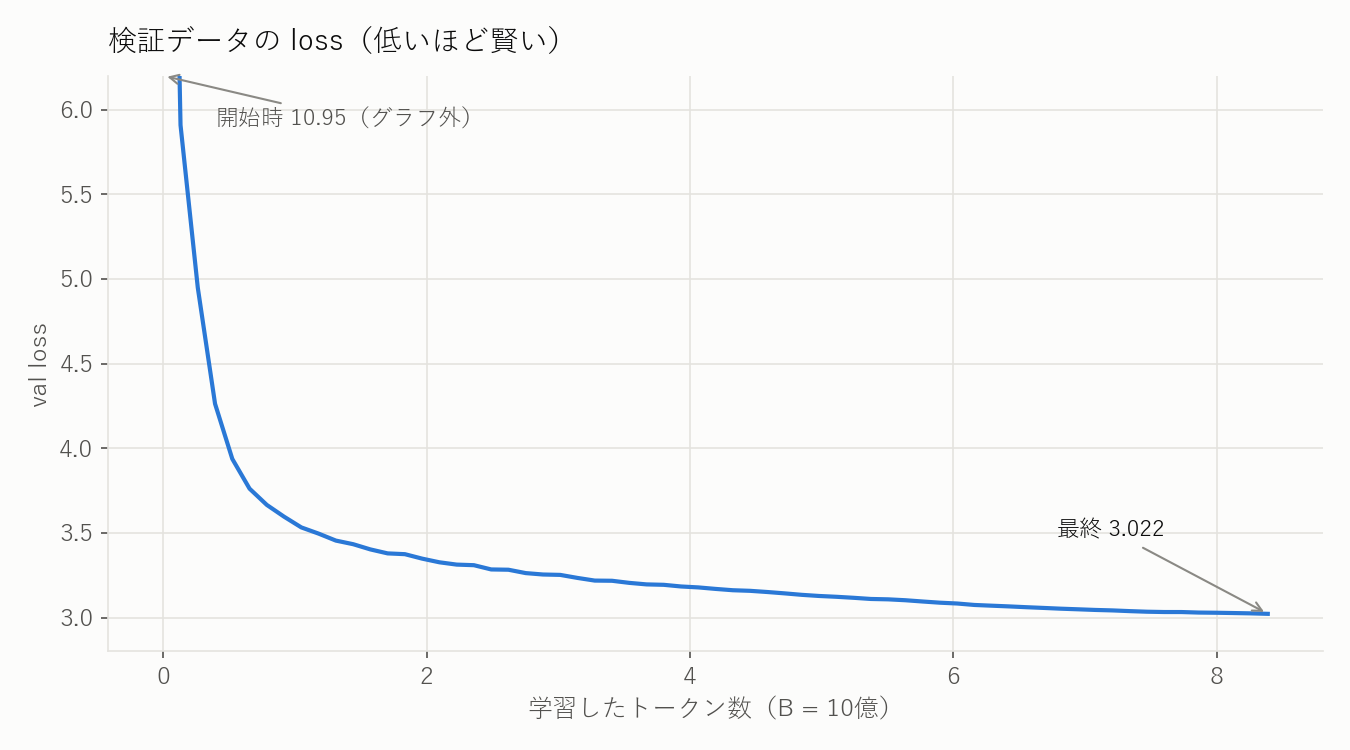
La loss inicial de 10,95 es casi igual a ln(50304)≒10,83. Es decir, empezó en un estado en el que elegía completamente al azar entre unas 50.000 palabras.
La precisión de HellaSwag fue la siguiente.
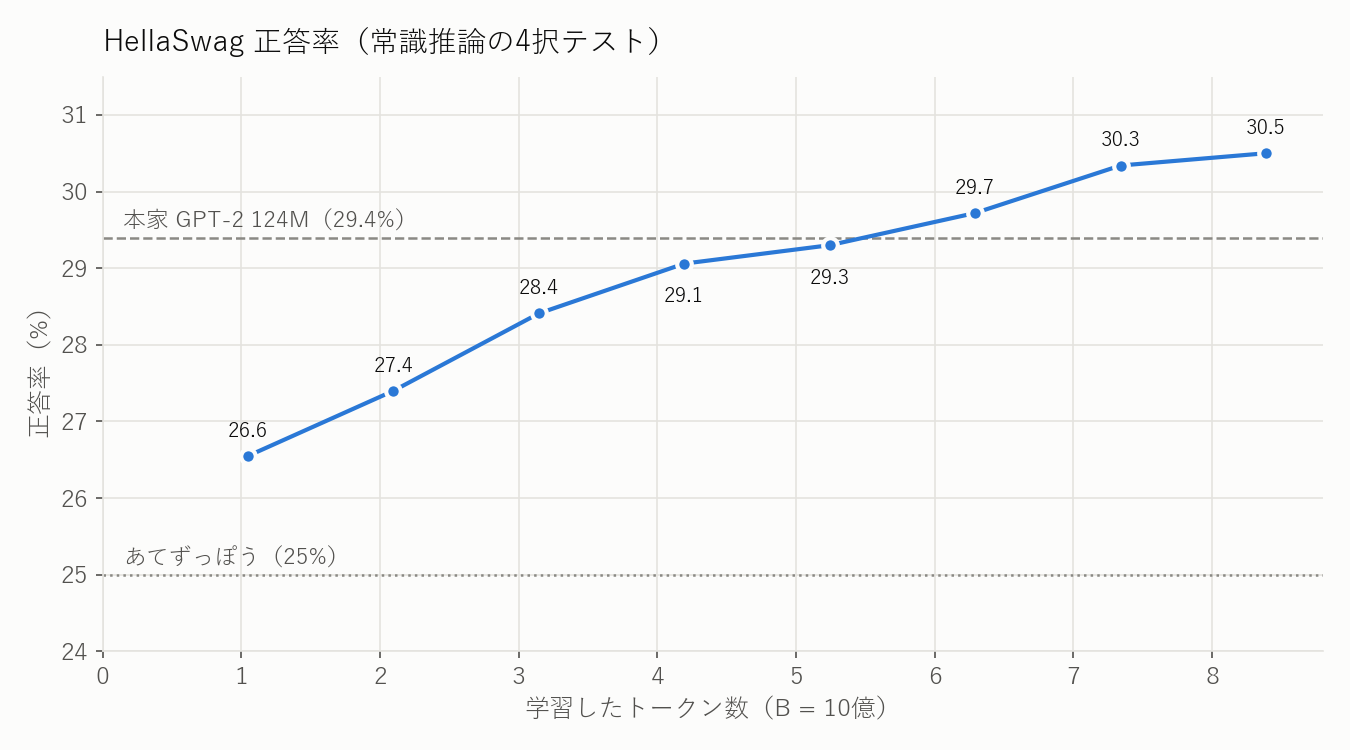
Con unos 6,3B tokens (paso 12.000) superó el 29,4 % del GPT-2 124M original, y terminó en 30,5 %. El GPT-2 original se entrenó con WebText. Este utilizó FineWeb-Edu, y creo que ayudó usar datos educativos de mayor calidad.
Cómo se fue volviendo más inteligente
Durante el entrenamiento, generaba y guardaba texto cada hora con el mismo prompt. Esta fue la parte más interesante.
Antes de entrenar (estado aleatorio)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Las palabras están simplemente ordenadas al azar.
37 minutos después (0,26B tokens)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Ya tiene forma de frase. Entiende que se habla de una «capital», pero dice que la capital de Francia es la capital de Escocia.
Unas dos horas después (0,79B tokens)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
La gramática ya es bastante natural. A cambio, empezó a encadenar términos técnicos y a inventarse mentiras plausibles. Parece el prototipo de una alucinación.
Unos 2,1B tokens
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
¡Por fin pudo decir Paris!… Pero inmediatamente añade la falsa estadística de que «Francia produce el 50 % del acero mundial».
Probé a hacer preguntas al modelo base terminado
Le hice diez preguntas en el formato Question: ... Answer:.
- What is the capital of France? → Enumera opciones de la (a) a la (i) y empieza a crear un cuestionario.
- Who was Albert Einstein? → «Nació el 16 de noviembre de 1918 en St. Louis, Misuri. Su padre era minero y él era maestro de escuela». Todo es falso, pero sabe escribir con estilo biográfico.
- What is 12 plus 7? → «12 plus 7 is an arithmetic expression.». En vez de calcular, empieza a explicar la definición.
Tiene ciertos conocimientos, pero no conoce el comportamiento de «responder una pregunta». El modelo base no es más que una máquina que «escribe la continuación de un texto», así que es normal.
Lo hice capaz de chatear con SFT
A partir de ahí hice un ajuste de instrucciones (SFT) para que pudiera responder preguntas como ChatGPT.
- Datos:
smol-smoltalkde Hugging Face (unas 460.000 conversaciones, 270 millones de tokens). - Formato de chat: añadí separadores como
<|user|>,<|assistant|>y<|end|>. Aquí reutilicé los identificadores libres que quedaron al redondear el vocabulario a 50304. Se pudieron añadir tokens especiales sin cambiar la arquitectura del modelo, así que aquel pequeño truco de rendimiento resultó útil aquí. - Solo se entrena la parte de la respuesta: la pregunta se lee, pero solo se imitan la respuesta del asistente y el
<|end|>final. - Dos épocas, unas 1 hora y 50 minutos.
El punto clave es entrenar también hasta <|end|>. Así el modelo aprende a detenerse por sí mismo cuando termina de hablar. ChatGPT y otros usan el mismo mecanismo: se detiene la generación cuando emiten una marca de finalización.
Ya parecía una conversación tras solo 5 minutos
Antes de empezar el SFT (paso 0), se confundía con los separadores desconocidos y entraba en un bucle infinito de «jakjakjakjak…». Pero con 500 pasos (unos 5 minutos), ya parecía una conversación.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Además, terminaba correctamente y se detenía. Aprender el estilo de conversación fue instantáneo.
Pero los conocimientos seguían igual. Un modelo intermedio decía que «París es la ciudad más grande del mundo y tiene unos 2.400 millones de habitantes».
Comparación antes y después del SFT
Comparé el mismo conjunto de preguntas antes del SFT (modelo base) y después.
| Pregunta | Antes del SFT | Después del SFT |
|---|---|---|
| What is the capital of France? | Empieza a enumerar opciones de la (a) a la (i) | «The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.» |
| Who are you? | «I am the person who has the gift for all that I do.» | «I'm a language learning AI assistant with over 10 years of experience» (una IA con 10 años de experiencia) |
| Translate "Good morning" into French. | Empieza a hablar de algo que no tiene relación con la pregunta | «Bonjour!» (correcto, pero después repite «Good morning (modifier)» sin parar) |
| What is 12 plus 7? | «es una arithmetic expression» | «12 + 7 = 21» → «12 + 7 = 30» → «35 + 7 = 34»: se equivoca cada vez más con un método que parece razonable |
| Who was Albert Einstein? | Un maestro de escuela cuyo padre era minero | Acertó a grandes rasgos con «prominent physicist». Sin embargo, «nació el 24 de febrero de 1905 en Viena» es falso |
El tono y el formato son completamente los de un asistente. El contenido contiene muchas falsedades. El cálculo era desastroso.
Probé a chatear de verdad
Creé un chat.py para hablar con el modelo desde la terminal y le hice algunas preguntas.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Es capaz de seguir la instrucción de «en una frase». Eso era algo que el modelo base no podía hacer.
En otra conversación, tras preguntarle por la capital, le pregunté a continuación por la población.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Entiende el contexto anterior y que «there = Japón». Sin embargo, justo después de decir que tiene 50.000 habitantes, afirma que en el norte viven 1.500 millones. Es un caos total.
Cuando le pregunté en japonés «¿Cuál es la capital de Japón?», respondió esto:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Como solo se entrenó con datos en inglés, al parecer el japonés le pareció un texto extraño que alguien quería corregir.
Por último, le pedí que «escribiera un haiku sobre una GPU», y creó un poema que repetía sin parar «I see the world, the thoughts, the emotions». Qué haiku ni qué nada.
Lo que aprendí al hacerlo
- Con una sola 4090, se puede crear en un día un modelo que supere al GPT-2 original. La GPU consumió unos 430 W. Solo el coste eléctrico de la GPU fue de aproximadamente 300 yenes, según una estimación.
- La forma de hablar se aprende al instante, pero el conocimiento lo determina el preentrenamiento. El SFT produjo formato conversacional en cinco minutos, pero apenas cambió la precisión factual.
- Un modelo de 124M tiene una gramática casi perfecta, pero está lleno de falsedades. Se aprecia muy claramente que la fluidez y la veracidad son cosas distintas.
- Los entrenamientos largos fallan por la infraestructura. Esta vez se detuvo no por el modelo, sino porque desapareció la ubicación de los datos de evaluación.
Al construirlo todo desde cero, se entiende de forma tangible que una IA como ChatGPT es una máquina que predice la continuación de un texto a la que se le han enseñado las reglas de la conversación. La próxima vez quiero intentar crear un modelo algo más orientado a usos prácticos.