Construí desde cero un LLM croata de 300 millones de parámetros para RAG. Funciona en CPU
Después del GPT-2 de la vez anterior, esta vez construí desde cero un LLM en croata con una sola RTX 4090. El objetivo es el RAG: un modelo que encuentra la respuesta dentro del texto proporcionado y responde citando una oración que sirva de fundamento. Y la idea es ejecutarlo en producción en CPU.
Primero, la conclusión.
- Unas 68 horas en GPU desde cero hasta terminarlo (incluyendo prueba y error). De ellas, 51 horas fueron de preentrenamiento
- 320 millones de parámetros. Logró un 71% de aciertos en preguntas sobre párrafos y un 44% en textos largos de unas 3.000 tokens
- Responde cada pregunta en solo 3 a 16 segundos con CPU. La velocidad permite seguir con la vista cómo aparece el texto
Tiempo dedicado al entrenamiento
| Proceso | Tiempo | Contenido |
|---|---|---|
| Generación de datos de entrenamiento | Unas 4,5 horas | 45.000 QA de Wikipedia y 50.000 traducciones de conversaciones con EuroLLM-9B (vLLM) |
| Tokenizador y tokenización | Unas 2,5 horas (CPU) | Creé un vocabulario propio de 32.000 términos para croata |
| Preentrenamiento | 50 horas y 46 minutos | 7.000 millones de tokens. En el último 10% amplié el contexto a 4.096 |
| SFT | Unos 35 minutos | Enseñé a responder con citas y a rechazar la pregunta si no hay respuesta |
| Aprendizaje por refuerzo (GRPO) | Unas 11 horas | 400 pasos más 300 pasos de ajuste |
El tokenizador propio puede representar el croata con aproximadamente la mitad de tokens que el tokenizador de GPT-2. Con 4.096 tokens puede leer alrededor de 17.000 caracteres.
El modelo resultante
| Elemento | Contenido |
|---|---|
| Parámetros | 320 millones (24 capas, 1024 dimensiones) |
| Arquitectura | Familia Llama / Qwen3 (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Longitud de contexto | 4.096 tokens |
| Formato de salida | Respuesta + Izvor: „una oración extraída tal cual del contexto“. Si no hay respuesta: «U tekstu nema odgovora na ovo pitanje. (No hay respuesta a esta pregunta en el texto)» |
| Ejecución | Pensado para CPU (aprox. 1,3 GB en fp32) |
Además, añadí externamente un mecanismo que comprueba mediante un programa si la cita generada realmente aparece en el contexto y, si no aparece, la sustituye por «sin respuesta». La clave es no confiar por completo en el modelo y dejar los fundamentos verificables.
Problemas que descubrí al construirlo
1. Aunque no haya respuesta, se la inventa siempre. Al principio solo le enseñé preguntas y respuestas normales. La tasa de acierto subió, pero al darle textos que no contenían la respuesta, generaba una respuesta plausible el 100% de las veces. Justo el peor problema para RAG. Al enseñarle a citar y a «rechazar», las invenciones bajaron a unos pocos puntos porcentuales.
2. Rechaza demasiado. Si la evaluación del aprendizaje por refuerzo era «−0,5 si se equivoca, 0 si rechaza», aprendió que, en textos largos difíciles, le convenía escapar rechazando, y empezó a rechazar el 70% de los casos. Aprovechó perfectamente el agujero de la regla de evaluación. Cuando cambié la penalización por rechazar a −0,3, se inclinó hacia el extremo opuesto: casi no rechazaba nada y las invenciones llegaron al 40%. Iba y venía como un balancín.
3. Errores al copiar las citas. En textos largos, aunque la respuesta fuera correcta, cambiaba el orden de las palabras de la cita o citaba la primera oración del artículo. En contexto largo, tanto la respuesta como la cita eran correctas en aproximadamente la mitad de los casos.
4. Errores que se cuelan en la comprobación. Citó correctamente una oración de otro artículo mezclado en el contexto que decía «nació en XX» y respondió el lugar de nacimiento de otra persona. La cita era auténtica, por lo que la comprobación no pudo detenerlo.
5. Fallos en los datos de evaluación. También hubo casos en los que, aunque el contexto debía carecer de respuesta, quedaba parte de ella; el modelo tenía razón, pero se lo clasificaba como «invención».
Rendimiento final
300 preguntas de evaluación para cada caso. Usé el modelo en el paso 100 del aprendizaje por refuerzo ajustado, que tenía el mejor equilibrio entre rechazar y responder.
| Contexto | Correctas | Incorrectas | Rechazadas |
|---|---|---|---|
| Párrafos (unos 100–400 tokens) | 71,3% | 16,7% | 12,0% |
| Contexto largo (1.500–3.500 tokens) | 44,0% | 20,3% | 35,7% |
| Contexto sin respuesta | Rechazo correcto | Invención |
|---|---|---|
| Párrafos | 97,7% | 2,3% |
| Contexto largo | 92,3% | 7,7% |
Después de pasar la comprobación, el «porcentaje de respuestas correctas entre las que sí respondieron» fue del 73,8%. Aún está lejos del objetivo del 90%.
Por cierto, si hacía que resolviera cada pregunta 8 veces y daba por bueno que acertara al menos una, llegaba al 91% en párrafos y al 74% en textos largos (medido en el último checkpoint). Estas cifras casi no cambiaron antes y después del aprendizaje por refuerzo; lo que cambió fue si podía resolverlo todas las veces. Los números dejaron claro que el aprendizaje por refuerzo, más que añadir nuevas capacidades, hace que los problemas que a veces puede resolver los resuelva siempre.
Ejecutándolo en CPU
Creé una interfaz web de prueba y la ejecuté solo con CPU (i7-13700K). La velocidad a la que aparece el texto es directamente la velocidad de generación.
Párrafo (263 tokens): 0,3 segundos hasta el primer carácter, unos 11 tokens/s, 7 segundos en total
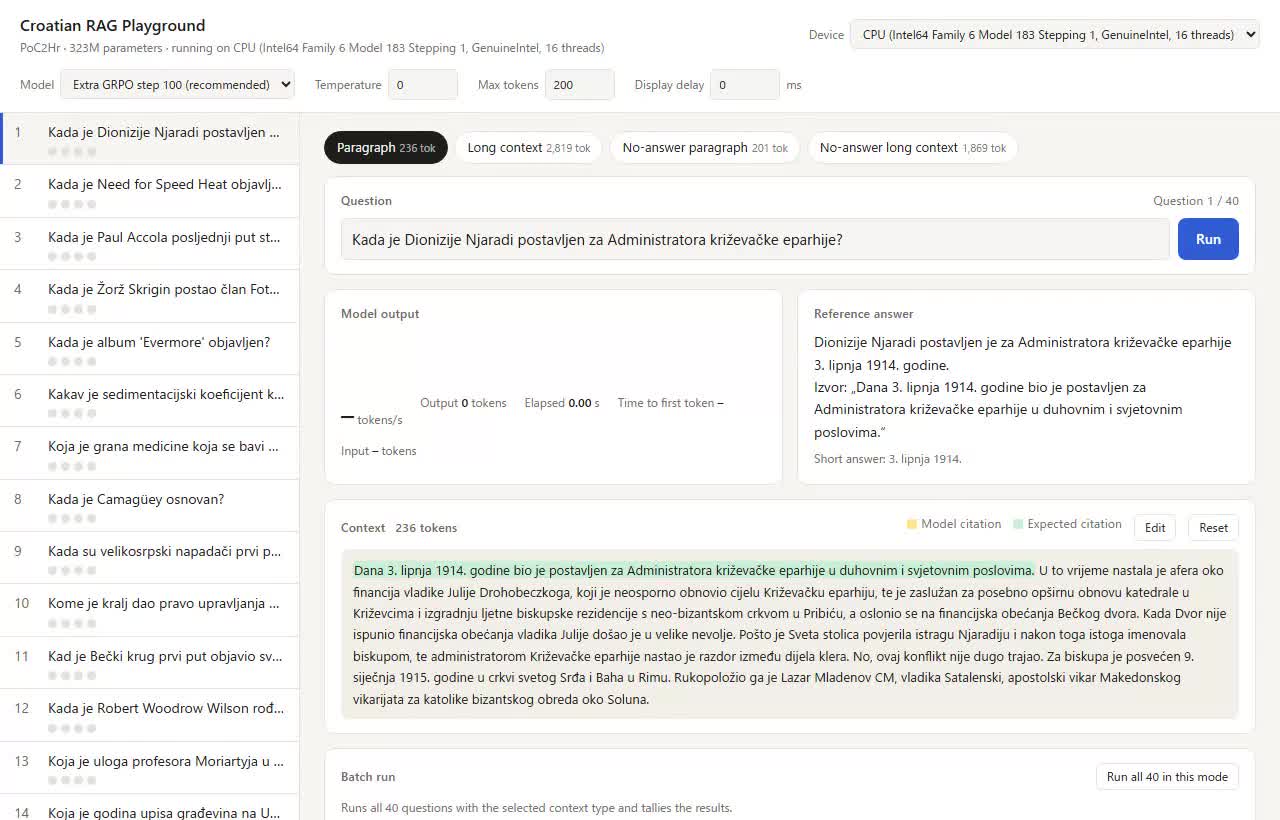
Contexto largo (3.215 tokens): unos 5 segundos para leer el texto, unos 5 tokens/s, 19 segundos en total. Lo amarillo es la oración citada: encuentra correctamente una oración dentro de 3.000 tokens
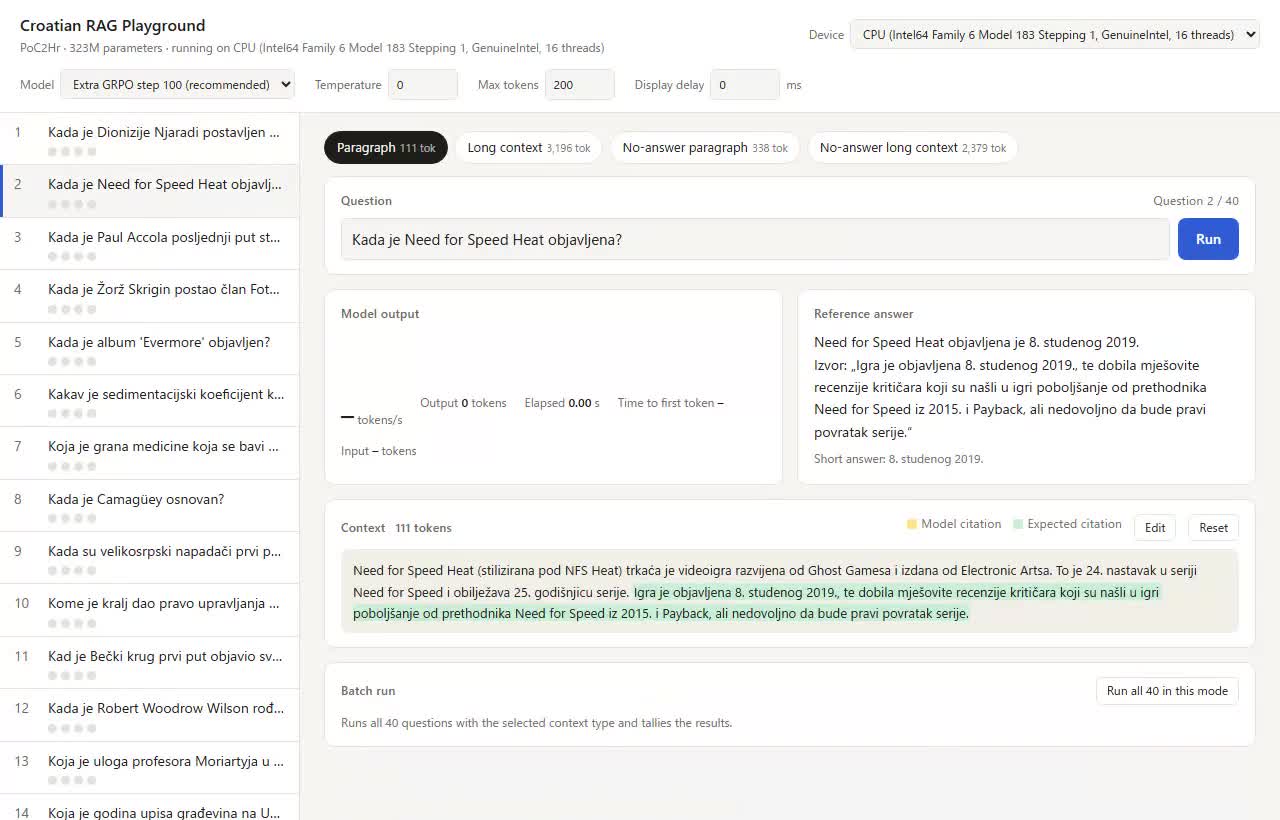
El vídeo es un poco más lento porque se grabó mientras se ejecutaba. Sin grabación, al medir 20 preguntas de cada tipo, obtuvo 15 tokens/s y 3,4 segundos por pregunta en párrafos, y 7 tokens/s y 16 segundos por pregunta en contexto largo. Las respuestas son cortas, de unos 50 tokens, así que parece una velocidad útil incluso en CPU.
Reflexiones
- En los modelos pequeños, lo más importante es lograr que digan «no sé lo que no sé». En RAG, reducir las invenciones importa más que la tasa de acierto. La combinación de cita, rechazo y comprobación externa funcionó bastante bien
- 300 millones es el límite para textos largos. Incluso con 8 intentos, los textos largos solo llegan al 74%. Para aspirar al 90% en textos largos, probablemente harían falta unos 1.000 millones de parámetros
- No basta con comprobar únicamente «si la cita realmente existe». Hay que verificar también que la cita incluya el número o nombre de la respuesta y que el sujeto sea la misma persona que en la pregunta
- Un modelo de 300 millones que funcione en CPU es ideal para preguntas y respuestas sobre documentos que no se pueden subir a internet. Puede responder basándose solo en documentos locales en un portátil o servidor sin GPU. Tarda unos segundos o decenas de segundos por pregunta, y debería ser aún más rápido con cuantización (sin verificar)
El siguiente paso será intentar alcanzar el 90% en contexto largo con una versión de 1.000 millones de parámetros.