Probé a crear un modelo de síntesis de voz en croata con 32 millones de parámetros: comparando voces durante el entrenamiento
Después del LLM para RAG en croata, esta vez probé a crear un pequeño modelo de síntesis de voz (TTS) exclusivo para croata. El objetivo era que funcionara en tiempo real en la CPU de un smartphone.
El método fue la «destilación». Hice que un gran modelo de síntesis de voz (HiggsAudio v3) leyera guiones en croata para generar datos de entrenamiento, y con ellos entrené un modelo pequeño desde cero. Esta vez realicé un entrenamiento piloto con 7,5 horas de datos y comparé cómo cambiaba una misma frase a medida que avanzaba el aprendizaje.
Primero, la conclusión.
- Con 32 millones de parámetros (Matcha-TTS: 18,3 millones + Vocos: 13,5 millones), habló croata correctamente
- Tras 50 minutos de entrenamiento (5.000 pasos), ya leía el guion tal como estaba escrito. Las mejoras posteriores fueron principalmente de «ruido»
- La tasa de error de caracteres de 14 frases de evaluación fue finalmente del 0,9 % (10 de las 14 frases coincidieron por completo)
- Incluso con un solo hilo de CPU, generó un segundo de audio en 0,09 segundos (i7-13700K)
Demo: haciéndolo hablar de verdad
Coloqué el modelo de este artículo (la versión final de 30.000 pasos) en el playground de TTS en croata. Introduce cualquier texto en croata y lo leerá al instante.
- Puedes elegir entre 50 frases de ejemplo (saludos, viajes, hospital, etc.) o escribir tu propio texto de hasta 1.000 caracteres
- Puedes modificar la velocidad de habla, la intensidad de la entonación y el número de pasos de síntesis. Si fijas la semilla, la misma frase producirá siempre el mismo audio
- La síntesis funciona únicamente con la CPU del servidor (ONNX Runtime; no usa GPU ni API externas)
- No puede leer números, así que hay que escribirlos con palabras, como «dvadeset pet (25)»
Lo que hice
1. Crear los guiones: hice que Gemma 4 31B en local escribiera diálogos cotidianos en croata. Especificaba al azar la situación, el interlocutor, la emoción y la longitud —por ejemplo, «hablando con una abuela en el mercado» o «tener miedo porque se oye un ruido extraño de madrugada»—, en lotes de 22 líneas. La configuración era la de una única hablante femenina de unos 30 años. Mezclé 23 tipos de emoción (normal, alegría, enfado, susurro, etc.).
2. Convertirlos en audio: hice que HiggsAudio v3 leyera los guiones con la voz de un audio de referencia (16 segundos). Al añadir etiquetas de emoción (<|emotion:anger|>, por ejemplo), se enfada o se alegra de forma convincente. Generé 4.500 audios en unas 5 horas.
3. Inspección automática: transcribí el audio con Whisper large-v3 y lo comparé con el guion para descartar errores de lectura. También medí, con un modelo de reconocimiento de hablantes, la similitud de la voz con el audio de referencia y descarté los casos en que la voz había cambiado. Aprobaron 4.393 de 4.500 audios (97,6 %). Tras recortar los silencios del inicio y del final, quedaron 7,46 horas.
4. Entrenar un modelo pequeño: entrené Matcha-TTS (un TTS basado en flow matching) durante 5 horas en una RTX 4090: unas 30.000 iteraciones. Para la parte que reconstruye la forma de onda del audio (el vocoder), usé Vocos publicado tal cual.
El croata se lee casi tal como se escribe, así que introduje los caracteres directamente, sin convertirlos a símbolos fonéticos. Sin embargo, lj, nj y dž son un solo sonido, así que los agrupé como un único carácter.
Comparación de audios durante el entrenamiento
Sinteticé con modelos en distintos puntos del entrenamiento una frase que no estaba en los datos de entrenamiento: «Molim Vas, možete li mi reći koliko košta ova haljina?» (Disculpe, ¿cuánto cuesta este vestido?).
paso 5.000 (unos 50 minutos desde el inicio del entrenamiento)
paso 10.000 (unas 1 hora y 40 minutos)
paso 15.000 (unas 2 horas y 20 minutos)
paso 20.000 (unas 3 horas y 10 minutos)
paso 30.000 (unas 5 horas, final)
Como referencia, un audio de los datos de entrenamiento creado por HiggsAudio, que hizo de profesor (otra frase: «Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.»).
Al transcribirlo con Whisper, esta frase fue idéntica al guion, carácter por carácter, desde el paso 5.000 hasta el final. Es decir, «qué dice» ya estaba resuelto desde el principio.
La diferencia está en la limpieza del sonido. Al escucharlo, el paso 5.000 tiene un ruido áspero superpuesto, que disminuye mucho en el paso 10.000. Se aprecia claramente al convertir el mismo audio en un espectrograma (tiempo en el eje horizontal y frecuencia en el vertical).
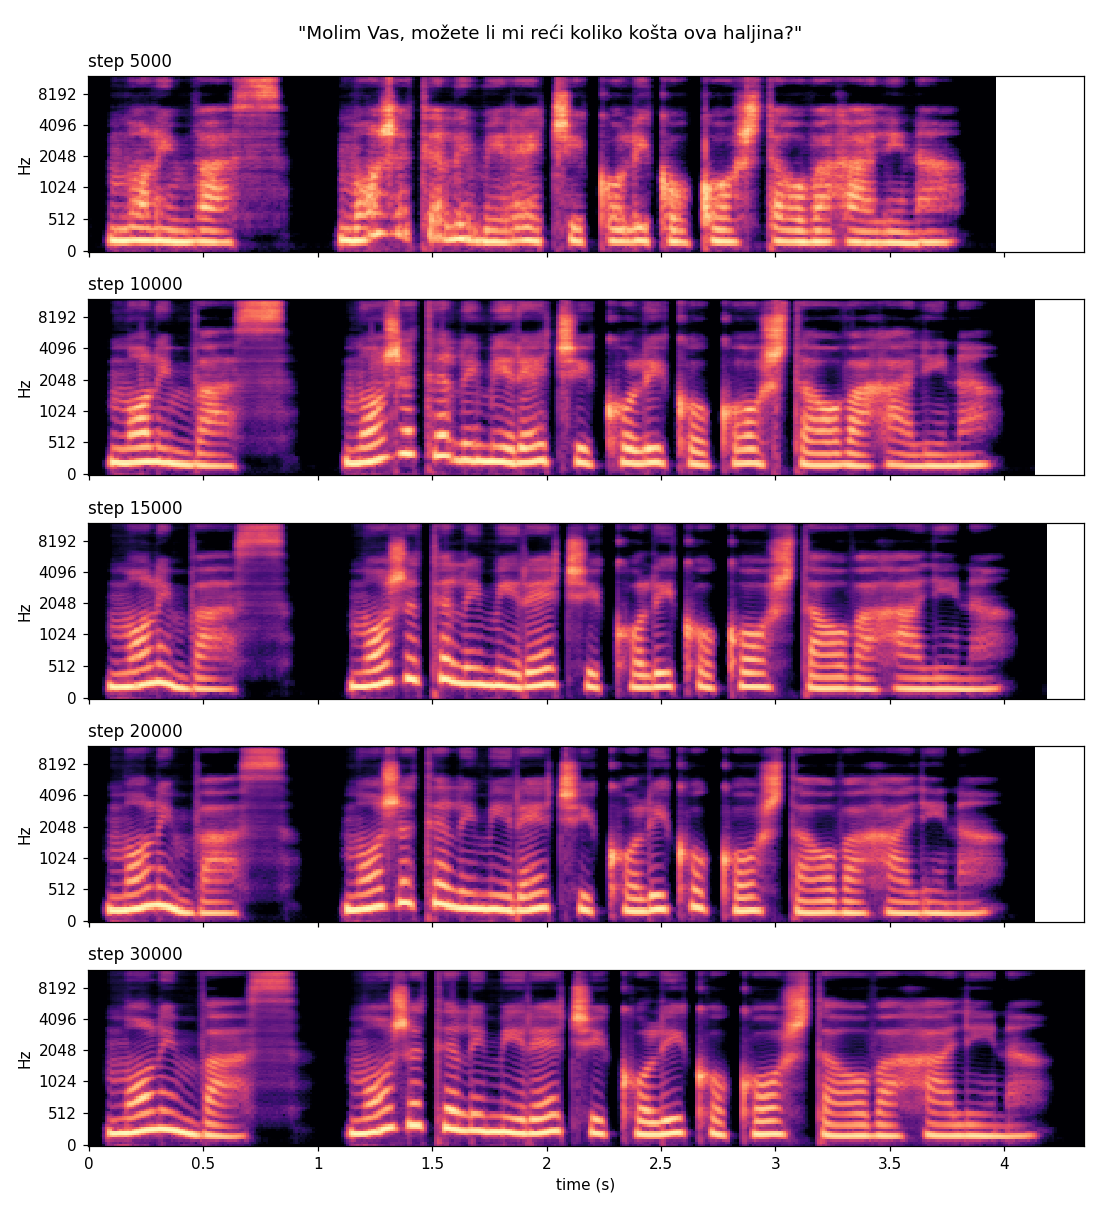
Las franjas horizontales (armónicos) que se alinean con el tono de voz aparecen borrosas en el paso 5.000, y los espacios entre ellas están difusamente rellenos. Esa es la parte que se percibe como ruido. Desde el paso 10.000, las franjas se vuelven nítidas y los espacios se oscurecen. A medida que avanza el entrenamiento, las franjas también parecen curvarse suavemente hacia arriba y hacia abajo, haciendo más evidente el movimiento del tono de voz (la entonación).
Visto en cifras
Transcribí 14 frases de evaluación (todas fuera de los datos de entrenamiento) con Whisper large-v3 y medí la tasa de error de caracteres (CER). Incluyen desde saludos breves hasta monólogos de unos 16 segundos.
| Pasos | Tiempo de entrenamiento | Tasa de error de caracteres | Coincidencia completa |
|---|---|---|---|
| 5.000 | Unos 50 min | 1,1 % | 9 / 14 |
| 10.000 | Unas 1 h 40 min | 3,4 % | 8 / 14 |
| 15.000 | Unas 2 h 20 min | 0,7 % | 11 / 14 |
| 20.000 | Unas 3 h 10 min | 0,9 % | 11 / 14 |
| 30.000 | Unas 5 h | 0,9 % | 10 / 14 |
- Que los resultados empeoraran en el paso 10.000 se debió casi por completo a una frase: «Bok! (¡Hola!)» se transcribió como «Vok». Como difiere en un carácter de tres, esa única frase tiene una tasa de error del 33 %. Al oído, el paso 10.000 era mucho más limpio que el paso 5.000. La tasa de error de caracteres solo mide si se ha leído correctamente, así que la limpieza del audio solo puede juzgarse escuchándolo
- Los errores que quedaron hasta el final fueron đ y dž en «Đak je pojeo džem (El estudiante comió mermelada)». Son sonidos poco frecuentes incluso en croata, y se transcribieron como «Žak» y «Džak»
Velocidad en CPU
Lo medí en un i7-13700K, con PyTorch tal cual (sin optimización). Es el promedio de tres generaciones de 4 frases, con un total de 47,6 segundos de audio. RTF es «el tiempo tardado en generarlo ÷ la duración del audio»; cuanto menor, más rápido.
| Número de hilos | Número de pasos | Matcha | Vocos | RTF total |
|---|---|---|---|---|
| 1 | 2 | 0,042 | 0,025 | 0,067 |
| 1 | 4 | 0,067 | 0,025 | 0,092 |
| 4 | 4 | 0,032 | 0,010 | 0,042 |
| 8 | 4 | 0,028 | 0,007 | 0,036 |
El «número de pasos» es el número de iteraciones que convierte el ruido en audio durante la síntesis; las comparaciones anteriores se generaron con 4. Incluso con un solo hilo, puede generar un segundo de audio en 0,09 segundos. Las CPU de los smartphones son más lentas, pero debería seguir siendo tiempo real (aún no lo he medido en un dispositivo real, así que es una estimación).
¿Cuántas horas de datos necesita un TTS?
Como se pudo llegar hasta aquí con 7,5 horas, investigué las referencias habituales.
- LJSpeech, un corpus inglés muy usado para TTS de una sola voz, tiene unas 24 horas. El modelo oficial de Matcha-TTS también se entrena con él
- JSUT en japonés y CSMSC en chino tienen unas 10 horas y se usan habitualmente como corpus de una sola voz
- Para entrenar desde cero, alrededor de 1 hora es el límite inferior; según el modelo, pueden aumentar los errores de pronunciación
- Para el ajuste adicional de un modelo preentrenado, hay informes de que 30 minutos lograron resultados equivalentes a entrenar desde cero durante 27 horas
También encontré una investigación que entrenó Matcha-TTS únicamente con voz sintética (Universidad Jiao Tong de Shanghái, diciembre de 2025). Según el estudio, mejora con mayor variedad de textos, con audio limpio y sin ruido, y cuando el estilo de habla es consistente. Como los datos sintéticos no tienen ruido y su forma de hablar es uniforme, puede que, a igualdad de duración, sean más fáciles de aprender que las grabaciones reales. Que en este caso se haya llegado hasta aquí con 7,5 horas también parece apuntar en esa dirección.
Dificultades encontradas
- El PC se congeló: por accidente cargué simultáneamente en la GPU dos modelos de 31B para crear los guiones, y la VRAM se desbordó. Desde entonces, adopté la regla de «solo un modelo cargado en la GPU en todo momento»
- Gemma 4 piensa demasiado: aproximadamente dos tercios de la salida eran «razonamiento». Al desactivarlo, fue unas tres veces más rápido
- Alucinaciones auditivas de HiggsAudio: en una prueba inicial, añadió por su cuenta «Hvala što pratite kanal (Gracias por seguir el canal)» al silencio después de la frase, creando un clip de 81 segundos. Parece haber aprendido una despedida de YouTube. Empecé a descartar los audios cuya duración se desviaba mucho de lo previsto
- Matcha-TTS no funciona en Windows: algunas extensiones de C no se pudieron compilar, así que reescribí esa parte en Python (numba)