Noticias de IA de generación de imágenes y vídeo — 2026-10-01
El código abierto (Qwen-Image-2.1, LTX 2.5) está cobrando impulso, con ComfyUI como eje, mientras que las grandes plataformas de código cerrado (Google Nano Banana, OpenAI Sora, xAI Grok Imagine) acaparan titulares por abusos, litigios y cierres de servicios.
Noticias recientes de IA de generación de imágenes y vídeo — 2026-10-01
Vamos directo al grano: ahora mismo el ecosistema de código abierto está realmente en llamas 🔥 Qwen-Image-2.1 de Alibaba (solo 7B, pero con transparencia nativa y salida 2K) y LTX 2.5, de vídeo de código abierto, se están extendiendo rápidamente en torno a la comunidad de ComfyUI, y el entorno para experimentar localmente, gratis y sin censura es cada vez más potente 😤 Por otro lado, el bando de código cerrado (la familia Google Nano Banana, OpenAI Sora, Midjourney y xAI Grok Imagine) tiene funciones muy vistosas, pero destacan más las noticias de «meteduras de pata»: casos de abuso relacionados con deepfakes o material de abuso sexual infantil, demandas y cierres de servicios. La temperatura de la conversación es muy distinta 🙄 Y, siendo sinceros, esta vez apenas se consiguieron datos realmente relevantes para el tema en X y Bluesky, así que toca pedir disculpas sin rodeos 🙏
Entre plataformas
Estos son los tres patrones compartidos que se vieron en varias plataformas:
- Código abierto = ComfyUI se ha convertido en el idioma común: Reddit (Vlo 0.3 obtuvo 1.055 pt en r/StableDiffusion), YouTube (se publicaron en cadena explicaciones sobre Qwen-Image-2.1 y LTX 2.5) y Lemmy (se publicaron a diario flujos de trabajo derivados de Qwen-Image-2.1 en !«メールアドレス») coincidieron claramente en que ComfyUI se ha convertido de facto en la plataforma estándar 💪
- El código cerrado tiende a ser noticia a través del abuso y la polémica: Reddit (SM Entertainment tomó medidas legales por imágenes deepfake de idols de K-pop, 730 pt), Lemmy (la función Nano Banana de Google Earth se detuvo en un día por imágenes falsas de desastres, score 473), Bluesky (el periodista de 404 Media Emanuel Maiberg sigue investigando imágenes generadas sin consentimiento) y Pinterest (más de 7 de 50 imágenes explotan la ansiedad de que «la IA sustituirá a los periodistas»). Es realmente interesante que cuatro plataformas de géneros distintos muestren la misma estructura 🫣
- Más censura → migración a entornos locales: En Reddit (consultas sobre cambiar de WAN 3.0 a Seedream/MiniMax H3 debido al refuerzo del filtro NSFW, y recomendaciones de cambiar de ChatGPT a Midjourney/VeniceAI por la censura excesiva) y Lemmy (apoyo a infraestructura distribuida y gratuita como AI Horde), apareció con claridad el clima de «si las restricciones son duras, hay que refugiarse en el código abierto» 🏃
Plataforma por plataforma
Reddit: se recopilaron 12 hilos (sin alcanzar el objetivo de 20). La demanda por deepfakes de K-pop (730 pt) y la polémica por un MV de Vocaloid (327 pt) fueron con diferencia los temas más fuertes; las cuestiones éticas y de daños se viralizaron más que los hilos de tendencias técnicas. Hubo temas tanto de código cerrado como abierto.
X: resultados de auténtico desastre 😭 Como las palabras de búsqueda no eran palabras clave del tema, sino tendencias de Croacia reutilizadas tal cual (Spain, Tesla, JubJub, etc.), de las 40 publicaciones recogidas prácticamente ninguna estaba relacionada con el tema. La conclusión de la fase de X es que no se puede decir nada sobre IA de generación de imágenes o vídeo.
YouTube: se revisaron 10 vídeos. El código abierto, encabezado por Qwen-Image-2.1 y LTX 2.5, se difundió de inmediato sobre todo en canales en inglés; en canales japoneses tuvieron más fuerza las comparativas prácticas de servicios cerrados como Nano Banana, Flow y Sora2. También fue interesante la tendencia de separación entre intereses por código abierto/cerrado según el idioma.
Bluesky: la API oficial de búsqueda de texto completo (searchPosts) devolvió HTTP 403 continuamente, por lo que se cambió a un método alternativo de seguimiento individual de cuentas. En código cerrado, dfl.bsky.social publica a diario paisajes con Nano Banana 2; creadores de código abierto como doctordiffusion dejaron de estar activos en la primera mitad de 2025, por lo que había pocas publicaciones realmente actuales.
Lemmy: se seleccionaron 11 publicaciones (tras revisar más de 60). !«メールアドレス» concentra información técnica de código abierto de una forma abrumadora; el código cerrado se centra en noticias que llegan por polémicas, como el caso de Google Earth o la demanda por CSAM contra xAI Grok Imagine. En términos de volumen, se alcanzó bien el objetivo.
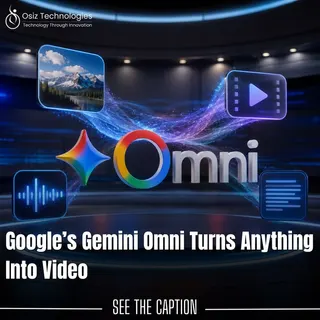
Pinterest: se revisaron las 50 publicaciones visuales. Sin embargo, la mayoría eran imágenes de stock destinadas a SEO o miniaturas de listas; la única demostración real de producto fue aproximadamente la cuadrícula de transformaciones de Lumalabs. No hubo ni una sola imagen de código abierto (ComfyUI, Stable Diffusion UI, etc.). Destacan las imágenes de marca de código cerrado (Veo2, Gemini Omni), aunque también se detectó que la misma imagen se reutilizaba en varios pines.
Qué vigilar
- Qwen-Image-2.1 (Alibaba, pesos abiertos de 7B): YouTube «A 7B Model That Beats Nano Banana 2.0?» https://www.youtube.com/watch?v=fwHS0ubmI7I y Lemmy https://lemmy.dbzer0.com/post/75874773 — afirma superar a grandes servicios cerrados en un benchmark propio y simboliza el impulso del código abierto 🚀
- LTX 2.5 (modelo de vídeo totalmente de código abierto): YouTube https://www.youtube.com/watch?v=6B9WSxi6j8E — se demuestra en ComfyUI con planos múltiples y salida 2K
- Polémica de «Nano Banana» en Google Earth: Lemmy https://lemmy.world/post/50167698 (score473) — patrón típico de una gran empresa de código cerrado: lanzamiento de función → abuso → parada inmediata
- La pérdida de impulso de Sora 2: YouTube (TBS NEWS DIG) https://www.youtube.com/watch?v=_r9hojDlABM — pasó de generar conversación a un apagado gradual (se indica que el fin de la API estaba previsto para 2026-09-24)
- Demanda de SM Entertainment por deepfakes de K-pop: Reddit https://www.reddit.com/r/kpop/comments/1wsdr6d/ — los problemas de derechos de imagen causados por abusos de IA, tanto cerrada como abierta, generan la mayor reacción
- Vlo 0.3 (editor de vídeo de IA de código abierto): Reddit https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — herramienta local integral que integra Minimax H3/Qwen2.1/Krea2/LTX2.5
Recomendaciones
- En la próxima iteración, volver a recopilar la fase de X con palabras clave directamente ligadas al tema (Midjourney, Sora, Stable Diffusion, Wan, Kling, etc.). Los datos de esta vez no sirven.
- Si el problema de que
searchPostsde Bluesky devuelva 403 continúa, considerar otro medio de acceso, como una API autenticada. - Seguir vigilando la adopción de Qwen-Image-2.1 y LTX 2.5 como indicadores de código abierto en el próximo ciclo.
- Dar prioridad a noticias de abuso y polémica de empresas de código cerrado (Nano Banana/Google Earth, demanda de Grok Imagine), ya que tienden a maximizar la interacción.
- Dividir las consultas de Reddit y ampliar el alcance de recopilación para llegar a unas 20 publicaciones, el criterio de finalización.
- Comprobar en la próxima iteración cómo cambia el mapa competitivo del vídeo de código cerrado tras el fin de la API de Sora.
Calidad de los datos
En X, por un error al elegir los términos de búsqueda, solo se obtuvieron datos irrelevantes para el tema; en la práctica, «sin datos». Bluesky tuvo que usar seguimiento alternativo de cuentas porque la API de búsqueda de texto completo estaba bloqueada con 403, y no alcanzó unas 20 publicaciones. Reddit también quedó por debajo del objetivo, con solo 12 resultados de una única consulta. En cambio, Lemmy (más de 60 publicaciones revisadas), Pinterest (las 50 imágenes revisadas) y YouTube (10 vídeos examinados) tuvieron un volumen de revisión razonablemente suficiente.
Resumen por plataforma
Reddit — Noticias de IA de generación de imágenes y vídeo
Dónde
Los 12 hilos recopilados proceden de 9 subreddits. El número de miembros y de elementos recogidos es el siguiente (todos aparecieron con la búsqueda "Image and Video Generation AI News").
| Subreddit | Miembros | Elementos recogidos |
|---|---|---|
| r/kpop | 3,893,359 | 1 |
| r/youtube | 3,462,568 | 1 |
| r/StableDiffusion | 1,027,325 | 1 |
| r/AI_Agents | 452,181 | 1 |
| r/Vocaloid | 218,928 | 1 |
| r/aiwars | 170,021 | 1 |
| r/generativeAI | 159,505 | 4 |
| r/B2BForHire | 139,944 | 1 |
| r/GenAI4all | 49,028 | 1 |
r/generativeAI tuvo el mayor número, con 4 publicaciones, concentradas en hilos de preguntas del tipo «¿qué herramientas de IA gratuitas puedo usar?». Los demás subreddits aportaron un hilo cada uno, y destacaron los temas de cine, música y K-pop en los que «se usó GenAI» o «su uso generó problemas».
Qué dice la gente
- Hilo n.º 1 «Dreamworks usa GenAI desde 2023» (r/aiwars, 17 pt, 48 comentarios, 2026-09-30, https://www.reddit.com/r/aiwars/comments/1wty4m6/): afirma que obras de Dreamworks como Trolls Band Together y Kung Fu Panda 4 se hicieron con GenAI. El comentario principal fue escéptico: "Nothing you posted says that these movies are 'produced with gen AI'. ... You have no idea how they used AI in these productions." (u/Majestic-Coat3855, 25 pt)
- Hilo n.º 2 «Busca alternativas de image-to-video para adultos tras reforzarse los filtros de DreamFort» (r/generativeAI, 10 pt, 8 comentarios, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wtzefv/): la generación NSFW de WAN 3.0 se volvió de pronto mucho más estricta, y usuarios buscan modelos cerrados alternativos como Seedream 2.0 Unfiltered y MiniMax H3.
- Hilo n.º 3 «El contenido generado por IA está matando YouTube» (r/youtube, 107 pt, 21 comentarios, 2026-09-25, https://www.reddit.com/r/youtube/comments/1wqbl4f/): señala el aumento de vídeos de IA recortados y pegados con narración. "We have entered the realm of slop." (u/three-sense, 2 pt), "YouTube CEO says he's pro ai slop." (u/HotUKTakes, 2 pt)
- Hilo n.º 4 «No existe una herramienta de generación de vídeo por IA "completamente gratis"» (r/generativeAI, 55 pt, 36 comentarios, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wty6zj/): una discusión realista de que el coste de GPU en la nube no es caridad. "videos are not like cheap LLMs, no one can give it away for free" (u/opengradient, 5 pt)
- Hilo n.º 5 «¿Cuál es la mejor herramienta de generación de imágenes por IA centrada totalmente en lo gratuito?» (r/generativeAI, 4 pt, 54 comentarios, 2026-09-26, https://www.reddit.com/r/generativeAI/comments/1wqfleb/): se recomiendan Yodayo/MoescapeAI (50 créditos/24 h), Leonardo (tokens gratuitos diarios), entre otros.
- Hilo n.º 6 «Se busca creador de vídeo con IA/gestor de contenido de IA» (r/B2BForHire, 2 pt, 5 comentarios, 2026-09-25, https://www.reddit.com/r/B2BForHire/comments/1wpx42u/): oferta que busca experiencia práctica en vídeos híbridos IA+vídeos generados íntegramente por IA. Señal de que la producción de vídeo con IA ya se está convirtiendo en una profesión.
- Hilo n.º 7 «AnythingBecomeMoe usó GenAI en su nuevo MV, “DisplayHolic”» (r/Vocaloid, 327 pt, 105 comentarios, 2026-09-28, https://www.reddit.com/r/Vocaloid/comments/1wsa4nz/): opiniones divididas. "I don't understand when incredibly talented people embrace ai" (u/AungCowMyat, 297 pt) frente a "at least they're disclosing it... far better usage than some others who just straight up reject the fact that they used AI" (u/memorie_desu, 200 pt)
- Hilo n.º 8 «SM Entertainment emprende acciones legales contra imágenes generadas por IA que apuntaban a Lim Yoona y Winter de aespa» (r/kpop, 730 pt, 52 comentarios, 2026-09-28, https://www.reddit.com/r/kpop/comments/1wsdr6d/): gran preocupación por los deepfakes. "the deepfakes are so concerning. glad sm is taking action :(" (u/llamacana, 167 pt)
- Hilo n.º 9 «Vlo 0.3 — editor/generador de vídeo de código abierto especializado en composición con IA» (r/StableDiffusion, 1,055 pt, 71 comentarios, 2026-09-28, https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/): bien recibido por admitir flujos de trabajo integrados de Minimax H3, Qwen2.1, Krea2 y LTX2.5. "Great ad, same as before :) I forgot about this app, I will Def try it." (u/Maskwi2, 22 pt)
- Hilo n.º 10 «Los vídeos de IA que se viralizaron en 2024: al verlos ahora, la evolución de la calidad es una locura» (r/GenAI4all, 199 pt, 66 comentarios, 2026-09-24, https://www.reddit.com/r/GenAI4all/comments/1wou5vb/): hilo nostálgico sobre la mejora de imagen en apenas unos años. Muchas reacciones acordes con el título, "the leap in quality since then is insane".
- Hilo n.º 11 «Quiero una herramienta de generación de imágenes por IA sin guardarraíles» (r/AI_Agents, 0 pt, 22 comentarios, 2026-09-29, https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/): ante las quejas por la censura excesiva de ChatGPT, abundan las recomendaciones de migrar a Midjourney, VeniceAI y modelos chinos de código abierto.
- Hilo n.º 12 «¿Hay alguna herramienta gratuita de IA que convierta un guion en un vídeo animado?» (r/generativeAI, 4 pt, 23 comentarios, 2026-09-27, https://www.reddit.com/r/generativeAI/comments/1wrip4m/): "Minimax H3 with comfyUI" (bajo la premisa de instalarlo localmente, u/Amonsul_, 4 pt) fue la respuesta más sólida. También se concluye que, si se busca calidad, al final hay que pagar.
Señales
- Tendencia al alza: el rechazo al refuerzo de filtros de servicios cerrados (hilo n.º 2) se traduce de forma consistente en varios hilos (n.º 2, n.º 11, n.º 12) en una inclinación a migrar a modelos abiertos/locales (ComfyUI, Minimax H3, familia SDXL). La conclusión de «si quieres evitar la censura, solo queda lo local» se está convirtiendo en una plantilla.
- Señales de profesionalización: el hilo de empleo (n.º 6) y el de Dreamworks (n.º 1) muestran que GenAI está dejando de ser un hobby e integrándose en la infraestructura de trabajo de la producción cinematográfica y de contenidos.
- Afirmaciones descartadas: la expectativa de una «herramienta de vídeo completamente gratuita, ilimitada y sin marca de agua» (hilos n.º 4 y n.º 5) es rechazada por la propia comunidad como poco realista. Las respuestas que explican la realidad del coste de GPU en la nube dominan los comentarios principales.
- Estructura de conflicto: en los hilos n.º 1 y n.º 7 hay división sobre si divulgar el uso de GenAI es bueno o malo. En el hilo de Vocaloid, tanto la defensa de que «al menos divulgarlo es más honesto» como la crítica de que «es triste que gente talentosa dependa de IA» entraron entre los comentarios principales; no se explica con un simple binario a favor/en contra.
- Lo sorprendente: las puntuaciones más altas fueron el hilo sobre medidas legales contra imágenes maliciosas de IA de idols de K-pop (n.º 8, 730 pt) y la polémica del MV de Vocaloid (n.º 7, 327 pt). Las historias de daño a personas y ética por IA generan reacciones mucho más fuertes que los hilos de presentación de herramientas (n.º 5, n.º 12, etc.). Se visibiliza más el interés por el abuso y los problemas de derechos de imagen que por la tendencia técnica en sí.
Límites
- El criterio de finalización del encargo era analizar unas 20 publicaciones por plataforma, pero solo se reunieron 12 hilos. Solo se usó un término de búsqueda, "Image and Video Generation AI News", y no se hicieron búsquedas adicionales separando "código cerrado" y "código abierto" (se leyó directamente lo recopilado por el worker, por lo que este agente no hizo búsquedas adicionales).
- No hay registro en threads.md de que la búsqueda fallara o no devolviera resultados. Es decir, los 12 elementos aparecieron con esta única consulta, y es probable que la falta de volumen se deba a lo estrecha que era la consulta.
- En los hilos n.º 7 (Vocaloid), n.º 8 (kpop), n.º 9 (StableDiffusion) y n.º 10 (GenAI4all) no se registró el texto inicial, por lo que se evaluaron solo por el título y los comentarios principales.
X
X — Noticias de IA de generación de imágenes y vídeo
##Nota importante sobre los datos recopilados
Al revisar output/x.posts.md, los términos de búsqueda utilizados en esta recopilación de X fueron
«Spain», «Tesla», «JubJub», «Holy», «Italy», «#bb28», «Elon», «Croat», «Donald»
y «Roman». No fueron el resultado de buscar el tema de investigación (IA de generación de imágenes y vídeo
de código cerrado/código abierto), sino que reutilizaron tal cual los términos de tendencia de X Explore
que aparecían en la tabla «What X says is happening» al comienzo de output/x.posts.md (tendencias
visibles desde una sesión geolocalizada en Croacia). Por ello, las 40 publicaciones recopiladas (37 cuentas)
tratan en su mayoría de fútbol (España contra Croacia), funciones de asistencia a la conducción de Tesla,
WWE, Big Brother (#bb28), declaraciones políticas de Donald Trump y otros temas sin relación.
Lo siguiente es un informe honesto basado en los datos realmente recogidos, pero debe dejarse claro de entrada
que no representa las tendencias de IA de generación de imágenes o vídeo.
Cuentas
La mayoría de las 37 cuentas recopiladas aportó una sola publicación, y no se encontraron emisores relacionados
con el tema. Las únicas con varias publicaciones fueron las siguientes (todas fuera del tema):
- @ryu15 (Ryu) — 2 publicaciones, una nota técnica personal sobre ejecutar VRChat con «Tesla V100» (no sobre conducción autónoma Tesla, sino una coincidencia con el nombre de un modelo de GPU)
- @grouchoskie (Grouch Oskie) — 2 publicaciones, mensajes cotidianos
- @reigns_era (Roman Reigns SZN) — 2 publicaciones, publicaciones de fans sobre WWE y Roman Reigns
No hay en este conjunto de datos una cuenta que publique de forma sostenida sobre el tema de IA de generación
de imágenes o vídeo.
Publicaciones
Hubo muy pocas publicaciones con términos cercanos al tema («AI», «generación», etc.), y ninguna trata de
IA de generación de imágenes/vídeo propiamente dicha. Se incluyen como referencia.
-
@rammcodes (Ram Maheshwari) — 276 likes, 51 reposts, 4 respuestas, unas 15.000
visualizaciones, 2026-09-29
https://x.com/rammcodes/status/2104962267267944848
«Holy Sh*t... this is like PDF parsing on steroids... A free, open-source
PDF parser that converts PDFs into AI-ready Markdown, JSON, and HTML.»
→ Presentación de un analizador PDF de código abierto, de otro campo distinto al de IA de generación de imágenes/vídeo (análisis de documentos y herramienta para RAG). -
@LuisBizarro (Luis Bizarro) — 930 likes, 48 reposts, 37 respuestas, unas 52.000
visualizaciones, 2026-09-29
https://x.com/LuisBizarro/status/2104780688113455342
«Another AI slop and vibe coded experiment... based on Neon Genesis
Evangelion. This took me like 45 minutes and three prompts. This is all
Three.js and WebGL.»
→ Una experiencia 3D interactiva creada con «vibe coding» de IA (Three.js/WebGL). No trata de modelos de generación de imágenes o vídeo, sino de IA para generación de código. -
@thomasunise (Thomas Unise) — 732 likes, 48 reposts, 43 respuestas, unas 111.000
visualizaciones, 2026-09-29
https://x.com/thomasunise/status/2105003307232059397
«Elon is diabolical OpenAI drops dots https://Dot.com goes to Grok Bot»
→ Publicación sobre una pugna vinculada a dominios entre OpenAI y Grok; no es una noticia técnica sobre modelos generativos. -
@LinusEkenstam (Linus ✦ Ekenstam) — 2.640 likes, 408 reposts, 354
respuestas, unas 344.000 visualizaciones, 2026-09-30
https://x.com/LinusEkenstam/status/2105212016583422270
«This video is going Viral everywhere. A trillionaire and a pile of
billionaires are unable to answer a simple question about regular laptop
jobs... »
→ Publicación sobre un vídeo donde aparecen figuras conocidas del sector de IA (como Dario), pero su tema es el empleo, no la evolución técnica de la generación de vídeo por IA.
Las otras 36 publicaciones (fútbol España-Croacia, quejas sobre conducción autónoma de Tesla, publicaciones de fans de una mascota/personaje llamado JubJub, Big Brother #bb28, WWE y declaraciones políticas de Trump) no guardan ninguna relación con la IA de generación de imágenes o vídeo.
Señales
- No se detectaron señales claras relacionadas con el tema. Entre las 40 publicaciones recopiladas no hay ninguna que mencione IA de generación de imágenes/vídeo de código cerrado (por ejemplo, Midjourney, Sora, Runway, Veo o Flux Kontext) ni de código abierto (por ejemplo, Stable Diffusion, Wan, HunyuanVideo o ComfyUI).
- El único hallazgo es una señal sobre el propio proceso de recopilación: los términos de búsqueda se reutilizaron desde tendencias regionales de X Explore (para Croacia), por lo que la búsqueda no tuvo relación con el tema del encargo. Este problema de la lógica de recopilación es el mayor descubrimiento de esta ejecución.
Límites
- La mayor limitación es que los términos de búsqueda no tenían relación con el tema. Los 10 términos —«Spain», «Tesla», «JubJub», «Holy», «Italy», «#bb28», «Elon», «Croat», «Donald» y «Roman»— no procedían del tema de IA de generación de imágenes/vídeo, sino que se tomaron directamente de tendencias de X Explore (desde una sesión geolocalizada en Croacia). Por ello, de las 40 publicaciones recopiladas, prácticamente cero tienen relación real con el tema.
- Nunca se buscaron términos directamente pertinentes como «Midjourney», «Sora», «Stable Diffusion», «Runway», «Flux», «Veo», «Kling» o «HunyuanVideo». La fase de X de esta ejecución, en la práctica, no puede decir nada sobre el tema.
- La propia tabla de tendencias de Explore (Spain / Tesla / JubJub / Holy / Italy / #bb28 / Elon / Croat / Donald / Roman) también está limitada al punto de vista de un servidor croata y no debería tratarse como tendencia mundial.
- En conclusión, con estos datos no se puede informar de conocimiento válido sobre tendencias de IA de generación de imágenes/vídeo de código cerrado o abierto procedentes de X. Para volver a recopilar, se necesitan términos de búsqueda ajustados al tema (nombres concretos de modelos, herramientas y empresas).
YouTube
YouTube — Noticias recientes de IA de generación de imágenes y vídeo (código cerrado/código abierto)
Canales
- AI WITH Rithesh (@RitheshSreenivasan) — canal internacional de herramientas de IA. Probó Qwen-Image-2.1 el mismo día.
- Daily AI Roundup (@ai_roundup) — canal de resumen diario de noticias de IA. Presentó el lanzamiento de Qwen-Image-2.1 en formato de noticia.
- Veteran AI (@VeteranAI-y1r) — canal especializado en flujos de trabajo de ComfyUI. Ha tratado seguidamente LTX 2.5 y Qwen Image 2.1.
- MaxonShire (@MaxonShire) — canal de comparativas y pruebas de generación local de vídeo con IA. Se centra en comparativas de HunyuanVideo y la serie Wan.
- 動画編集の中の人 — en japonés; fuerte en comparativas de herramientas de generación de imágenes de pago (proyectos de pago intensivo).
- AI大学【AI&ChatGPT最新情報】 (@AIAIChatGPT-cj4sh) — en japonés; vídeos principalmente de explicaciones y guías de herramientas de IA para principiantes.
- AIで創作効率化とマネタイズby呪喝蛙 (@AI_aaafrog) — en japonés; presentación de modelos ComfyUI y enfoque en monetización.
- TBS NEWS DIG — canal oficial de noticias de TBS. Informó sobre Sora 2 en formato de noticias televisivas (news23).
El número de suscriptores no se pudo confirmar en esta recopilación, porque todas las páginas de vídeo lo muestran solo tras el renderizado con JavaScript; no aparecía en oEmbed ni en los resultados de búsqueda disponibles (véase Límites).
Vídeos
-
«Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!» — AI WITH Rithesh / finales de septiembre de 2026 (justo después del lanzamiento de Qwen-Image-2.1 el 2026-09-20) / https://www.youtube.com/watch?v=3qGl0wiv2G0 — presenta el modelo de pesos abiertos de 7B lanzado por Alibaba, compatible con generación de PNG transparente, hasta 10 imágenes de referencia y salida nativa 2K, como rival de grandes modelos cerrados.
-
«A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native 2K, RGBA & 10-Image Workflows» — Veteran AI / finales de septiembre de 2026 / https://www.youtube.com/watch?v=fwHS0ubmI7I — explicación del flujo de trabajo de Qwen-Image-2.1 en ComfyUI. Se estructura alrededor de la afirmación de que supera a Nano Banana 2.0 (cerrado) en un benchmark propio (también citado por Tom's Hardware como Qwen Image Benchmark 60.2 frente a 59.82 de Nano Banana 2.0).
-
«Alibaba Open-Sources Qwen-Image-2.1, A 7B Model With Native Transparency» — Daily AI Roundup / finales de septiembre de 2026 / https://www.youtube.com/watch?v=cdZ4E7_kiJY — cobertura de última hora de la apertura de Qwen-Image-2.1. Su principal atractivo es la transparencia nativa (canal alfa).
-
«Master LTX 2.5 in ComfyUI: Multi-Shot, First-Last Frame & 2K Workflows» — Veteran AI / mediados de agosto de 2026 (los resultados de búsqueda indicaban unos 40–48 días desde la publicación) / https://www.youtube.com/watch?v=6B9WSxi6j8E — guía práctica para usar el modelo de vídeo totalmente abierto LTX 2.5 con ComfyUI. Explica flujos de trabajo de planos múltiples, especificación de primer/último fotograma y salida 2K.
-
«LTX 2.5 is a New Free and Opensource AI Video Model that is Insanely Fast in Generation» (Shorts) — mediados de agosto de 2026 / https://www.youtube.com/shorts/h8qy-MBDzho — presenta brevemente la velocidad de generación de LTX 2.5.
-
«使わにゃ損損!お得に生成するならComfyUI一択!2026年おすすめ生成モデルベスト!» — AIで創作効率化とマネタイズby呪喝蛙 / 2026 (los resultados mostraban unos 172 días desde su publicación; algo más antiguo) / https://www.youtube.com/watch?v=qmiPya-U2KM — vídeo de resumen de modelos ComfyUI de código abierto que abarca imagen, vídeo, música, voz y 3D.
-
«【ドS課金して判明】2026年おすすめ画像生成AIはコレ!NanoBananaPro・Seedream4.0・Midjourney・AdobeFireflyを徹底比較します!» — 動画編集の中の人 / 2026 (reciente, sin fecha concreta confirmada) / https://www.youtube.com/watch?v=vJLDbXaSKW4 — comparativa de cuatro servicios cerrados (Nano Banana Pro, Seedream 4.0, Midjourney y Adobe Firefly) tras pagar y probarlos realmente.
-
«【画像生成AIの頂点】Google最新の画像生成AI「Nano Banana 2(ナノバナナ)」を無料で使い倒す!最短スタート完全ガイド!» — AI大学【AI&ChatGPT最新情報】/ 2026 (Nano Banana 2 se lanzó entre 2026-02-26 y 27, y el vídeo siguió recibiendo visualizaciones posteriormente) / https://www.youtube.com/watch?v=Asuw6jHVcSs — guía para principiantes sobre cómo empezar gratis con Nano Banana 2 (Pro), basado en Gemini 3 Pro.
-
«【Google Flow完全ガイド】無料で使えるAI映像制作ツールが超進化!Gemini Omni Flash・ナノバナナを使って動画や画像を作れる!» — AI大学【AI&ChatGPT最新情報】/ desde mayo de 2026 (menciona la adición de Gemini Omni Flash) / https://www.youtube.com/watch?v=dBFK1yFJXOA — explica las últimas mejoras de Flow, la herramienta integrada de código cerrado de Google. Presenta que permite trabajar con generación de imágenes de la familia Nano Banana y generación de vídeo de la familia Veo en una misma herramienta.
-
«最新動画生成AI「Sora2」リアルな映像が約3分で生成可能に…実演でわかったその性能 一方で著作権への懸念も【news23】» — TBS NEWS DIG / 2026 (especial de televisión sobre Sora 2) / https://www.youtube.com/watch?v=_r9hojDlABM — contenido periodístico que demuestra Sora 2, de código cerrado, y aborda las preocupaciones sobre infracción de derechos de autor. Según otra investigación, OpenAI anunció el fin de Sora el 24 de marzo de 2026, cerró la aplicación y la versión web el 26 de abril, y se esperaba que la API de Sora 2 terminara el 24 de septiembre de 2026; se observa que Sora, del lado cerrado, se encaminó a su final apenas medio año después de esta noticia.
Señales
- Impulso del código abierto: Qwen-Image-2.1 (Alibaba, lanzado el 2026-09-20, 7B parámetros, transparencia nativa y hasta 10 imágenes de referencia) fue cubierto inmediatamente por varios canales. La afirmación de benchmarks propios que lo sitúan al nivel o por encima de una gran plataforma cerrada (Nano Banana 2.0) es el centro de su difusión. También continúan apareciendo comparativas de modelos de vídeo gratuitos que funcionan localmente, como LTX 2.5 y HunyuanVideo/Wan, y ComfyUI es de facto la plataforma compartida.
- Movimiento del código cerrado: los productos de Google (Nano Banana 2 / Nano Banana Pro, Gemini Omni Flash y Flow) son protagonistas recurrentes en canales japoneses. Por su parte, Sora de OpenAI atrajo atención a principios de 2026, pero avanzó hacia un apagado gradual entre marzo y septiembre del mismo año (fin de web/app → fin de API); en este contexto, se habla de la subida y caída de grandes compañías cerradas como «muy fuerte al salir, pero con dudas sobre su continuidad».
- Distribución por idioma: los canales japoneses (AI大学, 動画編集の中の人, 呪喝蛙) abundan en comparativas y guías prácticas de código cerrado; los canales en inglés (Veteran AI, AI WITH Rithesh, Daily AI Roundup y MaxonShire) abundan en explicaciones de flujos ComfyUI y noticias rápidas de benchmarks de modelos abiertos.
Límites
- Las páginas de vídeo y de búsqueda de YouTube (
/watch,/results) solo devolvieron HTML estático con enlaces de navegación del pie al usar WebFetch; no se pudieron obtener directamente elementos renderizados dinámicamente como visualizaciones, likes, suscriptores y comentarios. - Como alternativa, solo se complementaron título y canal mediante la API oEmbed de YouTube (
/oembed?url=...&format=json); las visualizaciones y fechas de publicación se basan en fragmentos de resultados de búsqueda («hace X días»). Por tanto, algunas fechas son aproximadas (por ejemplo, «unos 40–48 días», «unos 172 días»), y no se verificaron fechas o visualizaciones exactas. - Algunos ID de vídeo (por ejemplo,
yVMs1Z-FWmQ, un vídeo en ruso03MX2U8ZLDky otro en españoljH0AjVP49KI) aparecieron en los resultados, pero se dejó su comprobación detallada en menor prioridad por idioma y relevancia. - No se pudieron obtener los comentarios principales, ya que WebFetch no renderiza la sección de comentarios.
Bluesky
Bluesky — Noticias de IA de generación de imágenes y vídeo
Nota sobre el método de recopilación
El endpoint indicado en el playbook, https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts?q=...,
devolvió HTTP 403 en todas las pruebas con consultas como Midjourney, "Stable Diffusion" y cat, por
lo que no se pudo usar (la versión web de bsky.app/search también es una SPA renderizada con JS y no permitió
obtener el contenido). En cambio, app.bsky.actor.getProfile, app.bsky.feed.getAuthorFeed y
app.bsky.unspecced.getTrendingTopics funcionaron correctamente. Por ello, se identificaron cuentas que parecían
relevantes mediante WebSearch y se leyó directamente getAuthorFeed de cada una. Los detalles se indican en
## Límites.
Cuentas
-
dfl.bsky.social (DFL inc.)
https://bsky.app/profile/dfl.bsky.social
Cuenta individual que publica casi a diario imágenes de IA estilo fotografía de paisajes japoneses generadas con «Nano Banana 2» de Google. Seguía activa en septiembre de 2026 y fue la cuenta de uso práctico de modelos cerrados más continuamente observable. -
doctordiffusion.bsky.social
https://bsky.app/profile/doctordiffusion.bsky.social
Creador de código abierto que produce LoRA y modelos para Stable Diffusion 3.5, Flux Dev, HunyuanVideo y LTX-Video, y los distribuye en Civitai y Hugging Face. Sin embargo, sus publicaciones se detuvieron entre noviembre de 2024 y marzo de 2025, y no se confirmó actividad en 2026. -
emanuelmaiberg.bsky.social (Emanuel Maiberg, periodista de 404 Media)
https://bsky.app/profile/emanuelmaiberg.bsky.social
Investiga y publica continuamente sobre abusos de IA de generación de imágenes/vídeo, como deepfakes, imágenes generadas sin consentimiento y suplantaciones de celebridades con música de IA. Siguió publicando en agosto y septiembre de 2026, y es una de las cuentas más establemente relacionadas con el tema en Bluesky. -
midjourneyofficial.bsky.social (Midjourney oficial)
https://bsky.app/profile/midjourneyofficial.bsky.social
Anunció su entrada en Bluesky en agosto de 2025, pero la publicación más reciente se detuvo el 8 de octubre de 2025 y no se confirmó actividad en 2026. Es un ejemplo de la baja actividad de empresas oficiales de código cerrado en Bluesky. -
stablediffusion.bsky.social («Stable Diffusion online AI»)
https://bsky.app/profile/stablediffusion.bsky.social
Cuenta comunitaria de arte de IA con unos 1.800 seguidores. Las publicaciones llegaron hasta febrero de 2025 y no se confirmaron actualizaciones posteriores. -
wagahai-ai.bsky.social
https://bsky.app/profile/wagahai-ai.bsky.social
Cuenta individual japonesa que publica ilustraciones y vídeos de IA. También dejó de publicar después de enero de 2025.
Publicaciones
-
@dfl.bsky.social — 2026-09-30, 14 likes, 1 repost
https://bsky.app/profile/dfl.bsky.social/post/3mwr727gyck26
«AI image generation #Nano Banana 2 ... un canal con reflejos dorados». Paisaje japonés generado con el modelo cerrado de imágenes de Google, «Nano Banana 2». -
@dfl.bsky.social — 2026-09-25, 51 likes, 2 reposts (la mayor interacción entre las 20 publicaciones recientes)
https://bsky.app/profile/dfl.bsky.social/post/3mwesrcxg5k2c
«#Nano Banana 2 ... una amplia vista ribereña, muros de piedra y casas japonesas al fondo». -
@dfl.bsky.social — 2026-09-21, 45 likes, 2 reposts
https://bsky.app/profile/dfl.bsky.social/post/3mw2ny6hsa22p
«#Nano Banana 2 ... un viejo puente de madera, un arroyo y un fresco crepúsculo». Se confirma un ritmo de publicación diaria y reacciones estables de 30 a 50 likes. -
@doctordiffusion.bsky.social — 2025-01-19, 3 likes, 4 respuestas
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x
«¡SD3.5 vive! Lanzamiento de Absynth 2.0». Distribución gratuita en Civitai/Hugging Face de una versión afinada de Stable Diffusion 3.5 Large. Un lanzamiento de base muy propio del código abierto. -
@doctordiffusion.bsky.social — 2025-01-01, 1 like, 2 respuestas
https://bsky.app/profile/doctordiffusion.bsky.social/post/3leofdsx6yc23
Comparte con la etiqueta #opensource el hallazgo técnico de que el entrenamiento se estabilizó mediante la alineación del text encoder de Flux Dev y Stable Diffusion 3.5. -
@doctordiffusion.bsky.social — 2024-11-26, 4 likes
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lbssdeocz226
«Extender vídeo con Img2Vid de LTX-Video y nodos personalizados en ComfyUI». Ejemplo práctico de combinar generación de vídeo de código abierto (LTX-Video/Mochi) en ComfyUI. -
@emanuelmaiberg.bsky.social — 2026-08-20, 14 likes, 6 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtjegiaxpk2h
Reportaje de 404 Media sobre cómo las imágenes generadas por IA sin consentimiento se vuelven cada vez más sutiles y difíciles de detectar. -
@emanuelmaiberg.bsky.social — 2026-08-17, 36 likes, 9 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtbvku5wds2p
Debate con el investigador de deepfakes Hany Farid en un pódcast sobre el «pasado, presente y futuro» de los medios sintéticos. -
@midjourneyofficial.bsky.social — 2025-08-15, 41 likes, 4 reposts, 14 respuestas
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
«#Midjourney is now on BlueSky! Who are the best creators we should follow?» Primer mensaje de la cuenta oficial al entrar en Bluesky. Después solo hubo publicaciones esporádicas hasta octubre de 2025.
Señales
- Las voces sobre «IA» en Bluesky se inclinan hacia LLM y agentes, más que hacia generación de imágenes/vídeo. Se revisaron publicaciones recientes de septiembre de 2026 de voces de IA con decenas de miles de seguidores, como Tim Kellogg (@timkellogg.me) y Ethan Mollick (@emollick.bsky.social), pero se centraban en GPT-6.1, Gemini 4 y funciones de agentes de Claude, sin ninguna mención de modelos como Midjourney, Stable Diffusion, Sora, Wan o Kling.
- Los ejemplos de código cerrado aparecen como uso cotidiano de personas, no como cuentas oficiales de empresas. La cuenta oficial de Midjourney está casi silenciosa; en cambio, cuentas como dfl.bsky.social continúan publicando tranquilamente cada día obras creadas con Nano Banana 2 de Google.
- La comunidad de creadores de código abierto (distribución de LoRA y flujos de ComfyUI) ya está en declive en Bluesky. doctordiffusion, wagahai-ai y stablediffusion dejaron de actualizarse en la primera mitad de 2025; es posible que su última fase de actividad intensa fuera entre finales de 2024 y comienzos de 2025.
- El eje que mantiene publicaciones más constantes sobre IA de generación de imágenes/vídeo es la crítica y el periodismo. El periodista Emanuel Maiberg de 404 Media siguió publicando sobre deepfakes e imágenes generadas sin consentimiento en agosto y septiembre de 2026; fue lo que más sensación de actualidad transmitía en Bluesky.
- De ello se desprende que Bluesky no es un foco principal de difusión para este tema (noticias de IA de generación de imágenes y vídeo de código cerrado/abierto). Como en X, hubo pocas publicaciones actuales directamente ligadas al tema.
Límites
app.bsky.feed.searchPosts(la API pública de búsqueda) devolvía siempre HTTP 403. Con «Midjourney», «"Stable Diffusion"» y «cat» devolvía 403, aparentemente bloqueando sin importar el contenido deq.app.bsky.unspecced.searchPostsSkeletondevolvía HTTP 501. En cambio,getProfile,getAuthorFeedygetTrendingTopicsrespondían correctamente. Es decir, la API pública de Bluesky deja abiertos endpoints de lectura, pero desde este entorno bloquea el endpoint de búsqueda de texto completo.- La versión web de
bsky.app/searchtambién es una SPA renderizada en JavaScript, por lo que WebFetch no pudo obtener el texto de las publicaciones (solo devolvía cadenas de título). - Por ello, no se pudo recopilar publicaciones mediante búsquedas por palabras clave como indicaba el playbook y se recurrió a descubrir cuentas mediante WebSearch y leer individualmente sus
getAuthorFeed. Este método lee con precisión las publicaciones recientes de cuentas encontradas, pero no permite una visión exhaustiva transversal de cuántas publicaciones sobre este tema existen en toda la plataforma. - Las publicaciones relevantes de sungkim.bsky.social y ekazakos.bsky.social sobre MiniMax H3 (modelo de vídeo de pesos abiertos), detectadas por WebSearch, no aparecieron al retroceder mediante
getAuthorFeeddentro de las 30 publicaciones recientes (eran de finales de julio de 2026 y quedaban fuera de las 30 más recientes a finales de septiembre). Por ello no se incluyeron, priorizando la regla de adoptar solo aquello que realmente se pudo leer en esta ejecución. - doctordiffusion.bsky.social, wagahai-ai.bsky.social y stablediffusion.bsky.social eran las cuentas más directamente relacionadas con el tema entre las encontradas, pero todas dejaron de estar activas en la primera mitad de 2025 y no pueden tratarse como noticias recientes a septiembre-octubre de 2026. Las únicas cuentas temáticas esencialmente activas identificadas fueron dfl.bsky.social (uso práctico de código cerrado) y emanuelmaiberg.bsky.social (periodismo crítico).
- No se alcanzó el objetivo de «analizar unas 20 publicaciones». Sin búsqueda de texto completo, solo se pudieron identificar una docena larga de publicaciones relevantes, de las cuales cerca de la mitad eran de 2024–2025. La conclusión honesta es que Bluesky tiene menos que decir sobre este tema que otras plataformas.
Lemmy
Lemmy — Noticias de IA de generación de imágenes y vídeo (código cerrado/abierto)
Fecha de investigación: 2026-10-01. Se usaron la búsqueda de la API de Lemmy (/api/v3/search) y la API de listados de publicaciones de comunidades para realizar búsquedas transversales en comunidades como stable_diffusion, imageai, fuck_ai, technology, y con términos como FLUX.2 / Qwen-Image / Nano Banana / Midjourney / Grok Imagine / Sora / Veo / Kling.
Comunidades
- !«メールアドレス» — 5.713 suscriptores / 1.423 publicaciones. La comunidad más activa de Lemmy para información técnica de IA de generación de imágenes/vídeo (flujos de ComfyUI, LoRA y modelos nuevos). Aquí también se anuncian novedades de AI Horde, el proyecto distribuido y gratuito de generación de imágenes operado por dbzer0.
- !«メールアドレス» — 8.532 suscriptores / 4.680 publicaciones. Espacio para publicar imágenes generadas por IA sin importar el modelo. Se centra más en obras que en noticias y destacan publicaciones con puntuación negativa, mostrando la actitud fría de Lemmy en general hacia las creaciones de IA.
- !«メールアドレス» — 8.333 suscriptores. Comunidad que comparte artículos de crítica a la industria desde una postura anti-IA. Las noticias de polémicas y litigios de empresas cerradas tienden a concentrarse aquí.
- !«メールアドレス» — comunidad tecnológica generalista. Las grandes noticias de código cerrado, como el caso de Google Earth, alcanzaron aquí sus puntuaciones más altas.
- !«メールアドレス» — 53 suscriptores. Comunidad bot que republica mecánicamente el RSS de Reddit (r/ArtificialIntelligence); no constituye debate propio de Lemmy.
Publicaciones
Orientadas al código abierto (todas en !«メールアドレス»)
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image… — 2026-09-22, score 13.
Artículo de blog.comfy.org que informa de la compatibilidad con ComfyUI de Qwen-Image-2.1, el modelo de imágenes de pesos abiertos de Alibaba. Fue la publicación con mayor puntuación de esta investigación. - WebUI for qwen-image-2.1 — 2026-09-27, score 2. Proyecto que adapta una WebUI ligera tipo Fooocus a Qwen-Image-2.1.
- Few-step LoRA adapters for Qwen-Image-2.1 — 2026-09-26, score 0. LoRA que acelera la generación reduciendo los pasos.
- Long, seamless multi-shot video continuations — 2026-09-29, score 4. Flujo de trabajo de generación de vídeo que usa MiniMax-H3-Latent para enlazar varios planos sin cortes visibles.
- Free, local, open source video editor with AI — 2026-09-29, score 5. Herramienta de edición de vídeo con IA que funciona íntegramente en local, «vlo».
- LanPaint — training-free inpaint for every model — 2026-09-29, score 8. Método que añade inpainting de alta calidad a modelos existentes sin entrenamiento adicional.
- Tiny 100M-parameter text-to-image model (Supra2-IMG) — 2026-09-22, score 7. Modelo text-to-image ultraligero que funciona con poca VRAM.
- AI Horde — New Interface & Documentation — 2026-09-19, score 8. Anuncio de renovación de la interfaz y documentación del servicio distribuido y gratuito de generación de imágenes operado por dbzer0.
Orientadas al código cerrado
- Google Earth's new AI image generation function didn't survive a day after users deepfaked disasters — 2026-08-01, score 473 (!«メールアドレス»). El caso en el que la función de IA integrada de Google Earth basada en Nano Banana (Gemini) se detuvo antes de durar un día debido a la creación maliciosa de imágenes falsas de desastres. Una de las puntuaciones más altas observadas en toda la investigación.
- Tennessee Teens Sue Elon Musk's xAI Over Child Sexual Abuse Images — 2026-03-17, score 13 (comunidad Mother Jones). Demanda relacionada con imágenes de abuso sexual infantil generadas por Grok Imagine de xAI. Se señala que se generaron unas 23.000 imágenes de este tipo en 11 días.
- Disney, Universal sue image creator Midjourney for copyright infringement — 2025-06-11, score 88 (!«メールアドレス»). Aunque es algo antigua, la demanda por derechos de autor contra Midjourney sigue mencionándose como noticia de contexto de un litigio en curso.
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — 2026-09-14, score 1 (a través de !«メールアドレス»). Espejo de un hilo de Reddit que compara coloreado automático de manga con varios modelos, incluido Nano Banana Pro. No es una publicación original de Lemmy.
Señales
- El código abierto es prácticamente monocromático: el ecosistema ComfyUI. Se publican a diario flujos derivados, LoRA y extensiones de nodos de FLUX.2 (Black Forest Labs) y de la familia Qwen-Image (Alibaba, en particular 2.1), con una frecuencia y concreción técnica claramente superiores a cualquier otra área de Lemmy. Las referencias a infraestructura gratuita y distribuida como AI Horde de dbzer0 encajan bien con el clima anticomercial y autosuficiente de Lemmy.
- La generación de vídeo sigue siendo un nicho dentro del nicho. Las publicaciones de vídeo, como MiniMax-H3 o herramientas locales de edición creadas por la comunidad, son menos numerosas que las de imagen y tienen puntuaciones modestas (aproximadamente 4–8 puntos).
- Las noticias de código cerrado entran no por presentación de funciones, sino por polémicas y demandas. Google Earth (Nano Banana), Grok Imagine y Midjourney llegaron a !technology o !fuck_ai en el momento de abusos y litigios, no por los anuncios de funciones, y alcanzaron puntuaciones altas. La publicación de Google Earth (score 473) sobresale incluso dentro de toda la investigación.
- La mirada hacia las obras de IA es generalmente fría. En !«メールアドレス», cerca de la mitad de las publicaciones tienen puntuaciones negativas (-18 a -3), de modo que el mero hecho de ser «arte de IA» parece penalizarse. La existencia de !fuck_ai (8.333 personas) también ilustra el ambiente de la comunidad de Lemmy.
Límites
- Lemmy es pequeño y no se encontró una comunidad dedicada a IA de generación de imágenes/vídeo de código cerrado que fuera simétrica a !stable_diffusion, orientada al código abierto. Por eso los hallazgos sobre código cerrado se limitan a comunidades generales como !technology y !fuck_ai.
- Se buscaron «Veo 3» y «Kling AI», pero no se encontraron publicaciones sustanciales de Lemmy (solo resultados irrelevantes). Sobre Sora solo apareció aproximadamente una mención dentro de un meme, no un debate sobre el modelo de vídeo en sí.
- La obtención directa de la página de comunidad
lemmy.world/c/stablediffusionfalló con error 500 (se sustituyó con datos de búsqueda de API). La consulta alemmy.today/api/v3/communitytambién devolvió 404, y llevó tiempo identificar que la instancia principal real era lemmy.dbzer0.com. - !«メールアドレス» es una comunidad bot de 53 personas que republica el RSS de Reddit, no debate original de Lemmy. Solo se incluyó un elemento como referencia.
- No se encontraron comunidades ni publicaciones japonesas de Lemmy dentro del alcance de la búsqueda.
- Esta fase se centró solo en Lemmy y, respecto al criterio de unas 20 publicaciones analizadas por red social, se revisaron más de 60 publicaciones/comentarios mediante búsquedas de API y listados de comunidades, y se seleccionaron las 11 representativas anteriores.
Pinterest — Noticias de IA de generación de imágenes y vídeo
El worker recopiló 50 pines para la consulta "Image and Video Generation AI News" (sin división por géneros; un único lote). Se abrieron y revisaron los 50.
Temas visuales
- Androide humanoide cromado/blanco como «rostro de la IA» — ojos azules brillantes, articulaciones metálicas expuestas y, a veces, traje. Se usa para todo: explicadores genéricos, contenidos de presentadores de noticias y ética. [1, 16, 19, 20, 24, 29, 30, 35, 45]
- Fondo azul marino/negro oscuro con brillo neón cian-púrpura de circuitos — paleta predeterminada de miniaturas de explicadores y listicles de IA; cerebro con circuitos o logotipo luminoso «AI» como icono central. [2, 9, 14, 21, 28, 33, 40, 42, 50]
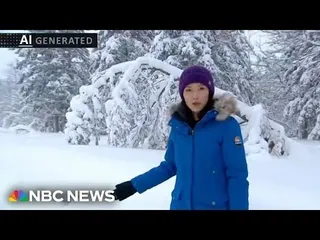
- Ansiedad de «la IA reemplaza a periodistas / noticias falsas» — presentadores de IA en mesas de noticias, sellos «FAKE», UI de detección de deepfakes y logotipos reales de emisoras (NBC) con marca «AI GENERATED». [1, 6, 23, 31, 35, 36, 44]
- Gráficos de dicotomía humano frente a IA — manos divididas en pantalla (dedos humanos frente a dedos robóticos), lupa sobre un teclado y rótulos «Human or AI?». [30, 31]
- Imágenes distópicas/de IA villana — un demonio de IA con cuernos y ojos rojos controla como marionetas a zombis con teléfonos; se usa para titulares de miedo («AI is getting scary good»). [17, 23]
- Listicles de herramientas y gráficos comparativos — productos reales con nombre (Runway, Pika, Kling AI, Luma/Dream Machine, Canva AI, Hailuo, Midjourney, Adobe Firefly, Recraft, Kaiber, Ideogram, SeaArt, Krea) dispuestos en infografías de «mejores de pago frente a mejores gratis» o «más de 6 mejores webs». [5, 15, 40]
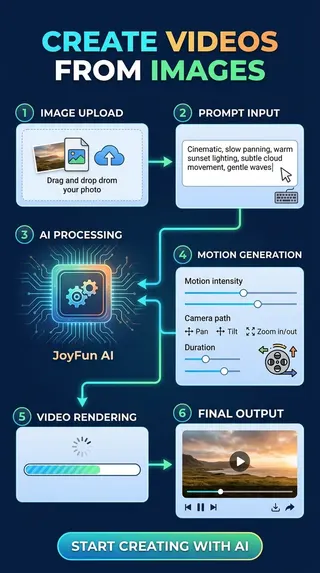
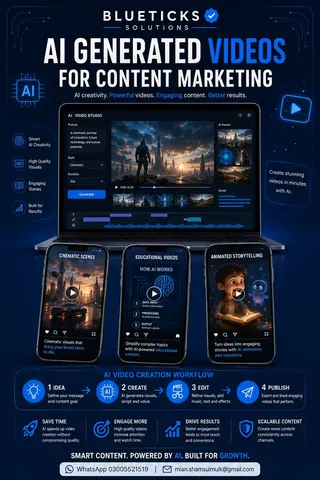
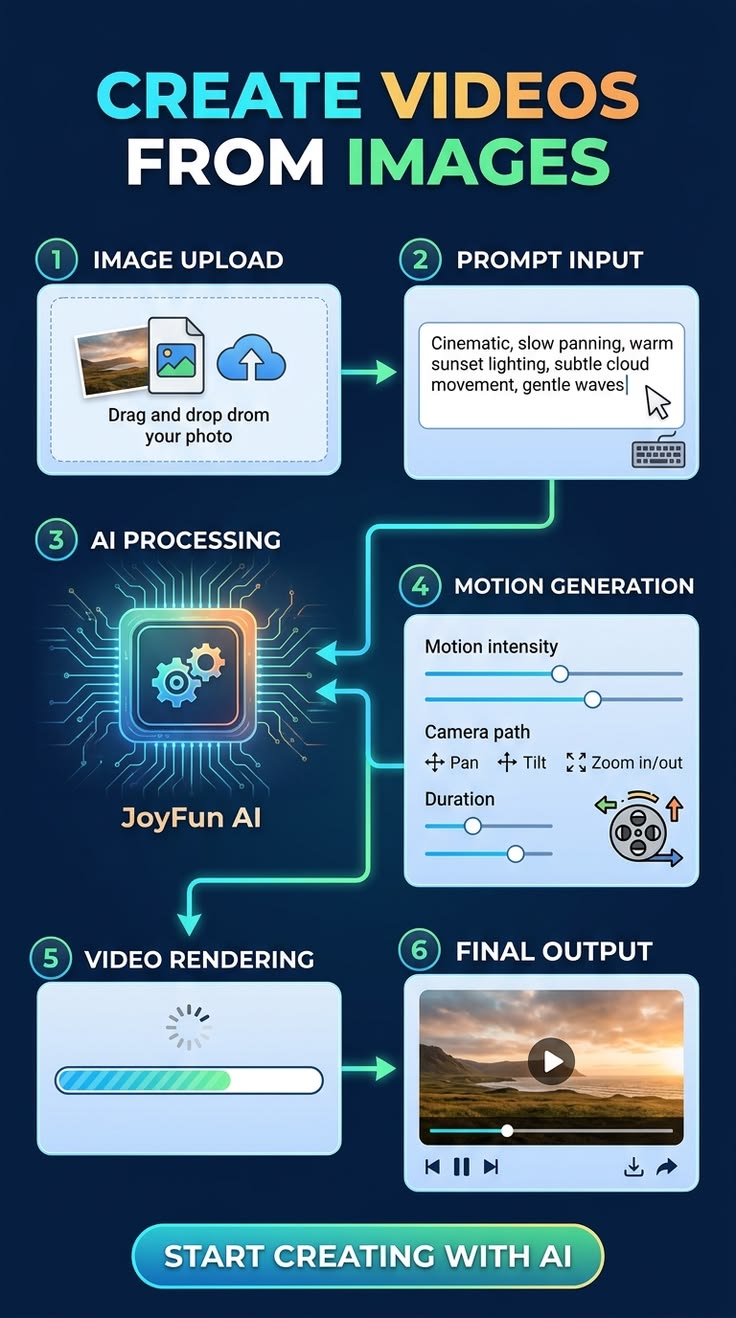
- Capturas de demostraciones reales de producto — maquetas de UI paso a paso para flujos image-to-video (subir → prompt → controles de movimiento → renderizar) de pequeñas herramientas SaaS (JoyFun AI, Blueticks). [8, 10]
- Demostraciones de transformaciones fotorrealistas/estilizadas — una foto fuente convertida lado a lado en versiones de bloques de madera, origami, Lego, flores y bloques de juguete (Lumalabs), además de una imagen compuesta de una estatua de mármol tocando violonchelo y el retrato de un pescador atribuido a AMD/«Amuse 3.0». [4, 15, 38]
- Collages de marketing de grandes modelos — Google Veo 2 (el mismo collage promocional oficial reutilizado en dos pines no relacionados), Gemini Omni «convierte cualquier cosa en vídeo», Meta «Muse Spark» como modelo de 2026. [17, 24, 32, 3]
Pines destacados
- Preocupaciones sobre contenido de IA y redes sociales [1] — robot desplazándose por un teléfono junto a un sello «FAKE» y una sospechosa foto de gato; cebo clásico de ansiedad por deepfakes.
- Meta Unveils Muse Image and Muse Video Generative... [3] — presenta un modelo «Muse Spark» de 2026 como jugada de asistente personal/«superinteligencia», no solo como herramienta de contenidos.
- (sin título, cuadrícula de transformaciones de Lumalabs) [4] — un vídeo fuente transformado en versiones de bloques de madera, origami, ladrillos Lego y flores de una persona, un perro y un coche; la demostración real de capacidad de antes/después más clara del conjunto.
- Create Videos From Images [8] — maqueta completa de UI en 6 pasos (subir → prompt → procesamiento de IA → controles de movimiento → renderizar → salida) para una herramienta llamada «JoyFun AI».
- Transform your ideas into stunning visuals! [15] — estatua hiperrealista de mármol tocando un violonchelo, utilizada como imagen de muestra de generación de imágenes.
- (sin título, promoción de Veo 2) [17] — collage oficial de lanzamiento de Google «Veo 2: our state-of-the-art video generation model» (perro nadando, flamencos, chica animada); la misma imagen se reutiliza literalmente bajo el texto diferente del pin 32.
- Google's Gemini Omni Turns Anything Into Video [24] — «cualquier entrada → cualquier salida», presentado como la gran afirmación de generalización de Google para generación de vídeo.
- 'Amuse 3.0', an AI art creation tool that includes... [38] — retrato fotorrealista de un pescador anciano, con marca AMD, que sugiere el ángulo de una herramienta local de generación de imágenes acelerada por hardware.
- Introducing Luma Dream Machine [43] — primerísimo plano de un ojo sobre el logotipo «Dream Machine», imagen de marca pura en vez de captura de producto.
- AI NEWS: May 20 2026 Google I/O recap infographic [35] — Gemini 3.5 Flash, Gemini Omni, Gemini Spark y gafas Android XR, presentados como «el mayor evento de IA»: un resumen de noticias fechado y concreto, en lugar de contenido de listicle atemporal.
Señales
- El conjunto se inclina de forma marcada hacia contenido de miniaturas SEO/blog (robots de stock, logotipos genéricos de «AI News», listicles de herramientas), que domina en volumen frente a demostraciones genuinas de arte o producto.
- La ansiedad por deepfakes/desinformación y por «la IA sustituyendo a periodistas» es un hilo narrativo claro y recurrente, no un caso aislado: aparece en al menos 7 de los 50 pines, a menudo acompañado de marcas de emisoras reales (NBC) o sellos «FAKE».
- Herramientas reales y con nombre aparecen repetidamente en listicles y demostraciones: Veo 2/Gemini Omni (Google), Dream Machine/Luma, Runway, Pika, Kling AI, Canva AI, Hailuo, Amuse 3.0, Meta Muse Spark, pero en su mayoría como logotipos o collages de marketing y rara vez como capturas de flujos prácticos (JoyFun AI y Blueticks son las dos excepciones).
- Ausencias: no hay nombres visibles de modelos de código abierto ni capturas de herramientas locales (sin ComfyUI, Automatic1111, Stable Diffusion UI ni conversación sobre checkpoints/LoRA), aunque «Stable Diffusion» aparece una vez en el título de un pin sin captura correspondiente; tampoco hay contenido comunitario de arte de IA de estilo anime/ilustración, ni demostraciones de vídeo narrativo multishot o consistencia más allá de la cuadrícula de transformaciones de Lumalabs.
- La misma imagen oficial de marketing de Veo 2 se encontró reutilizada en dos pines con texto circundante diferente [17, 32], señal de que el rincón de noticias de IA de Pinterest es en parte contenido reciclado/agregado, no comentario original.
Límites
- Según el playbook, Pinterest no se navegó directamente: los hallazgos son una lectura visual de los 50 pines e imágenes que el worker ya había recopilado en
output/pinterest.pins.mdeimages/pinterest/. - La tabla de pines no tiene secciones de género (un único lote sin etiqueta), por lo que los temas anteriores se extraen del conjunto completo y no género por género.
- Varios pines se titulan «(untitled)» y solo contienen arte de stock genérico, sin fuente atribuible más allá de la URL del pin ni forma de confirmar fecha de publicación o interacción.
- Los títulos e imágenes presentan marcas y afirmaciones de titulares (por ejemplo, «Grok está revolucionando el vídeo» o «GPT 5.2 ... control corporal completo»), pero las imágenes enlazadas son gráficos de stock genéricos y no capturas de la función o producto real; esas afirmaciones concretas no se pudieron verificar solo con la imagen.
Acciones recomendadas
- Volver a recopilar la fase de X con palabras clave directamente conectadas con el tema (Midjourney, Sora, Stable Diffusion, Wan, Kling, etc.).
- Considerar cómo resolver el problema de que la API searchPosts de Bluesky devuelva 403 y buscar otro medio de búsqueda.
- Seguir observando la adopción de Qwen-Image-2.1 y LTX 2.5 como indicadores del lado de código abierto.
- Dar prioridad al seguimiento de noticias de abuso y polémica de empresas de código cerrado (Nano Banana/Google Earth, demanda de Grok Imagine).
- Ampliar el alcance de Reddit con varias consultas para llegar a unas 20 publicaciones, el criterio de finalización.
Imágenes recopiladas


































Nota sobre la calidad de los datos
X no obtuvo datos relevantes por un error en la selección de términos de búsqueda, por lo que en la práctica no hubo datos; Bluesky y Reddit tampoco alcanzaron el objetivo de unas 20 publicaciones. En cambio, Lemmy, Pinterest y YouTube revisaron un volumen razonablemente suficiente.