Noticias de IA de generación de imágenes y vídeo — 2026-09-28
OpenAI cerró Sora (aplicación y API) el 2026-09-24, iniciando una reconfiguración entre los actores de vídeo cerrados; mientras tanto, Qwen-Image-2.1, un ligero modelo de 7B, y Minimax H3 fueron confirmados independientemente como los principales candidatos abiertos en cuatro plataformas.
Resumen de noticias de IA de generación de imágenes y vídeo — 2026-09-28
¡Ey, gente, os he hecho esperar! El panorama de IA para imágenes y vídeo se movió muchísimo esta semana, así que aquí va el informe 🔥🔥 La mayor noticia fue que OpenAI cortó Sora (tanto la aplicación como la API) el 2026-09-24, haciendo que por fin aflorara la pregunta de «¿realmente es rentable?» para la IA de generación de vídeo. Por otro lado, el bando de código abierto tiene claramente a Alibaba Qwen-Image-2.1 (solo 7B, pero acercándose a grandes modelos cerrados 🐉) y Minimax H3 como protagonistas, y la comunidad parece aún más entusiasmada con ellos. Pero no todas las redes tienen el mismo ambiente: los espacios técnicos (r/StableDiffusion, la comunidad stable_diffusion de Lemmy y la gente de ComfyUI en YouTube) están animados con comparativas serias de herramientas, mientras que en los lugares de audiencia general (grandes subreddits de Reddit y Pinterest) se viraliza más la desconfianza de «¿estas imágenes de IA no están demasiado maquilladas?». Ese es el gran hallazgo de esta ocasión 🙌 Además, X fue inesperadamente un fracaso esta vez (explico la razón más adelante).
Across platforms
Hallazgos del lado de código cerrado (13 en total 📸)
- OpenAI cerró por completo Sora (aplicación + API para desarrolladores) el 2026-09-24. Se describe como una retirada bastante urgente — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- La explicación más aceptada es que «la economía unitaria de la generación de vídeo era demasiado mala» — Bluesky https://bsky.app/profile/richargh.de/post/3mhur4qo3vc2x
- También hay informes de que Wan 3.0 de Alibaba superó a Sora en los rankings de modelos de vídeo — YouTube https://www.youtube.com/watch?v=5Hb429VYNUU
- Llega GPT Image 2.5: añade dos modos, Flare (velocidad) y Sunburst (detalle), reduce la latencia a la mitad y mejora la fidelidad a imágenes de referencia — YouTube https://www.youtube.com/watch?v=QOfLgJ3TCrQ
- Midjourney incorporó una vista previa de estilo en vivo en su alfa y sigue actualizándose mensualmente de V8 a V8.1 y V8.2 — Bluesky https://gen-ai.news/stories/edit-updates-thumbnail-previews-and-more-20d5ed / YouTube https://www.youtube.com/watch?v=dvfH5HzCARY
- Adobe integró Photoshop, Lightroom, Firefly y Acrobat para poder usarlos directamente desde chats de Gemini/Claude — Bluesky https://gen-ai.news/stories/adobe-expands-its-ai-integrations-to-gemini-plus-further-powers-up-with-claude-6737b7
- Adobe completó la adquisición de Topaz Labs e integrará pronto su tecnología de escalado por IA en Firefly/Photoshop — Bluesky https://gen-ai.news/stories/adobe-s-acquisition-of-topaz-labs-is-complete-as-double-down-on-ai-enhancements--3c3f96
- OpenAI adquirió la startup de procesamiento fotográfico Glass Imaging por 300 millones de dólares, apuntando a la cadena desde la captura hasta la generación — Bluesky https://gen-ai.news/stories/openai-reportedly-buys-photo-processing-company-glass-imaging-for-300-million-e004d2
- «Dramagic» de ByteDance es un flujo completo que genera con IA el 95% de los dramas cortos chinos sin equipo humano — Bluesky https://gen-ai.news/stories/bytedance-launches-dramagic-a-full-pipeline-ai-platform-for-producing-short-dram-20f217
- Runway desarrolla los modelos de mundo en tiempo real GWM-1/GWM-2, que entienden continuamente un entorno en vez de generar clips aislados — Bluesky https://gen-ai.news/stories/runway-s-worldprompt-and-the-engineering-of-real-time-worlds-80e2b7
- Veo3 (a través de Gemini API) admite generación rápida de imagen a vídeo con audio nativo; Pinterest también está lleno de piezas promocionales — Pinterest https://www.pinterest.com/pin/871728071631063018/
- También es tema de conversación una comparación directa sin concesiones entre Kling 3.0, Grok Imagine, Runway Gen-4.5 y Veo 3.1 — YouTube https://www.youtube.com/watch?v=x5fMQvhKP60
- El público general tiende a consumir imágenes y vídeos de IA cerrada como «escándalos»: indignación por fotos inmobiliarias embellecidas con IA (27.008 pt) — Reddit https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ , un CEO despedido por una imagen de IA (594 pt) — Reddit https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ , y apoyo masivo a una ley de marcas de agua obligatorias para IA (13.925 comentarios) — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
Hallazgos del lado de código abierto (también van 12 🛠️)
- Alibaba publicó el modelo de pesos abiertos Qwen-Image-2.1 de 7B: generación y edición unificadas, capas transparentes y hasta 10 imágenes de referencia — Bluesky https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r 、Lemmy https://lemmy.dbzer0.com/post/75874773 、YouTube https://www.youtube.com/watch?v=3qGl0wiv2G0
- Incluso se afirma que Qwen-Image-2.1 supera en algunas tareas al enorme modelo cerrado de Google «Nano Banana 2.0» — YouTube https://www.youtube.com/watch?v=fwHS0ubmI7I
- Entre la gente de r/StableDiffusion, Krea 2 reemplazó a Z-Image Turbo como protagonista — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- En Lemmy se suceden las LoRA de aceleración para Krea2 (Turbo-Distill, inpaint-edit) — Lemmy https://lemmy.dbzer0.com (comunidad stable_diffusion)
- Minimax H3 se ha convertido en el principal frente abierto para generación de vídeo; cada semana aparecen más herramientas auxiliares como AutoContext, UI de control de cámara 3D, nodos de edición de línea de tiempo y LoRA TaoMate-H3 — Lemmy https://lemmy.dbzer0.com/post/75586069
- SenseNova-U1.5 se publicó con licencia Apache-2.0 y ya está incorporado en ComfyUI — Reddit r/StableDiffusion(hilo 11)
- LTX-2.5 llega como modelo rápido de vídeo de pesos abiertos y compite en velocidad con MiniMax H3 y Seedance 2.5 — YouTube https://www.youtube.com/watch?v=qVGpyw-F-rw
- Wan 3.0 por ahora solo está disponible mediante API/beta pública y aún no tiene pesos abiertos (la antigua línea Wan2.x sí); Alibaba mantiene abiertas ambas opciones, abierta y cerrada — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
- SupraLabs/Supra2-IMG, un modelo text-to-image ultraligero de apenas 100 millones de parámetros, genera conversación por su «calidad puntera para su tamaño» — Lemmy https://lemmy.dbzer0.com/post/75874769
- Llega well9472/Nanosaur2-670M, un modelo DiT especializado en ilustración entrenado por solo 600 dólares — Lemmy https://lemmy.dbzer0.com/post/76110122
- AI Horde (servicio distribuido y gratuito de generación de imágenes) se renovó por completo con nueva UI y nuevo backend — Lemmy https://lemmy.dbzer0.com/post/75736717
- «Amuse 3.0» de Stability AI, una herramienta local de generación de imágenes patrocinada por AMD, también se presenta en Pinterest — Pinterest https://www.pinterest.com/pin/4601060441986715264/
Qwen-Image-2.1 y Minimax H3 llevan a la misma conclusión de forma independiente en cuatro plataformas — Reddit, Lemmy, Bluesky y YouTube—: son los modelos abiertos más prometedores del momento. Eso les da una credibilidad muy alta 🙆
Platform by platform
Reddit: Una única consulta solo recuperó 12 hilos, pero su calidad fue alta. En las conversaciones técnicas de r/StableDiffusion se nombró a Krea 2, Qwen-Image 2.1 y Minimax H3 como ganadores actuales; en grandes subreddits generales como r/mildlyinfuriating y r/CriticalState se hicieron virales, a una escala completamente distinta, polémicas del tipo «la IA exageró» o «la IA mintió» (de miles a más de 10.000 pt). El máximo de las conversaciones técnicas fue 13 pt, mientras que la sospecha de fraude de Nikon Small World obtuvo 1.104 pt. Esa diferencia de temperatura refleja tal cual la distinta recepción de lo abierto y lo cerrado.
X: Esta vez fue casi un fracaso total para el tema 😅 La conexión de la sesión se geolocalizó en Croacia, y se buscaron tal cual las palabras de tendencia de Explore (criptomonedas, spam de sorteos, fandom de F1, debates sobre la antigua Yugoslavia, fotos turísticas y Taylor Swift). Como resultado, ninguno de los 40 posts contenía «IA», «generación de imágenes» o «generación de vídeo». Se cumplió el objetivo de cantidad (20), pero la tasa de relevancia temática fue del 0%.
YouTube: Once vídeos de reseña cubrieron lanzamientos principales como GPT Image 2.5, Qwen-Image-2.1, LTX-2.5 y Wan 3.0. En el código abierto abundan los vídeos de configuración de ComfyUI que verifican «qué tan rápido corre en mi GPU», mientras que en el cerrado se asentó un formato de seguimiento periódico, como los vídeos mensuales de actualizaciones de Midjourney. Sin embargo, no se pudieron recuperar muchas visualizaciones ni nombres de canales, por lo que no fue posible medir el tamaño de cada tema.
Bluesky: La cuenta automática de noticias gen-ai.news fue el núcleo de las fuentes en esta ocasión, y la densidad del lado cerrado es muy alta: Runway, Adobe, Midjourney, OpenAI, Meta y ByteDance anuncian algo casi a diario. El post sobre el cierre de Sora (3.571 me gusta) fue el mayor pico de esta etapa. Del lado abierto, salvo Qwen-Image-2.1 (82 me gusta), predominaron publicaciones antiguas de la primera mitad de 2025; apenas se encontraron posts personales recientes sobre Wan/LTX.
Lemmy: !«メールアドレス» es el único hub realmente sustancial. Las novedades de herramientas ComfyUI alrededor de Qwen-Image-2.1 y Minimax H3 llegan casi a diario, en un estado de «colección de enlaces nuevos de GitHub/HuggingFace». No hay comunidades dedicadas al lado cerrado; las polémicas —retoques raciales de Stanford, imágenes satelitales falsificadas de Google Earth y anuncios de apps nudify de Meta— llegan de forma aislada a comunidades generales como technology, nottheonion y dcstudios.
Pinterest: Un espacio estrictamente visual sin cifras de interacción. De los 50 pines recopilados, las miniaturas con logotipos de productos cerrados como Veo3, Kling AI, Luma Dream Machine y Gemini Omni acaparan casi todo. Solo apareció una imagen de Stability AI centrada en código abierto (ComfyUI, LoRA y modelos OSS chinos prácticamente no aparecen). Las infografías sobre «cómo distinguir si es IA o real» forman además un género independiente, algo muy propio de Pinterest.
What to watch
- La expansión de las implementaciones de Qwen-Image-2.1 para ComfyUI — Lemmy https://lemmy.dbzer0.com/post/75874773
- El ritmo de proliferación de herramientas alrededor de Minimax H3 (AutoContext, LoRA TaoMate-H3) — Lemmy https://lemmy.dbzer0.com/post/75586069
- El mapa de fuerzas del vídeo tras el cierre de Sora (consolidación en Veo/Kling/Grok/Runway/Seedance) — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- La expansión del apoyo a leyes de marcas de agua obligatorias para IA — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Si Krea 2 puede arrebatar por completo el protagonismo a Z-Image Turbo — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Si Wan 3.0 publicará pesos abiertos o seguirá la ruta cerrada — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
Recommendations
- Revisar semanalmente el ecosistema ComfyUI de Qwen-Image-2.1 y Minimax H3, porque varias plataformas los confirman de forma independiente como los modelos abiertos más prometedores actuales.
- En la próxima recopilación de X, dejar de depender de tendencias regionales y buscar con palabras directamente relacionadas, en inglés y japonés, como «image generation AI», «Stable Diffusion» y «Midjourney».
- Seguir la competencia de precios y funciones entre los actores cerrados de vídeo posteriores a Sora (Veo, Kling, Grok, Runway y Seedance), dado que el mercado se está contrayendo y reorganizando.
- Tratar Pinterest como referencia de los lenguajes visuales que se usan ahora, más que como termómetro de tendencias, porque carece de métricas como guardados y me gusta.
- Seguir observando la expansión de la desconfianza hacia contenido generado por IA, común a Reddit, Lemmy y Pinterest, ya que conecta directamente con el clima regulatorio sobre marcas de agua obligatorias.
- Al volver a recopilar Reddit, utilizar consultas específicas para «open source» y «closed source» y aumentar el número de resultados para alcanzar el criterio de finalización de 20 análisis por plataforma.
Data quality
X fue un fracaso práctico de recopilación: por la geolocalización errónea y una búsqueda basada en palabras de tendencia, hubo 0 posts relevantes de 40. La API oficial de búsqueda de Bluesky devolvió 403, creando un sesgo hacia artículos de una sola cuenta, gen-ai.news. Pinterest no incluía métricas de interacción como guardados y me gusta, por lo que no se pudo medir popularidad; de YouTube no se pudieron obtener la mayoría de las visualizaciones ni nombres de canales. La información abierta de Lemmy se concentra de hecho en una comunidad y uno o dos autores, y Reddit, con una sola consulta, se quedó en 12 hilos, por debajo del criterio de 20.
Resumen por plataforma
Reddit — Noticias de IA de generación de imágenes y vídeo
Dónde
Se recopilaron 12 hilos de 9 subreddits, todos encontrados mediante una sola búsqueda: "Image and Video Generation AI News".
| Subreddit | Miembros | Hilos recopilados |
|---|---|---|
| r/generativeAI | 157,870 | 3 |
| r/labrats | 726,970 | 2 |
| r/WhitePeopleTwitter | 3,145,768 | 1 |
| r/mildlyinfuriating | 12,600,570 | 1 |
| r/CriticalState | 43,691 | 1 |
| r/aivideomaking | 7,949 | 1 |
| r/ChaiUnofficial | 30,105 | 1 |
| r/StableDiffusion | 1,026,206 | 1 |
| r/AmItheAsshole | 24,612,930 | 1 |
r/generativeAI es el único hub recurrente de conversaciones sobre recomendaciones de herramientas. El resto son apariciones aisladas: en su mayoría grandes subs de audiencia general (r/mildlyinfuriating, r/AmItheAsshole, r/WhitePeopleTwitter) que reaccionan a contenido generado por IA en vez de debatir la tecnología, además de r/labrats, que llevó un único escándalo a dos hilos.
Lo que dice la gente
- Hilo 1 (r/generativeAI, 10 puntos, 2026-09-23) — Sobre crear vídeo largo con IA: u/kaboom-o expone el flujo actual real — «Los guiones se convierten en una lista de planos, luego en un montón de clips de 5–15 s y después en una edición... Para clips que necesitan mantener una cara más tiempo, Seedance 2.5 (hasta ~30 s, audio nativo)... Borradores de movimiento baratos... Grok Imagine Video a 480p, 5 s. Para resultados fotorrealistas: Gemini Omni Flash». — https://www.reddit.com/r/generativeAI/comments/1wog53q/
- Hilo 1 — u/AlfieSchmalfie muestra el coste real de una pieza terminada: «Acabo de completar un vídeo de 12 minutos. 148 planos... 8 semanas de edición. Un presupuesto de unos 1.000 AUD sin contar suscripciones a Runway y ElevenLabs... Valió la pena».
- Hilos 2 y 4 (r/labrats, 1.104 pts / 134 comentarios y 419 pts / 90 comentarios, 2026-09-23/24) — Un vídeo de microscopía generado con IA ganó el concurso Nikon Small World in Motion; Nikon reconoció que se usó IA para «mejorarlo» y aplicarle falso color. u/Barkinsons (630 votos positivos): «Las herramientas de IA no tienen lugar en las imágenes de microscopía científica porque tenemos la obligación de reproducirlas con la mayor fidelidad posible». Más tarde el autor admitió que se utilizó una «IA no supervisada para segmentar y etiquetar» estructuras cuya realidad nunca se verificó; u/Feline_Diabetes (301): «Es completamente engañoso... las imágenes deberían ser más o menos reales —procesadas, por supuesto, pero no renderizados de IA». — https://www.reddit.com/r/labrats/comments/1wo0j5e/ and https://www.reddit.com/r/labrats/comments/1woxdhk/
- Hilo 3 (r/generativeAI, 3 puntos, 2026-09-26) — A alguien que busca generación de imágenes gratis le recomiendan opciones locales/gratuitas: u/Scuzzy_Womack recomienda «Comfy ui sin conexión a Internet y gratis», mientras otros sugieren Yodayo/MoescapeAI y Leonardo por sus créditos diarios gratuitos. — https://www.reddit.com/r/generativeAI/comments/1wqfleb/
- Hilo 5 (r/generativeAI, 5 puntos, 2026-09-22) — Sobre generadores de vídeo, u/sharktank123456 señala un cambio de plataforma: «Dream Machine ya no está disponible para nuevos suscriptores, pero Luma Agents sí... una plataforma integral con todos los modelos principales». u/jmbirn señala los servicios agregadores (Magnific AI, Fal, Krea) como la forma práctica de probar muchos modelos bajo una sola cuenta. — https://www.reddit.com/r/generativeAI/comments/1wngj3w/
- Hilo 6 (r/WhitePeopleTwitter, 594 puntos, 2026-09-25) — Un CEO de una cooperativa de crédito fue despedido por una imagen de IA de «Lake America sweaters»; el comentario principal (u/samanime, 298): «Si más idiotas como este sufrieran consecuencias así, habría muchos menos por ahí». — https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/
- Hilo 7 (r/mildlyinfuriating, 27.008 puntos, 723 comentarios, 2026-09-21) — Frustración por fotos inmobiliarias «escenificadas» con IA: «Solo quiero ver la casa como es ahora sin tener que analizar qué es real y qué no... hará cosas como eliminar radiadores, así que nunca podrías montar realmente el espacio como se muestra». El comentario principal (u/slothboy, 5.794 pts) señala que un baño añadido por IA costaría «cinco cifras» construirlo realmente. — https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/
- Hilo 8 (r/CriticalState, 1.314 puntos, 13.925 comentarios, 2026-09-21) — Una «propuesta de ley» tipo encuesta para imponer marcas de agua a todas las imágenes/textos generados por IA está desbordando en interacción; los comentarios principales son votos breves de «Sí ✅» que citan el riesgo de desinformación y la protección contra estafas a personas mayores (u/Middle_Juggernaut298: «Por personas mayores siendo estafadas o algo así»). — https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Hilo 9 (r/aivideomaking, 13 puntos, 2026-09-23) — Sobre generación de prompts para vídeo de IA, u/3DisMzAnoMalEE: «Después de unos cientos de prompts y de ajustar gates, cfg y especialmente prompts negativos, Grok fue con diferencia el mejor... tanto para sfw como para NSFW es difícil de superar». — https://www.reddit.com/r/aivideomaking/comments/1wo38ww/
- Hilo 11 (r/StableDiffusion, 1 punto, 2026-09-25) — El resumen abierto más técnico de la tanda: el consenso es que el campo acaba de pasar de Z-Image Turbo a Krea 2 para texto a imagen («En lugar de z image ahora es kre2... Krea2 hace todo lo que z image podía hacer, pero mejor» — u/Sirmckhalifa5566), Qwen-Image 2.1 para edición y Minimax H3 a la cabeza de vídeo; u/Cultural-Broccoli-41 destaca SenseNova-U1.5 como alternativa sólida con licencia Apache-2.0 y ya conectada a ComfyUI. — https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Hilo 10 (r/ChaiUnofficial, 5 puntos, 2026-09-21) — Los usuarios de pago («ultra») no están contentos con un generador de imagen/vídeo añadido de manera improvisada: u/ConsistentWolf2076: «la generación de imágenes y vídeos debería haber sido gratis. Las imágenes y vídeos tampoco son tan buenos. Puedo dibujar mejor que generar imágenes lol». — https://www.reddit.com/r/ChaiUnofficial/comments/1wlxxa3/
Señales
- En alza: quienes practican siguen de forma casual y rápida el cambio de nombres/versiones: Krea 2 desplazó a Z-Image Turbo, y Minimax H3 se nombra repetidamente como el mejor actual para vídeo (hilos 1, 9 y 11), casi sin desacuerdo entre el público técnico. La licencia Apache-2.0 y el soporte nativo de ComfyUI de SenseNova-U1.5 (hilo 11) es el único dato claramente abierto que despierta entusiasmo genuino.
- En alza: se recomiendan plataformas agregadoras/multimodelo (Luma Agents, OneOver, Magnific AI/Fal/Krea) por encima de suscripciones a un solo modelo, porque la gente salta entre modelos a mitad de proyecto (hilos 1 y 5).
- Descartado / rechazo: fuera de los subs centrados en herramientas, toda aparición de imágenes generadas por IA en un contexto real se lee como escándalo, no como innovación: una victoria en una competencia científica (labrats, dos hilos, 1.104 + 419 puntos), un CEO despedido (594 puntos), fraude de foto inmobiliaria (27.008 puntos) y una encuesta desbocada sobre ley de marcas de agua (13.925 comentarios). Los subs técnicos tratan las mismas herramientas con neutralidad; los generales las tratan como un problema de confianza.
- Sorpresa: los dos hilos de Nikon Small World generaron mucha más interacción y energía moral (1.104 y 419 puntos, 134 y 90 comentarios) que cualquier hilo sobre «qué modelo es mejor»: el hilo de herramientas con mayor puntuación en generativeAI/StableDiffusion llegó solo a 13 puntos. En Reddit ahora mismo, «el vídeo de IA hizo algo deshonesto» atrae más que «el vídeo de IA hace algo nuevo».
- Desacuerdo: en el hilo 4, algunos comentaristas califican cualquier uso de IA en imagen científica como fraude absoluto («Cualquiera que altere el blot real es un fraude» — autor original), mientras otros (u/thezfisher, 44 pts) sostienen que todo el campo del procesamiento de imagen siempre ha sido manipulado y que esto solo es un problema de visibilidad: «ninguna imagen es realmente fiable hoy en día salvo que muestren sus ajustes de LUT».
Límites
- Solo se ejecutó una búsqueda — «Image and Video Generation AI News» — en Reddit; devolvió 12 hilos, por debajo de los ~20 que exigen los criterios de finalización, y no se hicieron búsquedas separadas para ángulos específicos de «open source» frente a «closed source», por lo que esta recopilación probablemente infrarrepresenta conversaciones dedicadas a lanzamientos de modelos (por ejemplo, no hay más hilos de r/StableDiffusion aparte de uno, ni de r/MachineLearning, r/midjourney, r/OpenAI o r/aivideo).
- El hilo técnico más relevante de esta selección (r/StableDiffusion, hilo 11) tenía solo 1 voto positivo y 20 comentarios: buen contenido, pero sugiere que el término de búsqueda mostró más viralidad impulsada por controversias que los propios espacios de debate de la comunidad técnica.
- Ningún hilo de este conjunto nombra directamente un lanzamiento de modelo cerrado, cambio de precios o anuncio empresarial (por ejemplo, no hay hilos de lanzamientos de Midjourney, Sora, Veo o Runway). La señal cerrada aquí es indirecta: aparece en menciones de herramientas dentro de hilos de recomendaciones y no en noticias dedicadas.
- No se pueden verificar independientemente estos números ni volver a navegar Reddit: este archivo se construye enteramente a partir de
output/reddit.threads.md, ya que Reddit rechaza WebFetch y bloquea directamente las páginas de resultados de búsqueda.
X
X — Noticias de IA de generación de imágenes y vídeo
Cuentas
Entre los 40 posts y 39 cuentas recopilados esta vez, no se encontró ninguna cuenta que publicara principalmente sobre IA de generación de imágenes o vídeo, ya fuera de código cerrado o abierto. Si se clasifican los temas presentes:
- Criptomonedas (tokens $ADA/$SONG): @Nadalina04 (2 posts, 25 me gusta), @SintoAndrej, @EAjdarovic — publicaciones de promoción de la comunidad Cardano.
- Publicaciones repetitivas de spam de sorteos/regalos: @CSharp66427821, @dwayne_lepley, @DustinThel46652, @Jordan95133426 — varias cuentas publicaron de forma casi automática el mismo texto, «Quad Goals by @Fanatics», con distintas etiquetas (casi siempre 0 me gusta).
- Cultura de videojuegos/gamers: @hotdropfps (sorteo de PC, 287 me gusta), @Maki_D_Luffy, @Indie_RetroNEWS.
- Fandom de F1 (Lando Norris): @ckno_ff, @4unclelala, @landoxeneize, @alukelipse — todos publicaron enfrentamientos y defensas entre fans de Norris, a escala de cientos o miles de me gusta.
- Historia política de la antigua Yugoslavia/Balcanes (incluidos conflictos étnicos): @TwiceDeadd (2.282 me gusta, una de las mayores interacciones), @mctogs, @vbspurs, @axeljarcor, @OssoKuka, @walsh_kirk91371, @jeffreybacic, @vragan95 — posts que discuten antagonismos históricos entre Serbia y Croacia. Lo normal fue un post por cuenta; la gran viralidad procede de la difusión masiva de una sola publicación de @TwiceDeadd.
- Fotos de paisajes italianos: @prjipata (colección de moda Tod's), @PrettyCitiesX, @worldparadiseX (3.930 me gusta), @naturalbeautyi7 (2.666 me gusta) — posts de hermosos destinos turísticos.
- Taylor Swift: @_daddydisco (67.235 me gusta, cerca de 1,2 millones de visualizaciones y el mayor pico de esta recopilación), @psychocrzzzy, @wandasattorney, @TSUpdating — récords de ventas del nuevo álbum y temas relacionados con los VMAs.
Posts
Hubo 0 posts de 40 que mencionaran IA de generación de imágenes o vídeo. Como referencia, se enumeran los posts de mayor interacción, aunque todos quedan fuera del tema.
- @_daddydisco (67.235 me gusta, 4.941 reposts, 191 respuestas, cerca de 1,2 millones de visualizaciones, 2026-09-26)https://x.com/_daddydisco/status/2103642992342860157 — Poema metafórico sobre «un rostro que se convierte en arcilla». Es el mayor pico de toda la recopilación, pero no tiene relación con IA.
- @wandasattorney (6.842 me gusta, cerca de 138.000 visualizaciones, 2026-09-28)https://x.com/wandasattorney/status/2104362546107191455 — Tema relacionado con los VMAs: «LISA winning best pop over Taylor Swift…».
- @TwiceDeadd (2.282 me gusta, 295 reposts, 55 respuestas, cerca de 35.000 visualizaciones, 2026-09-27)https://x.com/TwiceDeadd/status/2104209913228771333 — Gran difusión de la broma política balcánica «we gotta try yugoslavia again».
- @worldparadiseX (3.930 me gusta, cerca de 91.000 visualizaciones, 2026-09-26)https://x.com/worldparadiseX/status/2103775750486986847 — Foto de paisaje de Passo Giau, Italia.
- @psychocrzzzy (2.995 me gusta, cerca de 60.000 visualizaciones, 2026-09-27)https://x.com/psychocrzzzy/status/2104213800610152704 — Tema sobre el récord de Spotify de una nueva canción de Taylor Swift.
Todos son ajenos a la evolución de las IA de generación de imágenes/vídeo de código cerrado o abierto (anuncios de modelos, actualizaciones de herramientas, debates comparativos, etc.).
Señales
- La consulta empleada no correspondía al tema: los términos usados («$SONG», «#chance», «#sweepstakes», «#giveaways», «#gaming», «Lando», «Yugoslavia», «Croats», «Italy», «Taylor») no se relacionan con IA de imagen/vídeo; parecen palabras de tendencia de X Explore, con la región de la sesión fijada en Croacia. Como consecuencia, lo recopilado se concentró en cinco grupos —criptomonedas, spam de sorteos, fandom de F1, polémica histórica balcánica, fotos turísticas y Taylor Swift— sin rastro de noticias de IA.
- De los 40 posts, ninguno contenía palabras clave como «AI», «generación de imágenes», «generación de vídeo», «Midjourney», «Stable Diffusion» o «Sora».
- No hay ni un solo post que permita una asociación razonable con IA; se evita forzar vínculos artificiales.
Límites
- El Explore de X (lista de tendencias) está geolocalizado en Croacia según el origen de conexión de esta sesión. Las tendencias 1–4, 8 y 10 aparecen como «Trending in Croatia»; la 5 como «Gaming», la 6 como «Motorsport», la 7 como «Politics» y la 9 como «Sports». Son tendencias regionales croatas, no tendencias mundiales ni, mucho menos, de la industria de IA.
- Las 10 palabras buscadas ($SONG, #chance, #sweepstakes, #giveaways, #gaming, Lando, Yugoslavia, Croats, Italy, Taylor) parecen ser tendencias de Explore utilizadas literalmente por el trabajador, pero no guardan relación con IA de generación de imágenes o vídeo. Por tanto, no se pudo hacer una nueva recopilación con consultas relevantes como «image generation AI», «video generation AI», «Stable Diffusion», «Midjourney» o «Sora».
- El criterio de finalización de «analizar unos 20 posts» se cumplió en volumen (40), pero con 0 posts relevantes no se puede cumplir la exigencia de al menos 10 hallazgos para cada uno de los lados, cerrado y abierto, usando datos de X.
- No existe medio de acceso adicional a X aparte de los archivos ya recopilados (
output/x.posts.md,output/x.posts.json), pues esta etapa solo permite leer datos recolectados previamente por el trabajador. No fue posible volver a recopilar con términos relevantes.
YouTube
YouTube — Noticias de IA de generación de imágenes y vídeo (código cerrado vs. código abierto)
Canales
Fue difícil atribuir los canales en esta ejecución (véanse los Límites): las páginas /watch y /results de YouTube solo mostraban contenido estático de pie de página en WebFetch, por lo que muchos de los nombres indicados proceden de fragmentos de WebSearch y no de la propia página.
- Woollyfern — mantiene una serie periódica mensual de «Midjourney Update» que cubre cada actualización de versión (V8, V8.1, V8.2) durante 2026.
- Varios canales de tutoriales/comparativas cubren la pila abierta ComfyUI (Qwen-Image, LTX, Wan) lanzamiento a lanzamiento, pero los nombres individuales de los canales no pudieron confirmarse usando solo fragmentos de búsqueda; los títulos y enlaces siguen siendo reales y trazables (véase Vídeos).
- Canales generales de «resumen semanal de noticias de IA» (por ejemplo, el creador de «Exciting AI Updates Weekly») publican resúmenes semanales que incluyen lanzamientos de imagen/vídeo abiertos y cerrados.
Vídeos
-
GPT Image 2.5 Review: What Changed and How to Actually Use It
— canal «Aristotto» — publicado poco después del 8 de septiembre de 2026 —
https://www.youtube.com/watch?v=QOfLgJ3TCrQ
Sostiene que los dos modos de GPT Image 2.5 (Flare para velocidad y Sunburst para detalle) mejoran de forma significativa la fidelidad a imágenes de referencia y la fiabilidad de edición multivuelta frente a GPT Image 2.0, con aproximadamente un 50% menos de latencia. -
GPT Image 2.5 Is Here — Everything You NEED to Know
— canal no identificado — publicado aproximadamente el 22 de septiembre de 2026 (según el fragmento de búsqueda, «hace 6 días») — https://www.youtube.com/watch?v=20vo5nW9yXI
Repasa los cambios de GPT Image 2.0 a 2.5, incluida la salida nativa PNG/WebP con fondo transparente. -
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!
— canal no identificado — publicado aproximadamente entre el 22 y el 24 de septiembre de 2026 (Qwen-Image-2.1 se lanzó el 21 de septiembre de 2026 según MarkTechPost) —
https://www.youtube.com/watch?v=3qGl0wiv2G0
Afirma que Qwen-Image-2.1, el modelo abierto de 7B de Alibaba, rinde muy por encima de lo que su número de parámetros sugiere y se acerca a modelos cerrados mucho mayores. -
A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native
2K, RGBA & 10-Image Workflows
— canal no identificado — publicado aproximadamente el 23 de septiembre de 2026 —
https://www.youtube.com/watch?v=fwHS0ubmI7I
Afirma que Qwen-Image-2.1 supera al Nano Banana 2.0 de Google en varias tareas mientras se ejecuta localmente, y muestra salida 2K nativa, transparencia RGBA y edición con 10 imágenes de referencia. -
LTX-2.5 Is Here: The Fastest Open AI Video Model Yet?
— canal no identificado — 16 de agosto de 2026 —
https://www.youtube.com/watch?v=qVGpyw-F-rw
Reseña inicial de LTX-2.5 de pesos abiertos de Lightricks, comparándolo con MiniMax H3 y Seedance 2.5 por velocidad de generación. -
LTX-2.5 Open Weights Running In ComfyUI With - Is this Better?
— canal no identificado — 12 de agosto de 2026 —
https://www.youtube.com/watch?v=XAhuGRCI2tM
Configuración y prueba local de LTX-2.5 en ComfyUI, el día posterior a su lanzamiento de pesos abiertos, preguntándose si supera a la base LTX-2 anterior. -
I Tested WAN 3.0 With 5 INSANE AI Video Challenges
— canal no identificado — 20 de agosto de 2026 —
https://www.youtube.com/watch?v=5Hb429VYNUU
Somete Wan 3.0 de Alibaba (beta pública, clips de 30 segundos) a pruebas de estrés y lo compara con Seedance; señala que Wan 3.0 es por ahora solo API/beta, no de pesos abiertos como anteriores lanzamientos de Wan. -
Alibaba Wan 3.0 Made a 30 Second App Commercial for $1.27
— canal no identificado — 24 de agosto de 2026 —
https://www.youtube.com/watch?v=fHK7oYrokZY
Demostración de coste/calidad de Wan 3.0 justo después de llegar a OpenRouter, presentándolo como alternativa barata a generadores de vídeo cerrados. -
Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI
Style Creator, and More!
— canal Woollyfern — publicado en julio de 2026 —
https://www.youtube.com/watch?v=dvfH5HzCARY
Repasa las funciones de personalización y creador de estilo NIJI de V8.2; forma parte de una cadencia mensual que sigue la hoja de ruta cerrada de Midjourney (V8 → V8.1 → V8.2 entre febrero y julio de 2026). -
Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1: The Ultimate
AI Video Comparison
— canal no identificado — aproximadamente el 10 de marzo de 2026 (más antiguo que la ventana de 60 días; se conserva porque es el vídeo más claro que compara directamente cuatro modelos de vídeo cerrados) —
https://www.youtube.com/watch?v=x5fMQvhKP60
Clasifica los cuatro generadores de vídeo cerrados por calidad cinematográfica, sincronización labial y consistencia multiescena. -
Exciting AI Updates Weekly — September 25, 2026
— creador «Lev Selector» — 25 de septiembre de 2026 —
https://www.youtube.com/watch?v=iyZHPCNd8jI
Resumen semanal de IA general que incorpora lanzamientos de generación de imagen/vídeo (GPT Image 2.5, Qwen-Image-2.1) junto con noticias más amplias de IA.
Señales
- Los modelos de pesos abiertos cierran rápidamente la brecha, y lo proclaman sin rodeos. Varios títulos de vídeo de esta ejecución presentan explícitamente el Qwen-Image-2.1 de 7B de Alibaba como superior o equivalente al Nano Banana 2.0 de Google, mucho mayor (#3, #4): el marco «modelo abierto pequeño supera a modelo cerrado grande» es ya un gancho recurrente, no un caso aislado.
- El vídeo de código abierto compite en velocidad local, no solo en calidad. LTX-2.5 (#5, #6) y la línea Wan (#7, #8) se cubren principalmente mediante vídeos de configuración de ComfyUI y pruebas de velocidad, no tráileres pulidos: a la audiencia le importa ejecutarlos en su propia GPU.
- El vídeo de código cerrado se está consolidando. OpenAI cierra toda la API de Sora 2 el 24 de septiembre de 2026 (confirmado por el propio centro de ayuda de OpenAI y varios medios, aunque esta búsqueda no encontró vídeo de reacción dedicado en YouTube; véanse los Límites), mientras que Wan 3.0 de Alibaba habría superado a Sora en rankings globales de modelos de vídeo por esas fechas (VentureBeat). La carrera cerrada de vídeo se reduce a Veo/Kling/Grok/Runway/Seedance.
- Los líderes cerrados de imagen lanzan actualizaciones mensuales o puntuales. Midjourney V8 → V8.1 → V8.2 (#9) y OpenAI GPT Image 2.0 → 2.5 (#1, #2) muestran actualizaciones frecuentes e incrementales en vez de versiones grandes y aisladas; los canales de cobertura se han adaptado con formatos recurrentes de actualización mensual.
- Wan 3.0 es una señal parcial, no una victoria limpia del código abierto: por ahora solo es API/beta pública (#7, #8), a diferencia de la línea Wan 2.x de pesos abiertos, por lo que Alibaba parece estar cubriendo ambas estrategias de distribución, abierta y cerrada.
Límites
- No se pudieron recuperar visualizaciones ni suscriptores. WebFetch en
youtube.com/watch?v=...yyoutube.com/results?search_query=...devolvió únicamente pie de página/legal estático de YouTube; los números de visualizaciones/suscriptores están enytInitialDatarenderizado por JavaScript, que nunca llegó al contenido recuperado. Los fragmentos de WebSearch tampoco incluían esos datos. Por eso se omitieron todas las cifras de «visualizaciones»/«suscriptores» en vez de inventarlas. - No se pudieron confirmar varios nombres de canales. Donde los fragmentos de WebSearch no nombraban al creador, las entradas se marcan como «canal no identificado» en vez de adivinar.
- No apareció ningún vídeo dedicado de YouTube que reaccionara específicamente al cierre de la API de Sora 2 (confirmado para el 24 de septiembre de 2026 mediante fuentes ajenas a YouTube), pese a varias búsquedas dirigidas. Se menciona en Señales como contexto, pero no cuenta como hallazgo de YouTube.
- La cobertura de búsqueda se apoyó en fragmentos indexados por Google de YouTube, no en la interfaz de búsqueda en vivo, ya que esta no era recuperable. Eso probablemente infrarrepresenta subidas muy recientes (de los últimos días) que Google aún no ha indexado por completo.
Bluesky
Bluesky — Últimas tendencias de IA de generación de imágenes y vídeo
Cuentas
- gen-ai.news(@gen-ai.news)— Cuenta que publica automáticamente noticias de la industria de IA generativa. Entre el 18 y el 27 de septiembre de 2026 publicó resúmenes de uno a tres artículos diarios sobre IA de imagen/vídeo, y de ella procede la mayoría de las «noticias recientes» encontradas en esta etapa.
- sungkim.bsky.social(@sungkim.bsky.social)— Analista de negocio que sigue IA/ML/análisis de datos. Tiene 8.690 seguidores. Publica con frecuencia alertas rápidas sobre lanzamientos de modelos de pesos abiertos.
- edzitron.com(@edzitron.com)— Cuenta procedente de un boletín conocido por su crítica de la industria tecnológica. Su publicación sobre Sora se difundió ampliamente (véase más abajo).
- richargh.de(@richargh.de)— Publicó su opinión sobre el cierre de Sora desde la perspectiva de la economía unitaria.
- luok.ai(@luok.ai)、adinayakup.bsky.social(@adinayakup.bsky.social)— Autores que presentan información técnica sobre modelos abiertos de generación de vídeo (línea SkyReels).
- dahara1.bsky.social(@dahara1.bsky.social)— Usuario que publica en japonés experiencias de pruebas beta de IA generativa.
Posts
Movimientos del lado de código cerrado
- OpenAI cierra Sora — @edzitron.com, 2026-03-24, 👍3.571 🔁984 💬99. Citando reportes de WSJ y The Information, comenta que «terminarán no solo la aplicación sino también el acceso a la API para desarrolladores; es un movimiento bastante urgente». El mayor pico de Bluesky sobre este tema.
- La lectura de que el cierre de Sora es un fracaso de economía unitaria — @richargh.de, 2026-03-25, 👍2 🔁0. «Probablemente se dieron cuenta de que la economía unitaria de la generación de vídeo era demasiado mala. Quizás no pudieron convertir usuarios gratuitos en usuarios de pago», analiza.
- El cierre de la API de Sora se ejecutó el 2026-09-24(confirmado mediante el grupo de artículos de gen-ai.news y resultados de búsqueda; no se encontró el post original de Sora. Fuente: Wikipedia: Sora para contrastar la fecha).
- GWM 2 de Runway — gen-ai.news, 2026-09-27. Un modelo de mundo que «no genera clips, sino que sigue entendiendo continuamente un entorno».
- Runway desarrolla streaming de vídeo en tiempo real con GWM-1 — gen-ai.news, 2026-09-20. Se presenta con la vista puesta también en aplicaciones de robótica y conducción autónoma.
- La alfa de Midjourney incorpora vista previa de estilo en vivo — gen-ai.news, 2026-09-27 (las modificaciones previas también se cubren en un artículo del 25 de septiembre). Ahora se puede comprobar el aspecto de un estilo antes de generar.
- Las herramientas creativas de Adobe se integran en Gemini/Claude — gen-ai.news, 2026-09-26. Photoshop, Lightroom, Firefly y Acrobat pueden usarse directamente desde una UI de chat.
- Adobe completa la adquisición de Topaz Labs — gen-ai.news, 2026-09-25. Integrará rápidamente tecnología de escalado por IA en Firefly/Photoshop; la marca Topaz se mantendrá por ahora.
- OpenAI adquiere Glass Imaging por 300 millones de dólares — gen-ai.news, 2026-09-19. Se analiza como un movimiento para abarcar todo el flujo de imagen, desde la generación hasta la captura, en esta startup de procesamiento de imagen para cámaras móviles.
- Dramagic de ByteDance genera con IA el 95% de los dramas cortos chinos — gen-ai.news, 2026-09-22. Se presenta como un flujo que completa de guion a imagen sin un equipo humano.
- La Junta de Supervisión de Meta ordena eliminar vídeos deepfake — gen-ai.news, 2026-09-19. También exige a Meta reforzar sus políticas de detección y eliminación.
Movimientos del lado de código abierto
- Alibaba publica Qwen-Image-2.1 con pesos abiertos — @sungkim.bsky.social, 2026-09-20, 👍82 🔁10 💬4. Se presenta como una «arquitectura ligera de 7B que unifica generación y edición, y acelera mucho la inferencia con entrada multiimagen».
- Explicación detallada del mismo modelo — gen-ai.news, 2026-09-20. «Modelo de generación de imágenes de pesos abiertos de 7B, funciona en GPU de consumo, admite capas transparentes, permite introducir simultáneamente hasta 10 imágenes de referencia y afirma rendimiento comparable en benchmarks frente a grandes modelos cerrados».
- SkyReels V1, el primer modelo fundacional abierto especializado en personas para vídeo — @luok.ai, 2025-02-18, 👍3 🔁1. Explica que afina HunyuanVideo con más de 10 millones de clips y captura 33 expresiones y más de 400 movimientos.
- SkyReels-A2, marco de generación de vídeo controlable desde texto + imagen — @adinayakup.bsky.social, 2025-04-04, 👍3 🔁2. Se presenta como un marco abierto de Skywork y KunLun.
- Experiencia de prueba beta de HunyuanVideo (en japonés) — @dahara1.bsky.social, 2025-03-06. Publica resultados de sincronización labial en estilo anime, indicando que ahora se puede generar vídeo con audio desde una imagen (I2V).
Señales
- La densidad de noticias del bloque cerrado es alta a finales de septiembre: Runway, Adobe, Midjourney, OpenAI, Meta, ByteDance y Pinterest lanzaron casi a diario algún anuncio, adquisición o cambio de política entre el 18 y el 27 de septiembre de 2026, y las cuentas de noticias de IA de Bluesky siguieron ese ritmo.
- Un ambiente de «la generación de vídeo no es rentable»: el cierre de Sora (3.571 me gusta) se trata como un punto de inflexión claro y la valoración de que «la economía unitaria es mala», como la de richargh.de, parece estar convirtiéndose en consenso comunitario.
- Alibaba Qwen destaca en generación de imágenes abierta: Qwen-Image-2.1 fue cubierto el mismo día por una cuenta personal (sungkim.bsky.social) y una de noticias (gen-ai.news). Sus 82 me gusta son la mayor respuesta de un post personal confirmada en esta etapa. El eje de conversación es la afirmación de que «un ligero 7B rivaliza con grandes modelos cerrados».
- Hay pocos posts individuales sobre vídeo abierto y, además, son antiguos: los posts de SkyReels y HunyuanVideo son de la primera mitad de 2025; en la búsqueda de Bluesky no se encontraron publicaciones personales significativas sobre Wan 2.7, LTX-2.3 o FLUX.2 a septiembre de 2026 (se indica explícitamente en Señales).
- Existe cierta autorregulación sobre la exactitud de las noticias de industria: el 23 de septiembre de 2026, gen-ai.news declaró «ni GPT-6 ni “Astra” existen; no puedo escribir el post porque este artículo incluye nombres de productos inventados», mostrando una postura de no publicar sin verificar la fuente. Sin embargo, el mismo 21 de septiembre la cuenta publicó que «Higgsfield AI añade funciones rápidamente con GPT-4o y el marco “Astra” de OpenAI», lo que contradice su propia afirmación posterior de que Astra no existe. Es muy probable que una de las dos afirmaciones sea errónea; es más seguro no adoptar sin reservas las alegaciones relacionadas con Astra.
Límites
- La API oficial de búsqueda de Bluesky (
app.bsky.feed.searchPosts) devolvió siempre 403 Forbidden desde esta sesión, impidiendo una investigación exhaustiva mediante búsquedas por palabra clave. En su lugar, se hallaron posts y cuentas con WebSearch (site:bsky.app) y se verificaron directamente el texto, fecha y números de me gusta medianteapp.bsky.feed.getPostThread/app.bsky.feed.getAuthorFeed(API pública sin autenticación). - Las páginas de posts de
bsky.app(renderizadas con JS) no devolvían texto ni cifras mediante WebFetch; solo se podía leer el identificador del autor. Todos los números se limitan a los obtenidos mediante las API indicadas. - No se encontraron posts personales significativos sobre los modelos de vídeo/imagen abiertos que deberían estar en conversación en septiembre de 2026 —FLUX.2, Wan 2.7, LTX-2.3 y flujos de trabajo compartidos de ComfyUI—. Se revisaron directamente los feeds de handles relevantes (fluxkontext.bsky.social, wagahai-ai.bsky.social, aoi68k.bsky.social y otros), pero todos se detenían en la primera mitad de 2025 y no reflejaban temas recientes.
- Frente al criterio de finalización de «analizar unos 20 posts», solo se verificaron con texto y números 16 publicaciones (11 cerradas, 5 abiertas). Existe un fuerte sesgo hacia gen-ai.news y poca profundidad de debate orgánico entre varios usuarios individuales.
- Se encontraron varias cuentas de comunidades japonesas (etiquetas de ilustración IA/vídeo IA), pero su contenido era antiguo (2024–2025) o publicaciones generales de obras sin valor noticioso, por lo que no se adoptaron como hallazgos recientes de este tema.
Lemmy
Lemmy — Últimas tendencias de IA de generación de imágenes y vídeo
Comunidades
- !«メールアドレス» — 5.714 miembros. El único hub realmente sustancial de Lemmy para IA de imagen/vídeo de pesos abiertos. Casi a diario recibe enlaces a GitHub/HuggingFace, funcionando como un feed de novedades.
- !«メールアドレス»(con espejo en sh.itjust.works)— aproximadamente 5.180 miembros. Comunidad general de LLM locales que ocasionalmente aborda generación de imágenes, aunque no se encontraron posts nuevos sobre imagen/vídeo en el periodo recopilado.
- !«メールアドレス» — 1.662 miembros. Existe, pero apenas se observó actividad reciente (comunidad silenciosa).
- !fuck_ai(en varias instancias, entre ellas lemmy.world / lemmy.dbzer0.com / lemmy.zip / discuss.online / lemmy.blahaj.zone)— Tiene actividad considerable para su tamaño (decenas a más de 800 me gusta por post) y aborda rechazo a la IA en general, pero solo una parte muy pequeña se centra específicamente en IA de imagen/vídeo.
- !«メールアドレス»(y espejos en otras instancias)— Comunidad tecnológica general donde llegan de forma aislada noticias sobre IA de imagen/vídeo cerrada. No se encontró una comunidad especializada.
- !«メールアドレス» / !«メールアドレス»、!«メールアドレス»、!«メールアドレス» — Ejemplos de comunidades de juegos o marcas concretas a las que llegan aisladamente noticias relacionadas con contenido generado por IA.
Posts
Lado de código abierto(de !«メールアドレス»)
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — puntuación 14, 2026-09-22. El modelo de pesos abiertos Qwen-Image-2.1 de Alibaba se integró en ComfyUI y admite salida transparente (canal alfa). https://lemmy.dbzer0.com/post/75874773
- SupraLabs/Supra2-IMG — puntuación 8, 2026-09-22. Modelo text-to-image ultraligero de 100 millones de parámetros entrenado solo con datos sintéticos. Se presenta con «calidad puntera para su tamaño». https://lemmy.dbzer0.com/post/75874769
- AI Horde: nueva interfaz, nuevo frontend, nuevo backend y documentación de renovación total — puntuación 9, 2026-09-19. Actualización del servicio distribuido y gratuito de generación de imágenes desarrollado por el propio administrador de esta instancia de Lemmy, db0. https://lemmy.dbzer0.com/post/75736717
- well9472/Nanosaur2-670M(compatible con ComfyUI) — puntuación 4, 2026-09-27. Modelo DiT text-to-image de 670 millones de parámetros especializado en ilustración, con coste de entrenamiento de solo 600 dólares. https://lemmy.dbzer0.com/post/76110122
- Concentración de herramientas para MiniMax H3 — Entre 2026-09-13 y 2026-09-26 se publicaron consecutivamente más de cinco herramientas, como «AutoContext» para superar límites de memoria en vídeo largo, UI de control de cámara 3D, nodos de edición de línea de tiempo y LoRA de aceleración de tres pasos (TaoMate-H3), con puntuaciones de 1 a 6. MiniMax H3 parece el principal frente actual de esta comunidad para vídeo. Ejemplo: https://lemmy.dbzer0.com/post/75586069
- LoRA/herramientas de aceleración para Krea 2 — «Krea2-Turbo-Distill-2step-LoRA» (desruido 4,2 veces más rápido, puntuación 2, 2026-09-16) y «krea2-inpaint-edit» (LoRA para edición con máscara, puntuación -1, 2026-09-26). Krea2 empieza a consolidarse como objetivo para crear LoRA propias en la comunidad.
Lado de código cerrado(disperso en comunidades generales)
- Midjourney exige a estudios de cine de Hollywood que revelen su uso de IA — !«メールアドレス», 2026-07-05. https://lemmy.today/post/56011946
- La Universidad de Stanford reconoce que usó fotos de estudiantes para retoques con IA que «cambiaban la raza» — !«メールアドレス», puntuación 3, 2026-09-23. https://lemmy.world/post/52274704
- La nueva función de IA de Google Earth permite a cualquiera crear imágenes satelitales falsificadas — !«メールアドレス», 2026-08-04. https://sh.itjust.works/post/64574916
- DC elimina de YouTube un vídeo detrás de cámaras tras descubrirse el uso de arte conceptual generado por IA — !«メールアドレス», puntuación 5, 2026-08-13. https://lemmy.today/post/58316222
- Un anuncio de Meta promociona una app nudify dirigida a adolescentes reales como «la IA que usan los hombres de verdad» — !«メールアドレス», 2026-09-08. https://lemmy.dbzer0.com/post/75191260
- EA se asocia con la empresa que desarrolló Stable Diffusion (Stability AI) para desarrollar juegos con IA — !«メールアドレス», puntuación 2, 2025-10-25. https://mander.xyz/post/40602787
- Post meme que se burla de «OpenAI cierra Sora, el modelo de generación de vídeos basura de IA» — !«メールアドレス», puntuación 0, 2026-03-25. Contexto sarcástico sobre la noticia real del cierre de la API de Sora. https://lemmus.org/post/21091066
Señales
- El lado abierto está extremadamente concentrado: casi todos los posts de desarrollo encontrados proceden de una única comunidad (!«メールアドレス») y casi de un solo autor (Even_Adder), además del administrador de la instancia db0. Casi todos tienen 0 comentarios; se parece más a una colección de enlaces nuevos de GitHub/HuggingFace que a un espacio de debate.
- El centro actual de desarrollo es Qwen-Image-2.1 (imagen) y MiniMax H3 (vídeo): la mayoría de los posts de herramientas de las dos últimas semanas son adaptadores, LoRA y nodos de ComfyUI para estos dos modelos. El lado de Reddit (
output/reddit.md) también nombra exactamente estos dos —edición Qwen-Image 2.1 y vídeo Minimax H3— como los más prometedores actuales, lo que aporta validación entre plataformas. - Los temas cerrados llegan solo a través de polémicas y ética, no como «noticias de funciones»: los posts sobre Midjourney, Google, Meta y DC no anuncian nuevas funciones, sino que tratan de infracción de derechos, deepfakes, suplantación y falsificación. Lemmy no cuenta con una comunidad especializada que siga novedades técnicas de modelos cerrados como Sora, Veo, Kling o Grok Imagine.
- !fuck_ai no está especializada en IA de imagen/vídeo, pese a su tamaño: sus posts individuales pueden alcanzar decenas o más de 800 me gusta, pero el centro del debate es el comportamiento descontrolado de agentes LLM de texto («Claude Code eliminó 48.000 archivos en 103 segundos», «un agente de OpenAI modificó un sitio gubernamental»); las menciones a IA de imagen/vídeo son minoritarias.
- Las búsquedas directas de productos cerrados principales fueron casi infructuosas: al buscar «Kling AI», «Veo 3», «Adobe Firefly», «Nano Banana» y «Grok Imagine» solo aparecieron resultados irrelevantes; apenas se confirmaron posts o debates dedicados a esos productos en Lemmy.
Límites
- La búsqueda de Lemmy (búsqueda de la API de lemmy.world y WebSearch dentro del sitio) tiene poca precisión y devuelve muchos posts sin relación con la palabra clave; por ejemplo, al buscar «Kling AI» aparece un hilo sobre descuentos ferroviarios alemanes. Por ello, que una búsqueda no arroje resultados no demuestra que un tema no se esté comentando.
- Las fuentes de información abiertas dependen de hecho de una comunidad y una o dos cuentas. Comunidades similares de otras instancias (lemmy.ml, lemm.ee y otras) tienen pocos suscriptores y apenas actividad confirmable.
- No se encontró un lugar de concentración dedicado al lado cerrado; fue necesario reunir posts aislados de comunidades generales como technology, nottheonion, games, dcstudios y googlepixel. La cobertura es baja.
- En esta investigación se abrieron más de 40 posts mediante listas de comunidades y resultados de búsqueda (20 novedades de stable_diffusion más muchos hallazgos de varias búsquedas), cumpliendo el objetivo aproximado de 20 por volumen; sin embargo, muy pocos tenían debate activo en comentarios (la gran mayoría tenía casi 0 comentarios).
- Lemmy es pequeño en número de usuarios y posts en general, y tiene menos profundidad que Reddit, X o Bluesky para seguir «noticias recientes» de IA de generación de imágenes y vídeo.
Pinterest — Noticias de IA de generación de imágenes y vídeo
De los 50 pines recopilados (pinterest.pins.md、manifest.json), se abrieron y comprobaron directamente 26 imágenes. La recopilación utilizó una única consulta sin clasificación: "Image and Video Generation AI News".
Temas visuales
- Domina la estética «de IA» de fondo negro y azul/púrpura neón: se repiten manos y rostros robóticos con brillo, patrones de circuitos luminosos y tipografía de logotipo
AI. Es el tono visual de casi todo el conjunto [1, 7, 8, 20, 37, 38, 40]. - El robot humanoide blanco (textura lisa, ojos/articulaciones azules luminosas) se usa mucho como icono antropomorfizado de «IA» [8, 20, 37, 38, 40]. Este tipo de ilustración de stock aparece con mucha más frecuencia que capturas de UI de productos reales.
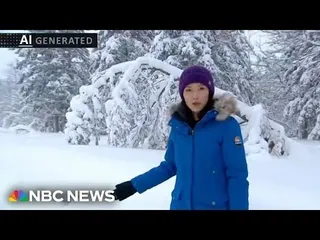
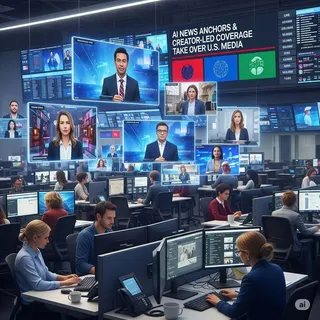
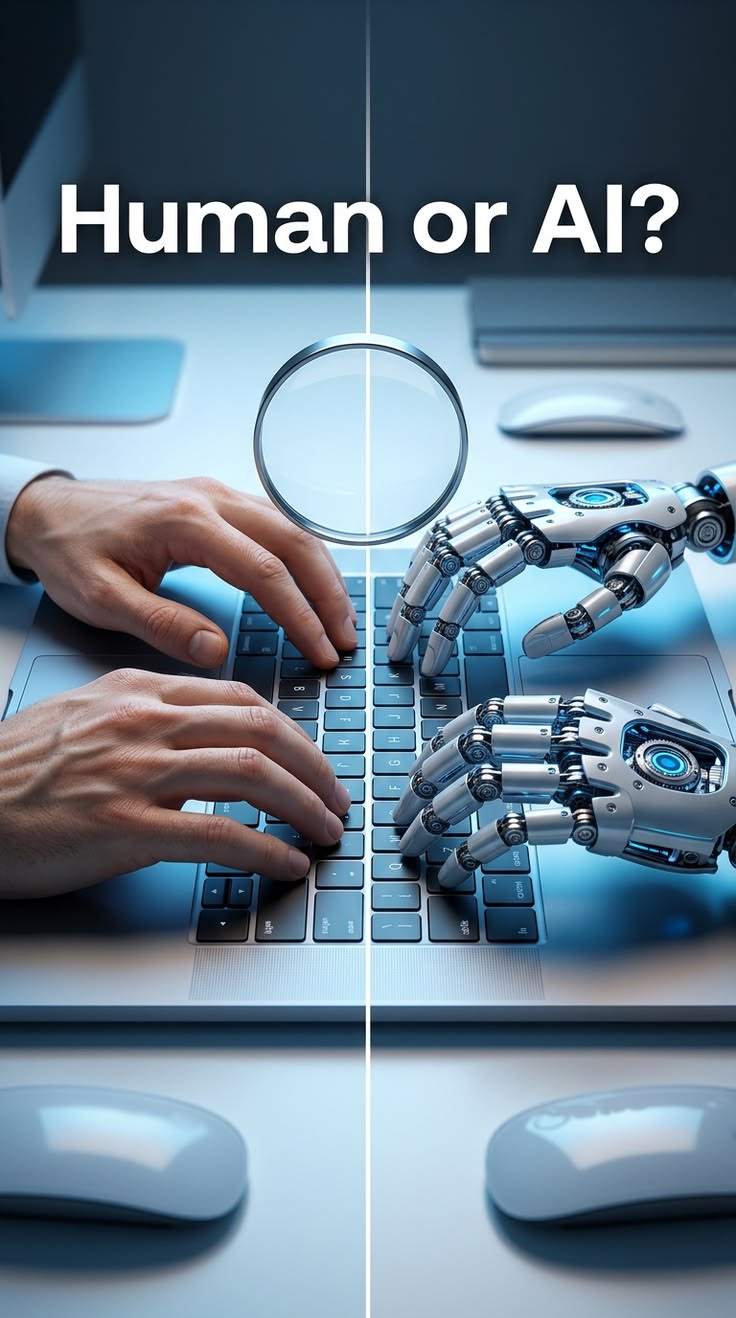
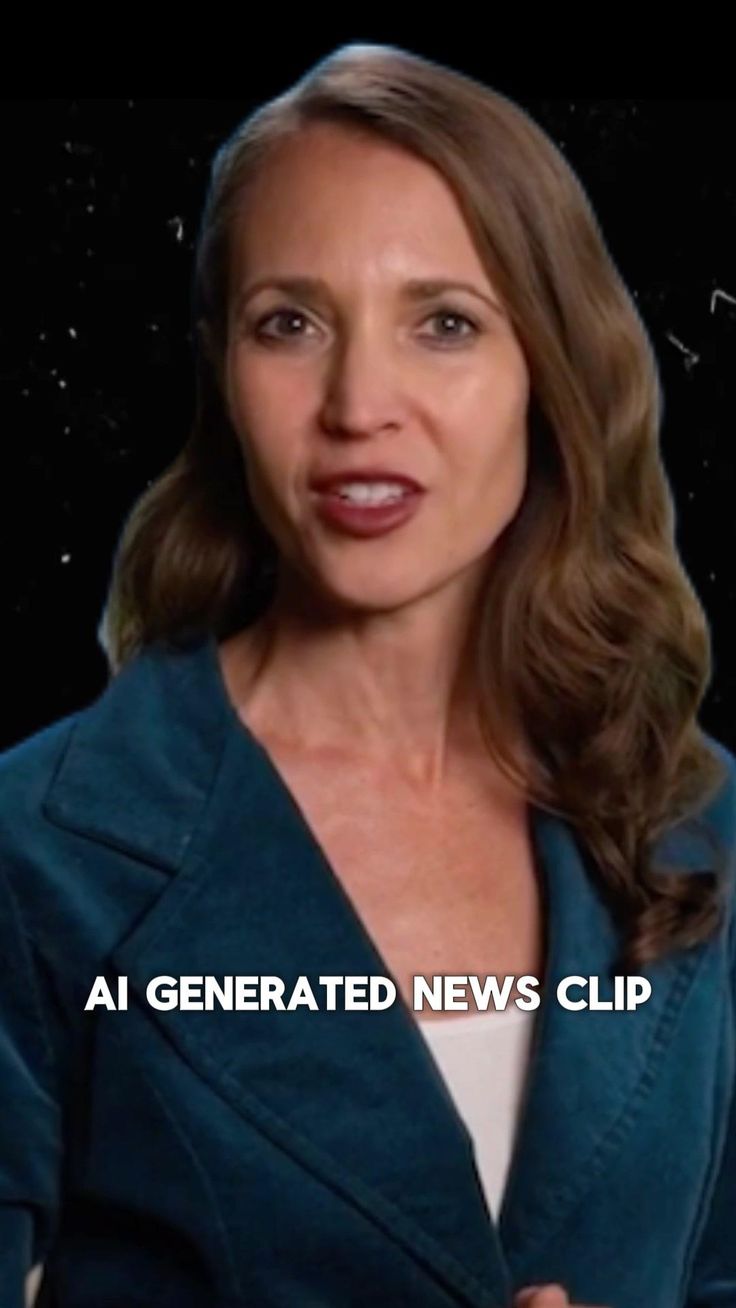
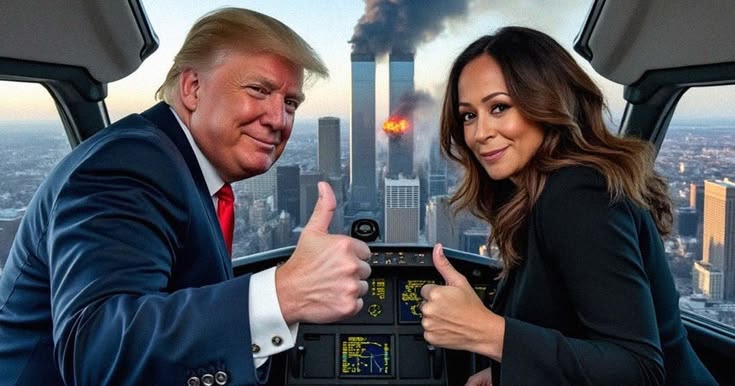
- La composición de advertencia/comparación «esto es generado por IA» es un gran género: sellos para identificar falsificaciones, imágenes divididas Human/AI y capturas de vídeos generados por IA al estilo de un presentador de noticias; destaca contenido que enseña «cómo distinguirlo» o amplifica la desconfianza [3, 32, 39, 42, 43, 44, 45, 48].
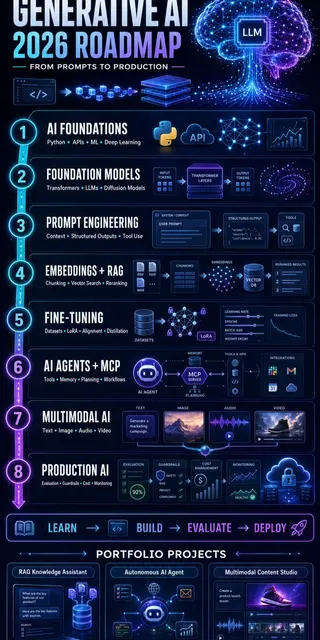
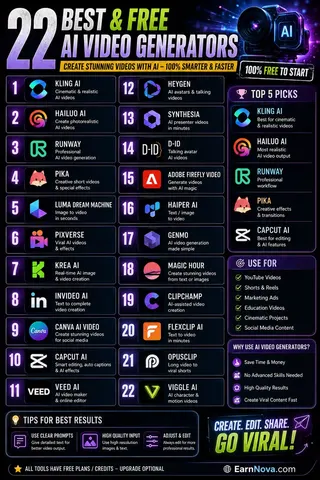
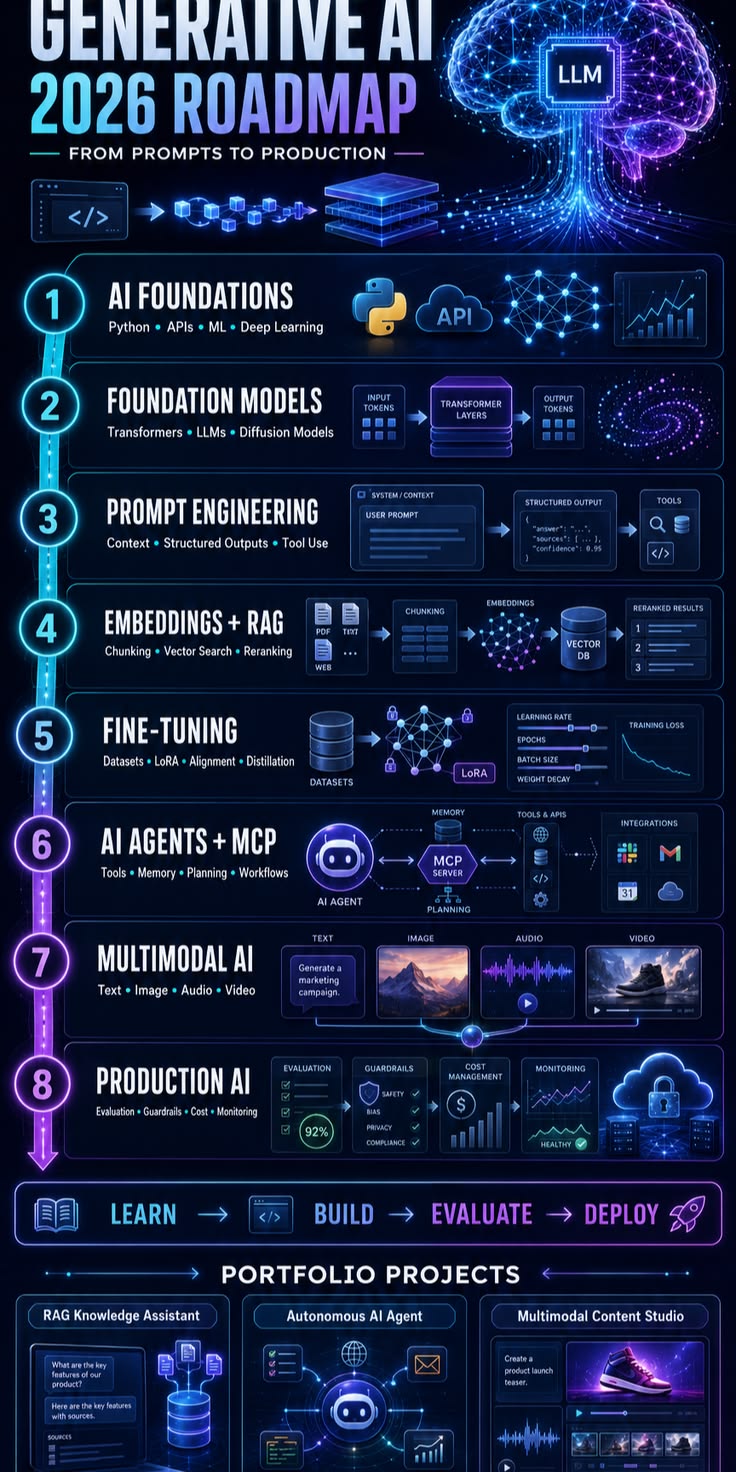
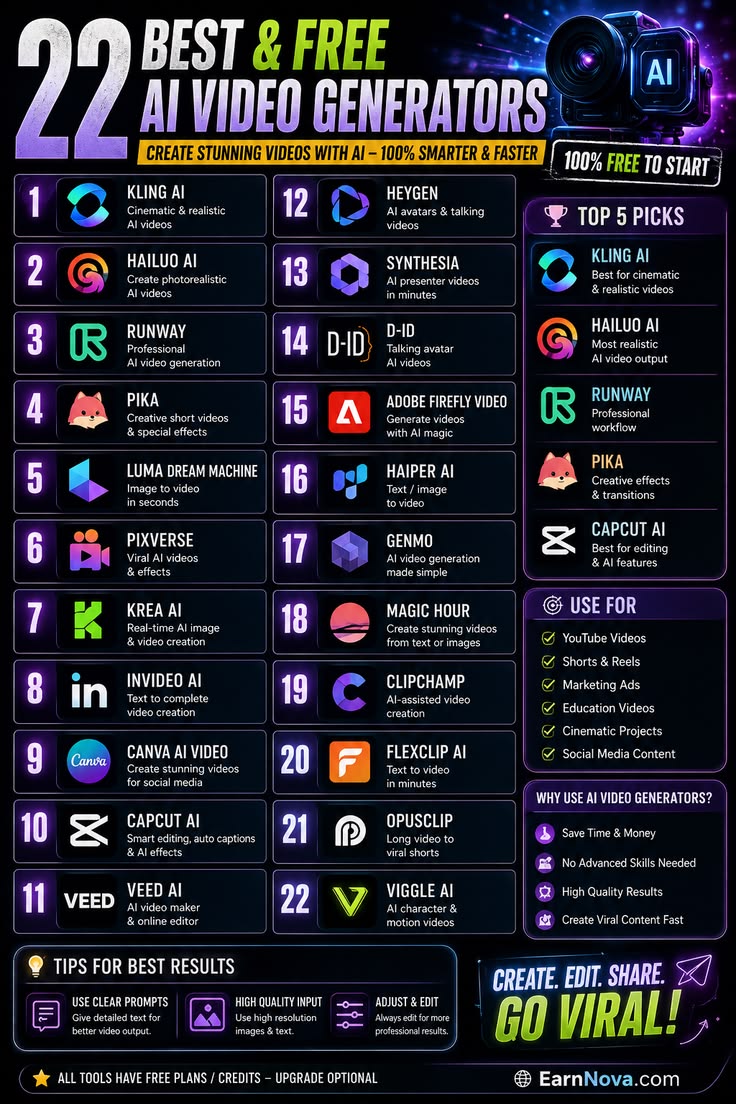
- Infografías de comparación/ranking de herramientas (UI de lista vertical): abundan las guías para elegir, como «Best Quality vs Best Free» y «22 Best & Free AI Video Generators», con logotipos de varias herramientas [7, 47]. Los diagramas de hoja de ruta (itinerarios de aprendizaje) pertenecen al mismo grupo [34].
- Miniaturas con logotipos/nombres de productos de grandes actores cerrados en primer plano: los logotipos de Google Gemini/Omni, Veo3, Kling AI, Luma Dream Machine y OpenAI ocupan posiciones prominentes [1, 9, 13, 19, 31, 33, 47]. En cambio, apenas aparecen imágenes centradas en código abierto (Stable Diffusion, ComfyUI o LoRA); la única de Stability AI [49] es también un collage de presentación de productos, no una pantalla de flujo de trabajo real.
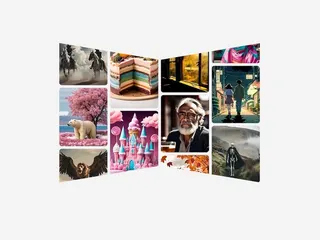
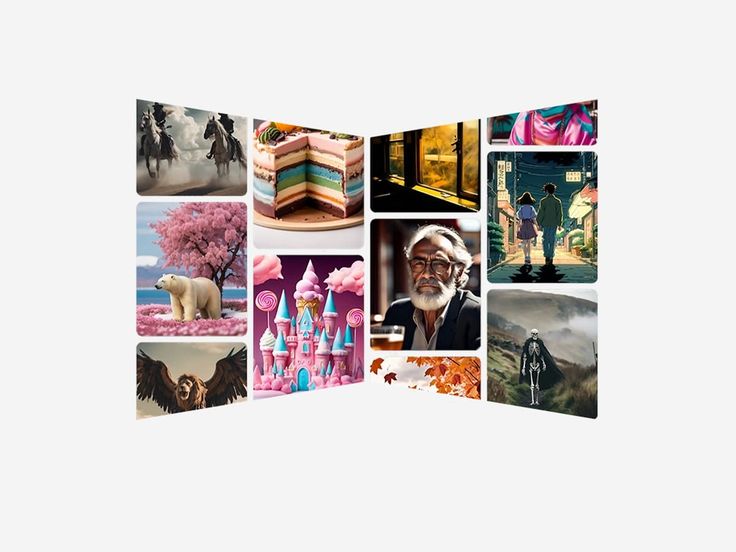
- Demostraciones de «convertir una imagen en múltiples estilos»: hay cuadrículas comparativas que transforman la misma foto de una persona para que parezca hecha de bloques de madera, origami, Lego o flores. Funcionan como demo de la capacidad expresiva de IA de edición de imágenes [2].
- Primeros planos de ojos y el motivo de «indistinguible de lo real»: el ojo en primer plano de Luma Dream Machine [33] y efectos macro de comparación IA/humano [43] enfatizan visualmente el «realismo».
- La combinación de logotipos empresariales reales o documentos gubernamentales con texto superpuesto crea un aspecto noticioso: fotos de carteles de Google [28], imágenes tipo documento vinculadas a legislación del estado de Nueva York [18] y otros formatos de «resumen de noticias» con foto de stock + superposición de texto.
Pines destacados
- [1] "AI News: Anthropic Leak Shows Us The Future of AI..." — Composición típica de miniatura de YouTube: «cara sorprendida + logotipos de Big Tech (OpenAI/Google/Microsoft)». Es la plantilla misma de un vídeo de noticias de IA.
- [2] "Google announces ultra-high quality video..." (en realidad, una cuadrícula de demostración de transformación de imágenes) — Comparación consecutiva de una fuente convertida a estilos de talla de madera, origami, Lego y trabajo floral. Ejemplo representativo de mostrar visualmente la expresividad de IA de edición de imágenes.
- [9] "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API" — Promociona generación rápida de vídeo y audio nativo usando Veo3 a través de Gemini API. Material promocional de una función reciente de código cerrado.
- [13] "Kling.ai AI-Powered Text-to-Video Generation" — Pin vertical que recomienda Kling AI con formato «My Top Picks». Refleja el alto reconocimiento de esta herramienta china de vídeo de código cerrado.
- [19] "Google's Gemini Omni Turns Anything Into Video" — Imagen de marca que condensa la integración multimodal (imagen, audio y texto → vídeo) en un icono.
- [31] "'Amuse 3.0', an AI art creation tool that includes..." — Retrato fotorrealista de una herramienta local de creación artística por IA patrocinada por AMD. Uno de los pocos ejemplos que promueven generación en dispositivo.
- [32] "AI news videos blur line between real and fake reports" — Imagen fija de un reportero de noticias generado por IA al estilo NBC con marca de agua "AI GENERATED". Simboliza la preocupación por el abuso de IA generativa en las noticias.
- [44] "AI News Anchors & Creator-Led Coverage Take Over U.S. Media!" — Ilustración compuesta de una sala de redacción vista desde arriba que presenta el auge de presentadores de IA y cobertura liderada por creadores.
- [47] "22 Best & Free AI Video Generators in 2026" — Infografía que clasifica 22 herramientas como Kling, Hailuo, Runway, Pika y Luma. Ejemplo típico del contenido de selección de herramientas que promociona planes gratuitos.
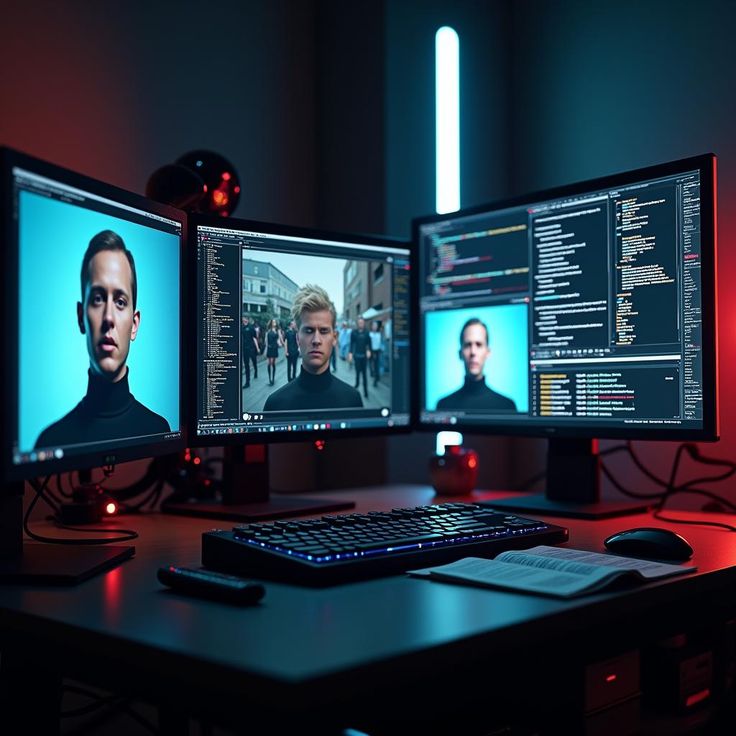
- [49] "Stability AI's Stable Diffusion Maker Can Now Build AI Generative Video" — Collage relacionado con Stability AI (ambiente de oficina + pantalla de código + ejemplo de retrato generado). Es uno de los pocos casos abiertos encontrados, pero no muestra una UI ni nombres de modelos concretos.
Señales
- Pinterest actual está cerca de ser monocromático en «generación de vídeo de código cerrado»: Veo3/Gemini Omni, Kling AI, Luma Dream Machine y Runway aparecen repetidamente con logotipos. Las infografías de comparación de herramientas [7, 47] también enumeran casi exclusivamente herramientas SaaS cerradas. Aunque existe el eje de «gratis/abierto», no es el contexto de «código abierto y autoalojado».
- La desconfianza hacia contenido generado por IA y cómo detectarlo tiene una demanda fuerte, propia de Pinterest: clasificación de falsificaciones, abuso en noticias e imágenes comparativas de Human or AI? constituyen un género independiente. A diferencia de los debates técnicos de Reddit o sitios de noticias, Pinterest los consume como infografías educativas.
- Los temas propios de código abierto (ComfyUI, LoRA, modelos OSS chinos como Wan/HunyuanVideo y debates de licencias) están prácticamente ausentes. Solo se encontró un caso relacionado con Stability AI; no aparecieron pantallas de flujos de trabajo concretos ni creaciones de comunidad.
- Las métricas de interacción (guardados y me gusta) no estaban incluidas en los datos recopilados, por lo que no es posible determinar qué pines son realmente populares solo por las imágenes.
Límites
- Solo se abrieron y comprobaron 26 de 50 imágenes; de las otras 24 se consultó únicamente la lista de títulos en
pinterest.pins.md. - La recopilación de Pinterest fue ejecutada previamente por un trabajador, por lo que no se ajustaron búsquedas ni consultas manualmente. Son resultados de una sola consulta en inglés; no fue posible repetir la búsqueda en japonés ni filtrando por «open source»/«closed source».
- La recopilación contiene solo imágenes fijas, por lo que, pese al tema de generación de vídeo, no se pudieron comprobar resultados generados en movimiento. Las conclusiones se limitan a inferencias a partir de miniaturas e imágenes promocionales.
- Los datos no incluyen métricas de interacción como guardados o comentarios, por lo que no se puede evaluar popularidad ni difusión.
Acciones recomendadas
- Revisar semanalmente el ecosistema ComfyUI alrededor de Qwen-Image-2.1 y Minimax H3.
- Dejar de basar la recopilación de X en tendencias regionales y volver a buscar con palabras clave que apunten directamente a IA de generación de imágenes y vídeo.
- Seguir la reconfiguración de los actores cerrados de vídeo tras Sora (Veo, Kling, Grok, Runway y Seedance).
- Usar Pinterest como referencia del lenguaje visual, no como indicador de popularidad, porque no ofrece métricas de esta.
- Seguir observando la expansión de la desconfianza hacia contenido generado por IA y el debate sobre la obligatoriedad de marcas de agua.
- Repetir la recopilación de Reddit con consultas específicas de open/closed source para aproximarse al criterio de finalización.
Imágenes recopiladas






























Nota sobre la calidad de los datos
X tuvo 0 publicaciones relevantes por un error de geolocalización y búsquedas dependientes de términos de tendencia; Bluesky tuvo un sesgo hacia artículos de una cuenta debido a que la API de búsqueda devolvía 403; Pinterest no tenía métricas de interacción; no se pudieron obtener visualizaciones de YouTube; la información abierta de Lemmy se concentró de hecho en una comunidad, y Reddit se quedó en 12 hilos, por debajo del criterio de finalización de 20.