Noticias de IA para generación de imágenes y vídeo — 2026-10-02
Los modelos chinos de código abierto (Qwen-Image-2.1, Z-Image Turbo) se acercan a los líderes propietarios, justo cuando la confianza en estos últimos se erosiona por las barreras de seguridad, el uso indebido y la economía de Sora.
Los modelos chinos de código abierto (Qwen-Image-2.1, Z-Image Turbo) se acercan a los líderes propietarios, justo cuando la confianza en estos últimos se erosiona por las barreras de seguridad, el uso indebido y la economía de Sora.
Noticias de IA para generación de imágenes y vídeo — 2026-10-02
Ahora mismo, el mundo de la IA para generar imágenes y vídeo está de locos 😤. Los actores propietarios (GPT Image 2.5 de OpenAI, Veo 3.1/Nano Banana 2.0 de Google, Kling 2.5, Seedance 2.5 y otros) no paran de añadir funciones, pero a la vez avanzan las historias que minan la confianza: controles más estrictos, deepfakes y las enormes pérdidas de Sora 💸. Por otra parte, el lado abierto está ganando fuerza de verdad gracias a empresas chinas como Alibaba (Qwen-Image-2.1, Z-Image Turbo), y la cultura de experimentar intensamente en local alrededor de ComfyUI se confirmó en Reddit, Lemmy y Bluesky 🔥. Esta vez revisé seis plataformas —Reddit, X, YouTube, Bluesky, Lemmy y Pinterest—, pero X fue un fracaso total, así que lo informo con honestidad 👇.
En todas las plataformas
- El código abierto chino está en ascenso y suele presentarse como «alternativa a los modelos propietarios» 🇨🇳 En YouTube se dice que Z-Image Turbo (6B de parámetros y funciona con 6 GB de VRAM) superó a Flux 2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), y que Qwen-Image-Edit está a la altura de Nano Banana o lo supera (https://www.youtube.com/watch?v=AIgYj5RG-FQ). En Lemmy también aparecieron durante la misma semana una WebUI y LoRA en torno a Qwen-Image-2.1 (https://github.com/ogoun/fooocus-qwen-image-2.1), mientras que Simon Willison probó Qwen-Image en hardware real en Bluesky (https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223). Como ocurre a la vez en varias plataformas, parece una tendencia auténtica.
- El endurecimiento de las barreras de seguridad está expulsando a usuarios 🚪 En Reddit, hay personas que abandonan ChatGPT por sus rechazos y se pasan a Midjourney, Grok o Venice AI (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/); otras se trasladan a Seedream Unfiltered o MiniMax H3 después de que DreamFort.ai reforzara sus filtros (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). En Bluesky, expertos alertan de que modelos de pesos abiertos como GLM-5.3 casi no tienen barreras de seguridad (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o). En todas las redes se aprecia una polarización entre regulación más estricta y ausencia de reglas.
- La «confianza» en el software propietario se tambalea desde varios frentes simultáneamente ⚠️ Una investigación de TIME difundida en Bluesky mostró que Veo3 podía crear vídeos falsos de un templo hindú ardiendo (https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h); en Reddit se denunció que Photoshop/Apple Photos etiquetan incluso recortes normales como «edición con IA» y eliminan los créditos (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). El uso malicioso y el etiquetado erróneo son problemas distintos, pero ambos alimentan la idea de que no se puede confiar en herramientas cerradas.
- ComfyUI se ha convertido por completo en el espacio de trabajo predeterminado del lado abierto 🛠️ El mismo nombre aparece en Reddit (nodos para MiniMax-H3, https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/), Lemmy (inpainting LanPaint, https://github.com/scraed/LanPaint/), Bluesky (ilustraciones diarias con Krea2, https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t) y YouTube (tutoriales de instalación que salen inmediatamente con cada modelo nuevo).
- Las comparativas lado a lado se han convertido en contenido imprescindible 📊 Títulos de YouTube como «WAN 2.5 is Open Source Veo3», comparativas de Lemmy coloreando la misma doble página de Berserk con cuatro modelos (https://www.reddit.com/gallery/1wfyqdy) y gráficos neón de Pinterest que dicen «este si pagas, este si quieres gratis». A la gente le interesa más saber cuál es mejor que las noticias aisladas.
- La tesis de que el vídeo con IA para consumidores no es rentable quedó confirmada por varias fuentes 💰 Un post de Bluesky calcula unos costes anuales de operación de Sora2 de aproximadamente 5.000 millones de dólares frente a unos ingresos de 1,4 millones (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o); en Lemmy se analiza que OpenAI cerrará la API de Sora el 24 de septiembre, mientras empresas orientadas a clientes corporativos como Kling levantan financiación (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
Plataforma por plataforma
Reddit 🟠 Se analizaron 12 hilos de 9 subreddits. En el lado propietario, lo que más creció fue la noticia de que Seedance 2.5 (a través de Higgsfield) ya permite a una sola persona hacer un corto de diez minutos con personajes coherentes (784 puntos, https://www.reddit.com/r/accelerate/comments/1wqqr4p/). En el lado abierto, los nodos de ComfyUI para MiniMax-H3 recibieron elogios como «el mejor nodo que he usado» (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). Aquí también aparecieron las quejas más concretas sobre barreras de seguridad.
X ⚫️ Aquí fue un fracaso total 😅. Las 40 publicaciones recopiladas (33 cuentas) trataban de fútbol, K-pop, política británica y realities, sin nada sobre generación de imágenes o vídeo con IA. Las búsquedas del trabajador usaron términos como «Halloween», «Ronaldo» y «#bb28», es decir, la pestaña de tendencias de X tal cual, en vez de palabras relacionadas con IA. La parte de X no aporta información al informe esta vez.
YouTube 🔴 En el lado propietario coincidieron vídeos que valoran la función «Sketch» de GPT Image 2.5 (https://www.youtube.com/watch?v=LYUr4BY33h4), la apertura gratuita de Veo 3.1 (https://www.youtube.com/watch?v=uj6eD31OxkA) y Nano Banana 2.0 como «mejor que Photoshop» (https://www.youtube.com/watch?v=u22-XoQvI4I), lo que deja claro que la carrera de funciones avanza muy deprisa. En el lado abierto, se multiplican los tutoriales sobre cómo ejecutar FLUX.2, Z-Image y Qwen-Image-Edit en ComfyUI. Hay que tener en cuenta que no se pudieron obtener reproducciones, suscriptores ni comentarios por el renderizado con JavaScript: el análisis se basa solo en títulos e información de oEmbed.
Bluesky 🔵 Se consultó directamente la API de AT Protocol y se seleccionaron publicaciones relevantes de más de 100 datos reales. En el lado propietario, destacaron con mucha diferencia el problema de contenido racista generado por Veo3 (❤️842, https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y) y el colapso económico de Sora2 (❤️1.375). En el lado abierto, investigadores que prueban modelos de verdad, como Simon Willison y Ethan Mollick, tratan Qwen-Image y GLM-5.3. También se confirmaron numerosas publicaciones cotidianas con ComfyUI + Krea2.
Lemmy 🟢 !«メールアドレス» es el núcleo, aunque sus puntuaciones son pequeñas, normalmente de un dígito a alrededor de 10. Aun así, herramientas alrededor de Qwen-Image-2.1 —WebUI, LoRA y ControlNet— se publicaron una tras otra en la misma semana, señal de impulso. Las noticias de modelos propietarios (cierre de la API de Sora; retirada en un día de la función Google Earth de Nano Banana 2 por uso indebido, https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/) llegan casi todas mediante el bot espejo de Reddit !ai_reddit; apenas hay debate propio de Lemmy.
Pinterest 🟣 Se abrieron y revisaron 18 de 50 pines. Predominan claramente las imágenes-resumen de noticias del lado propietario (miniaturas con logotipos de OpenAI/Google/Meta/Grok y rostros sorprendidos); en el lado abierto, AMD Amuse 3.0 es casi el único nombre concreto. Un hallazgo interesante es que las demostraciones fotorrealistas de personas —rostros cuidados hasta las arrugas y las texturas— se usan como visual de referencia común entre empresas. No se pudieron obtener cifras de interacción (guardados/me gusta), y los pines se limitaron a los recogidos previamente por el trabajador.
Qué vigilar
- La velocidad de expansión de las herramientas en torno a Qwen-Image-2.1 — En Lemmy se sucedieron WebUI/LoRA/ControlNet durante la misma semana (https://github.com/ogoun/fooocus-qwen-image-2.1). Vale la pena observar qué aparece después.
- Cómo afectarán los problemas económicos de Sora2 a la estrategia de OpenAI — Es un tema candente tanto en Bluesky (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o) como en Lemmy (cierre de la API de Sora, https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
- La polarización regulación⇄ausencia de reglas provocada por las barreras de seguridad — Es la misma estructura vista desde direcciones distintas en Reddit (https://www.reddit.com/r/generativeAI/comments/1wtzefv/) y Bluesky (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o).
- FLUX 3 de Black Forest Labs — Es un lanzamiento cerrado y limitado (imagen + vídeo de 20 segundos con audio), pero FLUX.2 también se publica en paralelo con pesos abiertos (https://bfl.ai/blog/flux-3). Conviene seguirlo como ejemplo de la difuminación de la frontera entre abierto y cerrado.
- La línea de bajo consumo de VRAM de Z-Image / Qwen-Image — En YouTube se dice que supera a Flux2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), con potencial para ampliar la base de usuarios locales.
- La necesidad de volver a investigar X — Esta vez falló por usar por error la pestaña de tendencias; una nueva recopilación con palabras clave directas como "Midjourney", "Sora" o "Nano Banana" probablemente revelaría hallazgos interesantes.
Recomendaciones
- La próxima vez, X (Twitter) debería recopilar datos con palabras clave directas de IA como "Midjourney", "Sora", "Nano Banana", "ComfyUI" y "Flux".
- El rápido crecimiento del ecosistema Qwen-Image-2.1 debería vigilarse de forma continua como punto de referencia de las tendencias de código abierto.
- La relación entre costes operativos e ingresos de Sora2 debería seguirse como indicador de rentabilidad para el conjunto de los modelos propietarios de generación de vídeo.
- Debería mapearse de forma continua la fuga de usuarios provocada por las barreras de seguridad: de qué herramienta huyen y a cuál se trasladan.
- Pinterest debería ampliar el muestreo visual a los 50 pines o considerar otro método para obtener cifras de interacción.
- Dada la dependencia de Lemmy de !ai_reddit (en la práctica, republicaciones de Reddit), las voces propias de Lemmy deberían buscarse sobre todo en comunidades como !stable_diffusion.
Calidad de los datos
Los datos recopilados de X eran completamente ajenos al tema de investigación —un error al usar la pestaña de tendencias—, por lo que no pudieron contribuir en absoluto esta vez. Por el renderizado con JavaScript, YouTube no permitió comprobar visualizaciones, fechas de publicación, suscriptores ni comentarios; el análisis se limita a títulos e información de oEmbed. En Pinterest solo se verificaron visualmente 18 de 50 elementos y no se obtuvieron cifras de interacción (guardados/me gusta). En Lemmy sí se confirmaron las publicaciones, pero sus puntuaciones suelen estar entre 0 y 10, por lo que la intensidad de la conversación es menor que en otras plataformas. Reddit y Bluesky sí permitieron análisis basados en datos reales y son, relativamente, las fuentes más fiables.
Resumen por plataforma
Reddit — Noticias de IA para generación de imágenes y vídeo
Dónde
9 subreddits trataron este tema en el conjunto recopilado (12 hilos en total, todos encontrados mediante el único término de búsqueda "Image and Video Generation AI News"):
- r/generativeAI — 159.938 miembros — 3 hilos (#1, #2, #7)
- r/TopologyAI — 24.052 miembros — 1 hilo (#3)
- r/StableDiffusion — 1.027.672 miembros — 1 hilo (#4)
- r/LocalLLaMA — 838.632 miembros — 1 hilo (#5)
- r/AI_Agents — 452.911 miembros — 1 hilo (#6)
- r/accelerate — 93.680 miembros — 2 hilos (#8, #12)
- r/aifails — 39.194 miembros — 1 hilo (#9)
- r/VideoEditors — 81.700 miembros — 1 hilo (#10)
- r/mildlyinfuriating — 12.610.232 miembros — 1 hilo (#11)
Lo que dice la gente
- La generación de vídeo «gratuita» de modelos propietarios es un mito, según el consenso de la comunidad — Hilo #1, r/generativeAI, 71 puntos, 46 comentarios, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wty6zj/). El autor sostiene que el coste de las GPU en la nube impide una generación de vídeo realmente ilimitada y gratuita; u/opengradient lo respalda: «los vídeos no son como los LLM baratos, nadie puede regalarlos gratis» (5 puntos).
- El filtrado NSFW de los modelos propietarios se endurece y empuja a usuarios hacia alternativas abiertas o sin filtrar — Hilo #2, r/generativeAI, 7 puntos, 14 comentarios, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). DreamFort.ai endureció sus filtros basados en WAN 3.0; u/opengradient señala que «muchos proveedores de modelos propietarios han introducido controles más estrictos recientemente (incluida Alibaba, propietaria de Wan 3.0)» y apunta a Seedream 2.0 Unfiltered y MiniMax H3 como alternativas.
- El flujo de trabajo de código abierto + Blender 3D se presenta como solución al control en generación de vídeo, pero la comunidad no está segura de que sea real — Hilo #3, r/TopologyAI, 437 puntos, 19 comentarios, 2026-09-28 (https://www.reddit.com/r/TopologyAI/comments/1wsmvvm/). Pese a la puntuación elevada, los comentarios principales son preguntas confundidas («¿Qué “IA 3D” es esta?» — u/stevester911, 5 puntos) y un rechazo directo de u/amon_de_no: «Eso es IA falsa de verdad» (5 puntos).
- Las herramientas abiertas de coherencia de referencia para MiniMax-H3 están siendo recibidas extraordinariamente bien — Hilo #4, r/StableDiffusion, 690 puntos, 51 comentarios, 2026-09-30 (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). Un nodo gratuito de ComfyUI (Fantastic-MiniMaxH3-PromptBuilder) corrigió la contaminación de identidad en ediciones de vídeo con imágenes de referencia; u/ClassicUse2579: «El cargador multimedia H3 es uno de los mejores nodos de Comfy que he usado. ¡Es condenadamente bueno!» (3 puntos).
- Las pilas locales abiertas de imagen/chat son lo bastante maduras como para funcionar como curiosidad — Hilo #5, r/LocalLLaMA, 194 puntos, 96 comentarios, 2026-10-01 (https://www.reddit.com/r/LocalLLaMA/comments/1wuxzdg/). Un Tandy 1000 de los años noventa usa WiFi para conectar con Qwen3.8-27B + Krea 2 (ComfyUI), ejecutados localmente, para chat y generación de imágenes. Sin embargo, el comentario principal cuestiona el enfoque: u/Aggravating-Push-207 (113 puntos): «Pero esto no se ejecuta en el Tandy; solo hace solicitudes dentro de tu red doméstica».
- Las barreras de seguridad de los modelos propietarios frustran a usuarios casuales hasta enviarlos a alternativas — Hilo #6, r/AI_Agents, 0 puntos, 22 comentarios, 2026-09-29 (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/). Un usuario no logra que ChatGPT represente a un superhéroe por los rechazos de las barreras de seguridad; los comentarios lo redirigen a Midjourney, Grok, VeniceAI y modelos abiertos «uncensored sdxl».
- En el extremo gratuito o barato, las herramientas propietarias de créditos diarios siguen dominando las recomendaciones casuales — Hilo #7, r/generativeAI, 4 puntos, 59 comentarios, 2026-09-26 (https://www.reddit.com/r/generativeAI/comments/1wqfleb/). Las recomendaciones se dividen: u/Scuzzy_Womack sugiere ComfyUI sin conexión (3 puntos, abierto), mientras otros recomiendan Yodayo/MoescapeAI y Leonardo por sus créditos gratuitos diarios (cerrados).
- El vídeo propietario (Seedance 2.5 vía Higgsfield) ya es lo bastante bueno para un corto narrativo de diez minutos hecho por una persona — Hilo #8, r/accelerate, 784 puntos, 196 comentarios, 2026-09-26 (https://www.reddit.com/r/accelerate/comments/1wqqr4p/). Se usan referencias de hojas de personaje en cada plano para mantener consistente a Captain Walker entre escenas; u/JoseLunaArts (95 puntos) dice que el encuadre de «sin presupuesto» minimiza los costes de tokens, y u/Nabugu (7 puntos) señala el problema recurrente de la uniformidad de las caras guapas de IA.
- La generación de imágenes aún falla de formas absurdas y dignas de meme: se descarta como entretenimiento, no como tendencia — Hilo #9, r/aifails, 526 puntos, 76 comentarios, 2026-09-28 (https://www.reddit.com/r/aifails/comments/1ws6jzs/). Un prompt sobre anatomía de pollo produjo un disparate anatómico; el comentario principal de u/kasimirvendom: «Todo tiene un final; solo un pollo tiene dos» (52 puntos).
- A los editores de vídeo se les dice explícitamente que todavía no dependan de herramientas de IA — Hilo #10, r/VideoEditors, 4 puntos, 39 comentarios, 2026-09-26 (https://www.reddit.com/r/VideoEditors/comments/1wqkx27/). Comentario principal (u/VisibleExplanation, 33 puntos): «Olvida cualquier herramienta de IA. Descarga Davinci Resolve y aprende a usarlo... Ninguna herramienta de IA te dará buenos resultados si no tienes conocimientos fundamentales de lo básico».
- Las herramientas de edición propietarias que reclasifican discretamente cambios menores como «IA generativa» provocan rechazo por pérdida de confianza — Hilo #11, r/mildlyinfuriating, 1.268 puntos, 136 comentarios, 2026-09-28 (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). Al parecer, Photoshop/Apple Photos etiquetan recortes simples como editados con IA y eliminan la atribución de copyright; u/Kagevjijon (41 puntos): «No hay forma de que esto se mantenga así. Es un robo real». Una objeción de u/teh_maxh (135 puntos): «Acabo de intentar recortar una foto con Photoshop y no añadió metadatos afirmando que usé GAI».
- Los mods de videojuegos generados con IA (abiertos e impulsados por la comunidad) están viviendo un momento de auge — Hilo #12, r/accelerate, 193 puntos, 35 comentarios, 2026-09-30 (https://www.reddit.com/r/accelerate/comments/1wuhyiw/). u/Chopstik0-0 (38 puntos) describe cómo el subreddit de modding de VR pasó de la resistencia a la emoción cuando quedó claro que «nadie más está haciendo realmente juegos nuevos de VR».
Señales
- En ascenso: Las herramientas abiertas de coherencia de referencia (el nodo de ComfyUI del hilo #4 y la pila local Qwen+Krea2 del hilo #5) reciben los elogios más inequívocos del conjunto: puntuaciones altas acompañadas de comentarios técnicos y realmente positivos, no solo entusiasmo.
- En ascenso: La generación de vídeo propietaria ha entrado en el territorio narrativo de formato largo: el corto de diez minutos del hilo #8 con personajes recurrentes coherentes es el hilo recopilado con más interacción (784 puntos, 196 comentarios), y las críticas de la comunidad se dirigen al guion y la actuación de voz, no a los visuales.
- Descartado: La idea de un generador de vídeo propietario «verdaderamente gratuito» se considera resuelta y algo cansina (hilo #1): el debate se ha desplazado de «qué web gratis» a «qué configuración local abierta».
- Desacuerdo: El hilo #3 muestra una división entre la emoción superficial (437 puntos) y el escepticismo/confusión en los comentarios sobre lo que realmente se muestra; recuerda que las publicaciones vagas sobre flujos de trabajo de «IA 3D» pueden acumular puntos con este término de búsqueda sin que nadie se ponga de acuerdo sobre la herramienta.
- Sorpresa — las barreras de seguridad son ahora un motor recurrente de cambio de plataforma, no solo una molestia: tanto el hilo #2 (endurecimiento de filtros NSFW de modelos propietarios) como el #6 (barreras de ChatGPT que bloquean una imagen no explícita de un superhéroe) muestran usuarios que abandonan una herramienta cerrada específicamente por moderación, y que terminan cada vez en otra cerrada (Grok, VeniceAI) o en una abierta (Seedream Unfiltered, SDXL sin censura).
- Sorpresa — el rechazo por confianza hacia herramientas propietarias no trata de filtros de contenido en absoluto en el hilo #11: trata de atribución/metadatos (etiquetar automáticamente ediciones normales como «IA generativa» y eliminar información de copyright), una queja distinta de la frustración por barreras de seguridad en el resto del conjunto.
Límites
- El recopilador solo utilizó un término de búsqueda ("Image and Video Generation AI News"), que obtuvo 12 hilos en 9 subreddits, menos del objetivo de aproximadamente 20 publicaciones por red de los criterios de finalización. Según el manual, solo leí lo que el trabajador ya había recopilado (
output/reddit.threads.md) y no navegué Reddit por mi cuenta para complementarlo, ya que Reddit bloquea WebFetch y las páginas a las que lleva una búsqueda web. - Los hilos #9, #11 y #12 no tenían texto de apertura capturado (solo título), por lo que esos hallazgos se basan por completo en comentarios y puntuaciones.
- No aparecieron hilos centrados específicamente en grandes anuncios de laboratorios propietarios (por ejemplo, el lanzamiento de un modelo con nombre de OpenAI/Google/Midjourney): el conjunto recopilado se inclina hacia experiencia de usuario, herramientas y fricción por barreras de seguridad, más que hacia noticias de lanzamientos.
X
X — Noticias de IA para generación de imágenes y vídeo
Cuentas
Ninguna cuenta de los datos recopilados está hablando de IA para generación de imágenes o vídeo, ya sea de código propietario o abierto. Las 33 cuentas capturadas aquí (@Davesonude, @rcostadoazeite, @ChrisExcel102, @Louissaikyoo, @DlugoszMarcin, @khtaeverse y otras 27) son cuentas de memes deportivos, fandoms de K-pop, fans de Big Brother (#BB28), política británica (Restore Britain) y memes/shitposts generales. Ninguna publica sobre herramientas de imagen o vídeo con IA como tema principal, así que no hay ningún «quién está impulsando esto en X» que informar para el tema real de investigación; véase ## Límites.
Publicaciones
Ninguna publicación de output/x.posts.md (40 publicaciones, 33 cuentas) menciona IA de generación de imágenes, IA de generación de vídeo ni productos, empresas o proyectos de código abierto relacionados (no hay menciones de Midjourney, Sora, Stable Diffusion, Flux, Runway, Veo, Nano Banana, ComfyUI o similares). La comprobación puntual de las publicaciones con mayor interacción lo confirma:
- Publicación #7, @Davesonude, ~291.000 visualizaciones, 22.958 me gusta (2026-09-30),
https://x.com/Davesonude/status/2105273235965370529 — un meme de fútbol de Ronaldo. Encontrado al buscar "Ronaldo". - Publicación #19, @ChrisExcel102, ~343.000 visualizaciones, 7.886 me gusta (2026-09-29),
https://x.com/ChrisExcel102/status/2104913863200096350 — un meme sobre una relación de celebridades. Encontrado al buscar "JubJub". - Publicación #26, @Louissaikyoo, ~185.000 visualizaciones, 10.292 me gusta (2026-09-30),
https://x.com/Louissaikyoo/status/2105090778766696620 — una broma de trivia de Disney Channel. Encontrado al buscar "China". - Publicación #36, @DlugoszMarcin, ~189.000 visualizaciones, 2.937 me gusta (2026-09-30),
https://x.com/DlugoszMarcin/status/2105363575145394223 — comentario futbolístico (Messi/Lewandowski/Ronaldo/Modrić). Encontrado al buscar "Messi".
Ninguna de estas ni las 36 publicaciones restantes trata el tema de investigación. No enumero de 5 a 12 «hallazgos» sobre generación de imágenes/vídeo con IA porque no existen en el material recopilado: hacerlo implicaría inventarlos, algo que el manual de esta ejecución prohíbe explícitamente.
Señales
No puede extraerse ninguna señal sobre IA de generación de imágenes/vídeo abierta o propietaria de este conjunto de datos. Lo que sí muestran los datos es que los diez términos de búsqueda usados para recopilarlo ("Halloween", "Ronaldo", "Britain", "Yess", "JubJub", "Gold", "China", "#bb28", "Messi", "Balkans") son tendencias de la propia pestaña Explorar de X para la ubicación de esta sesión, no temas de generación de medios con IA. La tabla Explorar de output/x.posts.md lo confirma: 6 de las 10 tendencias se etiquetan explícitamente como "Trending in Croatia", y el resto ("Ronaldo", "Britain", "China", "Messi") son tendencias globales de deportes/política, ninguna relacionada con IA o tecnología. Parece un desajuste en la fase de recopilación: el trabajador obtuvo lo que X marcaba como tendencia, en lugar de buscar términos de generación de imágenes/vídeo con IA, por lo que las 40 publicaciones resultantes son sobre fútbol, un partido político británico (Restore Britain), una disputa de fandom de K-pop, una temporada de reality TV (#BB28) y memes no relacionados.
Límites
- Los datos recopilados no abordan el encargo de investigación. El encargo pide noticias de IA de generación de imágenes/vídeo tanto propietaria como de código abierto; los diez términos de búsqueda del trabajador eran tendencias genéricas de X para esta sesión (geolocalizada predominantemente en Croacia según la tabla Explorar), no consultas relacionadas con IA. Las 40 publicaciones recopiladas se revisaron manualmente frente al tema y ninguna cumple los requisitos.
- Según el manual de esta fase, no navegué X personalmente (un lector anónimo no ve nada en X) y me basé únicamente en
output/x.posts.md/output/x.posts.jsontal como fueron recopilados. - Aunque el criterio de finalización («analizar aproximadamente 20 publicaciones por red social») se cumplió en volumen (40 publicaciones analizadas), no se cumplió en relevancia, por lo que esta etapa no puede aportar hallazgos sobre modelos de generación de imágenes/vídeo abiertos o propietarios. La etapa de X debería repetirse con términos como "Midjourney", "Sora", "Stable Diffusion", "Flux", "Runway", "Veo", "Nano Banana", "ComfyUI" o similares, en lugar de las tendencias genéricas usadas en esta ejecución.
YouTube
YouTube — Noticias de IA para generación de imágenes y vídeo (propietaria/código abierto)
Canales
- AI WITH Rithesh (Rithesh Sreenivasan) — Canal individual que prueba el mismo día lanzamientos de ChatGPT/OpenAI.
- Bart Slodyczka — Resume qué cambió justo después del lanzamiento de modelos nuevos.
- Learn with LEESI — Canal especializado en tutoriales de Google Gemini/Veo/Flow.
- WorldofAI(@intheworldofai) — Revisa semanalmente noticias de IA propietaria.
- MattVidPro — Gran canal de IA conocido por comparativas y noticias rápidas de modelos de generación de vídeo.
- There's An AI For That(@theresanaiforit) — Noticias rápidas y comparativas de modelos nuevos.
- Promptus AI(@promptusai) — Especializado en tutoriales de instalación local de modelos abiertos de imagen/vídeo.
- AI Late to Class(@ailatetoclass) — Reseñas de modelos abiertos de edición de imágenes.
- MaxonShire — Especializado en comparativas de modelos locales de generación de vídeo (HunyuanVideo, Wan, LTX, etc.).
- smallzero(@webdot3) — Uso de modelos abiertos con ComfyUI (como Z-Image).
- FlyMyAI — Publica resúmenes diarios/semanales de noticias de IA.
- Lev Selector(@lev-selector) — Canal que recopila actualizaciones semanales de IA.
No se pudo comprobar directamente el número de suscriptores debido al renderizado con JavaScript del HTML de resultados de búsqueda de YouTube (véase Límites).
Vídeos
Código propietario
- «ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked!» — AI WITH Rithesh / principios de septiembre de 2026 — Prueba GPT Image 2.5 de OpenAI, lanzado el 8 de septiembre de 2026, con la función nueva de generación desde boceto «Sketch» y una aceleración de hasta el 50 % en la velocidad de generación. https://www.youtube.com/watch?v=LYUr4BY33h4
- «ChatGPT Image 2.5 Just Dropped — Here's Everything That's New» — Bart Slodyczka / septiembre de 2026 — Repaso completo de las nuevas funciones de GPT Image 2.5. https://www.youtube.com/watch?v=dvpQHWwuaIo
- «Google Just Made VEO 3.1 FREE for Everyone with Unlimited AI Video Generation» — Learn with LEESI — Presenta la apertura gratuita de Veo 3.1 (imagen a vídeo y compatibilidad con tres imágenes de referencia) mediante Google Flow/Vids. https://www.youtube.com/watch?v=uj6eD31OxkA
- «Google's Nano Banana 2.0: Best Text-To-Image Generation Model EVER! The Photoshop killer!» — WorldofAI — Prueba Nano Banana 2.0 de Google DeepMind (generación de imágenes de la familia Gemini) y lo valora como superior a Photoshop. https://www.youtube.com/watch?v=u22-XoQvI4I
- «Kling 2.5 goes BEAST MODE for AI Video!» — MattVidPro — Informa de una gran evolución de Kling 2.5 en el dinamismo del movimiento. https://www.youtube.com/watch?v=SGUxHC1cI1c
- «AI Video Models Are Getting Out of Control! (WAN 2.5, Kling 2.5, Wanimate)» — MattVidPro — Compara lado a lado Kling (propietario) y Wan (abierto), y señala que la competencia se está intensificando. https://www.youtube.com/watch?v=vFXe3uXb75k
- «Your AI news brief for September 3, 2026.» — FlyMyAI — Resumen de noticias generales de IA al 3 de septiembre de 2026, incluidos temas de generación de imágenes/vídeo. https://www.youtube.com/watch?v=JK6w9tA2jH8
- «Exciting AI Updates Weekly - September 25, 2026» — Lev Selector — Recopilación semanal de actualizaciones recientes de IA, dentro de una serie que incluye modelos de generación de imágenes y vídeo. https://www.youtube.com/watch?v=iyZHPCNd8jI
Código abierto
- «Is FLUX 2.0 The New Open Source King?» — There's An AI For That — Considera FLUX.2 de Black Forest Labs un candidato principal como modelo de pesos abiertos para imagen/edición. https://www.youtube.com/watch?v=YQuTkPVkCS8
- «New Open-Source Model DESTROYS Flux 2 — Z-Image + Promptus Tutorial»(el título en oEmbed es «Z-Image Open-Source Image Generator: Free Online and Local Setup») — Promptus AI — Presenta Z-Image Turbo de Tongyi-MAI de Alibaba (6B de parámetros, funciona con 6 GB de VRAM) como superior a Flux 2. https://www.youtube.com/watch?v=JF4Q5hXh-_Q
- «Z-Image Full Release: The New King of AI Influencers in ComfyUI?» — smallzero — Prueba en ComfyUI el lanzamiento completo sin destilar (Base) de Z-Image. https://www.youtube.com/watch?v=ClVY5ll1sDU
- «Qwen Image 2.1 best open source Image Editor. Better than Nano Banana» — AI Late to Class — Valora la versión más reciente de Alibaba Qwen-Image-Edit, con soporte para diez imágenes de referencia, fondo transparente y mayor velocidad, como comparable o superior a Nano Banana. https://www.youtube.com/watch?v=AIgYj5RG-FQ
- «HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model?» — MaxonShire — Compara HunyuanVideo 1.5 de Tencent y Wan 2.7 de Alibaba como modelos locales de generación de vídeo. https://www.youtube.com/watch?v=4GNT4-QYekg
Señales
- Los modelos propietarios compiten por la velocidad al añadir funciones: OpenAI (GPT Image 2.5 «Sketch», 8/9/2026), Google (apertura gratuita de Veo 3.1 + integración con Google Vids/Flow) y la actualización de Kling 2.5 aparecieron casi al mismo tiempo, con una carrera de funciones que continúa mes a mes.
- El bando de código abierto está ganando impulso gracias a empresas chinas (Alibaba Tongyi-MAI, Qwen): Z-Image Turbo y Qwen-Image-Edit se cubren repetidamente desde los ángulos de «funciona con 6 GB/baja VRAM» y «calidad comparable a Nano Banana», y ya se ha consolidado su comparación directa con FLUX.2 de Black Forest Labs.
- Los vídeos de comparación «abierto frente a cerrado» se han convertido en un género: abundan títulos como «WAN 2.5 is Open Source Veo3» o «Z-Image vs Flux 2», donde los modelos abiertos se describen como alternativas a los propietarios.
- Los tutoriales para ejecutar modelos localmente en ComfyUI (Promptus AI, MaxonShire, smallzero) se han vuelto el principal formato de contenido de código abierto: cada vez que sale un modelo se publica enseguida un vídeo de «cómo instalarlo en ComfyUI».
- Los canales de resúmenes diarios/semanales de noticias de IA (FlyMyAI, Lev Selector) cubren continuamente generación de imágenes y vídeo, por lo que las noticias de modelos individuales también se difunden a través de estos canales de actualización periódica.
Límites
- Las páginas de resultados de búsqueda de YouTube (
youtube.com/results?search_query=...) y las páginas de vídeo (youtube.com/watch?v=...) se renderizan con JavaScript, por lo que WebFetch no pudo obtener directamente la lista de vídeos ni el contenido de sus páginas (visualizaciones, fecha de publicación, suscriptores del canal o comentarios). Los títulos y nombres de canal se verificaron individualmente mediante el endpoint JSONyoutube.com/oembed, y el periodo de publicación y contexto se complementaron con fragmentos de búsqueda web y artículos relacionados. - Por ello, no se han podido confirmar las visualizaciones exactas, fechas de publicación ni suscriptores de cada vídeo. Algunos resultados mostraban indicadores relativos de «hace X días», pero muchos tenían más de 300 días, así que el informe prioriza temas que se pudieron situar claramente dentro de 60 días (GPT Image 2.5: 8/9/2026; vídeos de noticias semanales con fecha explícita).
- Se confirmó la existencia de vídeos relacionados con Runway Gen-4.5, Grok Imagine, Seedream 4.0 y Midjourney V8, pero no se obtuvo información suficiente para confirmar fechas de publicación o detalles de canal; por ello no se incluyeron en Vídeos (su existencia se confirmó mediante búsqueda web).
- Esta vez no se pudieron analizar los comentarios, ya que no fue posible obtener el contenido de las páginas de vídeo.
Bluesky
Bluesky — Noticias de IA para generación de imágenes y vídeo (propietaria/código abierto)
Sobre la metodología: el sitio oficial de Bluesky (bsky.app) es una SPA y no permite renderizar resultados de búsqueda; por ello se consultó directamente la API pública de AT Protocol (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts, sin autenticación) para obtener datos reales de publicaciones (texto, autor, número de me gusta y fecha). Se buscaron términos como «Nano Banana», «Sora 2», «Flux», «ComfyUI», «Z-Image», «Qwen Image», «open weights» y «Veo 3», se revisaron más de 100 publicaciones reales y se seleccionaron las que correspondían al tema.
Cuentas
- Eliot Higgins(
eliothiggins.bsky.social, fundador de Bellingcat, verificado en Bluesky)— Comunica de forma continua los riesgos de desinformación y deepfakes de Veo 3. - Simon Willison(
simonwillison.net, investigador independiente de IA, verificado en Bluesky)— Ejecuta realmente en local modelos de pesos abiertos como Qwen-Image / Qwen-Image-Edit y publica notas técnicas. - Ethan Mollick(
emollick.bsky.social, profesor de Wharton, verificado en Bluesky)— Comenta regularmente riesgos y capacidades de modelos de pesos abiertos. - Periodistas de 404 Media(Jason Koebler
jasonkoebler.bsky.social, Sam Colesamleecole.bsky.social)— Realizan periodismo de investigación sobre problemas de copyright y moderación de contenido de Sora 2. - obeca(
obeca.bsky.social, ámbito turco)— Cuenta personal que publica casi a diario imágenes generadas con Nano Banana 2. - Ria_Tatibana(
ria-tatibana.bsky.social, ámbito japonés)— Publica ilustraciones diarias con ComfyUI + Krea2 (modelos de código abierto). - cubby.jpg(
cubby-ai.bsky.social)— Cuenta que produce arte con IA usando modelos abiertos como Z-Image / Qwen-Image. - AlternativeTo(
alternativeto.net)— Cuenta automatizada de noticias de software que informa rápidamente de lanzamientos como Qwen-Image-2.1.
Publicaciones
Código propietario
- El problema de que Google Veo 3 pueda generar contenido racista — Eliot Higgins, 2025-06-22, ❤️842. «Google Veo 3 providing new and exciting ways to do racism.» https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y
- TIME logró generar con Veo 3 vídeos falsos de musulmanes incendiando templos hindúes; Google añadió marcas de agua visibles tras las preguntas de los periodistas — Aman Batheja (periodista de TIME), 2025-06-03, ❤️431 · 🔁192 · citas 107. «New: TIME reporters were able to use Google's AI video tool to make convincing videos of Muslims setting fire to a Hindu temple...» https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h
- Se señala que Sora 2 cuesta aproximadamente 5.000 millones de dólares al año y hasta ahora ha generado alrededor de 1,4 millones de ingresos para OpenAI — Peter Labuza, 2026-02-10, ❤️1.375 · 🔁368 · citas 192. «Sora 2 apparently cost something like $5 billion to run every year and so far made OpenAI around $1.4 million.» https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o
- Crítica que sostiene que Sora simboliza el derrumbe de la pretensión de las empresas de IA de no entrenar con obras protegidas por copyright — Jason Koebler (404 Media), 2025-10-01, ❤️1.508 · citas 44. «The Sora thing is so bleak and shows how far we've come from AI companies pretending they did not train on copyrighted material» https://bsky.app/profile/jasonkoebler.bsky.social/post/3m25uzxbcak23
- Reportaje sobre el gran enfado de usuarios cuando Sora 2 prohibió generar personajes con copyright — Sam Cole (404 Media), 2025-10-08, ❤️435 · citas 37. «the only thing people want to do on Sora, it seems, is generate images of copyrighted characters. now that they can't, they're crashing the fuck out» https://bsky.app/profile/samleecole.bsky.social/post/3m2ovizmqks2t
- Testimonio de alguien que se sintió engañado por imágenes generadas con Nano Banana (2) — furuakasaber.bsky.social, 2026-07-03, ❤️333. «This Nano Banana bullshit fooled me even tho I felt that it was something off about it. Kinda scary» https://bsky.app/profile/furuakasaber.bsky.social/post/3mpr6djkzsk2e
- Cansancio ante las infografías de Nano Banana («diagramas que parecen IA») — garrison.corporate.fm, 2026-03-15, ❤️73 · 🔁9. «nano banana infographics must be stopped at any cost» https://bsky.app/profile/garrison.corporate.fm/post/3mh4g5avqp22p
Código abierto
- Alibaba Qwen publica su primer modelo de generación de imágenes, «Qwen-Image», con licencia Apache 2.0 — Simon Willison, 2025-08-04, ❤️46. «Qwen released their first image generation model today, Qwen-Image - it's Apache 2.0 like their LLMs» https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223
- Prueba real de Qwen-Image-Edit: un informe indica que en Mac consume casi todos los 64 GB de RAM y requiere 54 GB de disco — Simon Willison, 2025-08-19, ❤️77. «Notes on running the new Qwen-Image-Edit model on my Mac...It took almost ALL of my 64GB of RAM and needed 54GB of disk space» https://bsky.app/profile/simonwillison.net/post/3lws3xfzhv22u
- Alibaba publica «Qwen-Image-2.1», un modelo de 7.000 millones de parámetros, con pesos abiertos y un cambio de licencia — AlternativeTo, 2026-09-24, ❤️6. «Alibaba Cloud has released Qwen-Image-2.1, a 7B parameter model...there's a license change.» https://bsky.app/profile/alternativeto.net/post/3mwaq75byhn2a
- Apple publica los pesos abiertos de los modelos Transformer autoregresivos de flujo «STARFlow» y «STARFlow-V» para generar imágenes y vídeo — Sung Kim, 2025-12-02, ❤️13. «Apple released the open-weights of both STARFlow and STARFlow-V, state-of-the-art transformer autoregressive flow models for high-quality image and video generation.» https://bsky.app/profile/sungkim.bsky.social/post/3m6xsab2zj22w
- Advertencia: el modelo de pesos abiertos «GLM-5.3» es muy capaz, pero casi no tiene barreras de seguridad e incluso posee capacidades cibernéticas ofensivas — Ethan Mollick, 2026-08-28, ❤️88. «Open weights models have effectively no guardrails, and they only provide minimal risk testing» https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o
- Ilustraciones diarias con ComfyUI + Krea2 (modelo abierto), con entre ❤️50 y 80 por publicación — Ria_Tatibana, varias publicaciones entre 2026-09-28 y 10-01 (ejemplo: https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t, ❤️53). La mayoría de los primeros resultados de la etiqueta ComfyUI son compartidos cotidianos de obras por artistas de IA.
- Expectación e ironía ante el nuevo lanzamiento de Z-Image (modelo de imagen abierto y ligero de Alibaba Tongyi) — theophite.bsky.social, 2025-11-27, ❤️30. «not looking forward to the release of z-image» https://bsky.app/profile/theophite.bsky.social/post/3m6ldsilaz22f
Señales
- Veo 3 se ha asentado como «herramienta de desinformación»: Eliot Higgins, fundador de Bellingcat, lo trata repetidamente, y también se difundió la investigación de TIME (❤️431, 107 citas). El principal asunto de la generación de vídeo propietaria ha pasado de la «calidad» al «uso indebido».
- Sora 2 afronta dificultades económicas y polémicas continuas: La cifra de 5.000 millones de dólares de costes anuales frente a 1,4 millones de ingresos (❤️1.375) se difundió ampliamente. El enfado de usuarios por restricciones más severas sobre personajes con copyright (❤️435) vuelve a mostrar la estructura de «cambio de reglas del modelo propietario → reacción de usuarios».
- Nano Banana (Google) ya es la herramienta predeterminada de generación de imágenes para usuarios casuales: Personas como obeca.bsky.social publican imágenes generadas casi todos los días, y la herramienta se ha asentado en contextos no anglófonos como el turco y el japonés. Aun así, persisten voces que dicen que es aterrador no poder distinguirlas (❤️333).
- Qwen-Image es el tema técnico central de la generación de imágenes de código abierto: Investigadores de IA como Simon Willison realizan pruebas reales, incluso de consumo de VRAM/disco, y la licencia Apache 2.0 recibe valoraciones positivas. Sin embargo, Qwen-Image-2.1 cambió de licencia (mencionado en una publicación de ❤️6), lo que crea tensión incluso en el lado abierto sobre si es realmente abierto.
- ComfyUI sigue siendo el flujo de trabajo estándar de facto para la generación abierta de imágenes: La mayoría de resultados son compartidos cotidianos de ilustraciones creadas con ComfyUI + modelos concretos (Krea2, SDXL, etc.), lo que muestra su consolidación como herramienta integrada en la vida diaria, más que como noticia técnica.
- Pesos abiertos = alto rendimiento pero ausencia de barreras de seguridad, según advierten expertos: Cuentas investigadoras destacadas como Ethan Mollick han empezado a señalar las capacidades ofensivas y las pruebas de riesgo mínimas de modelos como GLM-5.3. Grandes empresas como Apple (STARFlow) también se incorporan a la publicación de pesos abiertos, ampliando la base del bando abierto.
Límites
- El sitio oficial de Bluesky (bsky.app) es una SPA, por lo que WebFetch no pudo obtener directamente el texto de las publicaciones; el endpoint de búsqueda de
public.api.bsky.apptambién devolvía 403. Finalmente, la misma API deapi.bsky.app(sin «public.») respondió sin autenticación, y se utilizó para recuperar datos reales. - Palabras clave propensas a colisionar con sustantivos comunes u otros ámbitos (juegos, clima, nombres), como «Flux», «Kling» y «Wan», generaron mucho ruido y no permitieron reunir suficientes publicaciones pertinentes (la búsqueda de Flux devolvió 15 resultados, pero prácticamente 0 relacionados con generación de imágenes por IA). No se comprobó suficiente volumen de conversación sobre FLUX.2 de Black Forest Labs en Bluesky.
- Los nombres individuales de modelos de generación de vídeo, abiertos o propietarios, como Kling 2.5, Wan 2.5, HunyuanVideo y Seedance, no produjeron suficientes resultados con las palabras clave de esta búsqueda; no pudo confirmarse que fueran tema de conversación en Bluesky (puede que YouTube sea más activo).
- Incluso con
sort=top, la API de búsqueda no necesariamente ordena por popularidad real (se observaron fechas mezcladas en la paginación basada en cursor); las «publicaciones representativas» obtenidas son extractos seleccionados por relevancia y existencia verificada, no un ranking de popularidad estricto.
Lemmy
Lemmy — Movimientos en IA de generación de imágenes y vídeo (propietaria/código abierto)
Comunidades
- !«メールアドレス» — Comunidad principal donde se concentran los lanzamientos de modelos y herramientas de código abierto. La frecuencia de publicaciones es alta, pero la puntuación de cada una suele ser de un dígito a alrededor de 10, por lo que es pequeña.
- !«メールアドレス» / !«メールアドレス» — Publicaciones automáticas conectadas a Civitai que muestran diariamente imágenes generadas (Krea, modelos SDXL, etc.). Tienen poco valor noticioso, pero sirven como evidencia del uso cotidiano de modelos abiertos.
- !«メールアドレス» / !«メールアドレス» — Comunidades de ejemplos de arte abstracto que hacen cross-post de las mismas imágenes.
- !«メールアドレス» — Comunidad gestionada por un bot que replica subreddits de IA (r/ArtificialIntelligence, etc.). Es la principal vía de entrada para noticias propietarias (Sora, Nano Banana, Seedream, etc.), pero casi todas tienen puntuaciones de 0 a 1 y apenas hay conversación.
- !«メールアドレス» / !«メールアドレス» / !tech — Aquí aparecen de forma aislada noticias relacionadas con FLUX de Black Forest Labs.
- !«メールアドレス» / !casual_perchance — Comunidades de usuarios del servicio gratuito de generación de imágenes en navegador Perchance.org.
- No fue posible confirmar la cantidad de suscriptores: las páginas de comunidad de Lemmy.world (
/c/<name>) devolvían repetidamente 500/400 y la API (/api/v3/community) no permitía obtenerlos por parámetros desconocidos (véase Límites).
Publicaciones
Tendencia de código abierto
- scraed/LanPaint — Inpainting de alta calidad sin entrenamiento para cualquier modelo Stable Diffusion (compatible con ComfyUI) / !«メールアドレス» / puntuación 8 / 2026-09-29 / https://github.com/scraed/LanPaint/
- DenRakEiw/scumble — Editor de escritorio dedicado a inpainting con IA que admite capas, selección de texto y pinceles personalizados. Dibuja mediante ComfyUI propio o proveedores de API y es compatible con MCP / !«メールアドレス» / puntuación 3 / 2026-09-29 / https://github.com/DenRakEiw/scumble
- ogoun/fooocus-qwen-image-2.1 — WebUI para Qwen-Image-2.1 / !«メールアドレス» / puntuación 2 / 2026-09-27 / https://github.com/ogoun/fooocus-qwen-image-2.1
- PrunaAI/Pruna-Qwen-Image-2.1 — Adaptador LoRA de pocos pasos para Qwen-Image-2.1 (apareció al mismo tiempo que el ControlNet union
QwenImage_experimentalde Kijai, y el conjunto de herramientas alrededor de Qwen-Image-2.1 creció de golpe) / !«メールアドレス» / puntuación 0 / 2026-09-26 / https://huggingface.co/PrunaAI/Pruna-Qwen-Image-2.1 - black-forest-labs/FLUX.2-klein-9b-kv-fp8 — Versión cuantizada FP8 del modelo de pesos abiertos de 9B de Black Forest Labs / !«メールアドレス» / puntuación 8 / 2026-03-14 / https://huggingface.co/black-forest-labs/FLUX.2-klein-9b-kv-fp8
- Alice v1: generación de vídeo mejorada mediante destilación que supera a modelos propietarios — Modelo abierto de generación de vídeo que afirma superar a modelos de vídeo propietarios gracias a una destilación mejorada / !«メールアドレス» / puntuación 5 / 2026-05-13 / (adjunto webm, pictrs de lemmy.dbzer0.com)
Tendencia de código propietario
- Black Forest Labs anuncia «FLUX 3» — Además de imágenes, puede generar vídeos de 20 segundos con audio; inicialmente es una publicación limitada / !«メールアドレス» / puntuación 1 / 2026-07-24 / https://bfl.ai/blog/flux-3
- OpenAI cierra la API de Sora la próxima semana (24/9), mientras competidores chinos recaudan 3.000 millones de dólares — Análisis que sostiene que el vídeo con IA para consumidores no es rentable y que empresas orientadas a clientes corporativos, como Kling, atraen financiación / !«メールアドレス» / puntuación 1 / 2026-09-20 / https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Google retira en un día la función de IA de Google Earth (Nano Banana 2) — Función suspendida por uso indebido / !«メールアドレス» / puntuación 1 / 2026-08-07 / https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Comparativa y explicación técnica honesta de Seedream 5.0 Pro (frente a Nano Banana Pro) / !«メールアドレス» / puntuación 1 / 2026-07-10 / https://www.reddit.com/gallery/1usc03q
- «Colorear la misma doble página de Berserk con cuatro IA» — Prueba que compara ChatGPT Images 2.5 / Wan 2.7 Pro / Nano Banana Pro / Seedream 5.0 Pro bajo las mismas condiciones; hay voces que dan la victoria a GPT / !«メールアドレス» / puntuación 1 / 2026-09-14 / https://www.reddit.com/gallery/1wfyqdy
- Se aplica el mismo prompt a seis modelos de vídeo con IA y unas 40 personas los evalúan a ciegas — Google Veo queda primero y los tres primeros modelos están muy igualados / !«メールアドレス» / puntuación 1 / 2026-09-17 / https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- ByteDance anuncia Seedance 2.5 — Añade generación de toma única y referencias flexibles / !«メールアドレス» / puntuación 3 / 2026-08-01 / https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5
- Runway afirma que su negocio corporativo se duplicó y que su NRR supera el 300 % / !«メールアドレス» / puntuación 0 / 2026-08-30 / https://www.reddit.com/r/ArtificialInteligence/comments/1w2hnea/
Señales
- Qwen-Image-2.1 es el núcleo del lado abierto en Lemmy: WebUI (derivada de fooocus), ControlNet (Kijai) y LoRA de pocos pasos (PrunaAI) se publicaron consecutivamente durante la misma semana (26-27/9), por lo que la familia Qwen-Image se ha convertido en el principal frente actual de la comunidad ComfyUI/Stable Diffusion.
- Un movimiento de «los modelos propietarios derriban por sí mismos la frontera»: Black Forest Labs, tradicionalmente centrada en pesos abiertos, lanzó FLUX 3 como una publicación «cerrada y limitada» con vídeo y audio, mientras continúa publicando en paralelo versiones de pesos abiertos como FLUX.2-klein-9b; la frontera abierto/cerrado se está volviendo ambigua.
- Nano Banana 2 es a la vez conversación y foco de conflicto: La integración en Google Earth y retirada al día siguiente por uso indebido fue la noticia más destacada (puntuación 6; el resto tiene en general puntuaciones bajas).
- El tono sobre vídeo con IA es «para consumidores no es rentable»: A través de varios posts espejo de Reddit se contrasta el cierre de la API de Sora por OpenAI con Kling/Seedance/Runway, que se centran en clientes corporativos y ganan en financiación e ingresos.
- Abundan las comparativas lado a lado: Se repiten publicaciones que comparan Nano Banana Pro / Seedream 5.0 Pro / Wan 2.7 Pro / ChatGPT Images 2.5 en las mismas condiciones; a los usuarios les interesa más «cuál es mejor» que las noticias aisladas.
- Casi no hay discusión propia de Lemmy: La mayoría de publicaciones encontradas llegan por el bot espejo de Reddit !ai_reddit, con puntuaciones de 0 a 1 y pocos comentarios. Los únicos análisis originales procedentes de Lemmy son las publicaciones de herramientas en !«メールアドレス».
Límites
- Lemmy no cuenta con una gran comunidad específica de IA para generación de imágenes y vídeo; la conversación se dispersa entre la pequeña !«メールアドレス» (publicaciones de herramientas y modelos, puntuaciones de un dígito) y la comunidad bot !ai_reddit (puntuaciones de 0 a 1), que transfiere directamente publicaciones de Reddit. Esta última es, en la práctica, una republicación de Reddit, no una opinión propia de Lemmy.
- No se pudo obtener el número de suscriptores de las comunidades.
https://lemmy.world/c/<community>devolvía HTTP 500 repetidamente yhttps://lemmy.world/api/v3/community?name=...devolvía HTTP 400 (posiblemente la especificación de parámetros difiere de la documentación habitual de v3 o la instancia aplica restricciones). - Búsquedas por términos como "Grok Imagine", "Kling AI", "Runway Gen", "HunyuanVideo" o "Flux" por separado apenas devolvieron publicaciones relevantes (solo ruido), lo que indica que Lemmy tiene pocas menciones de esos nombres específicos.
- Aunque la API de búsqueda de lemmy.world afirma buscar de forma federada entre instancias, en la práctica devuelve principalmente publicaciones de lemmy.world / lemmy.ml / lemmy.dbzer0.com / lemmy.today / lemmy.zip; no hubo tiempo para buscar individualmente lemmy.ml o lemm.ee.
- Las puntuaciones de las publicaciones son generalmente bajas (la mayoría entre 0 y 10), por lo que no puede decirse que haya un gran entusiasmo. Esto se debe tanto a que Lemmy es de por sí pequeño como a que el tema de IA para generación de imágenes/vídeo carece de una comunidad dedicada allí frente a Reddit/X.
Pinterest — Noticias de IA para generación de imágenes y vídeo
Se recopilaron 50 pines (sin clasificación por género, un único conjunto). Se abrieron y comprobaron los títulos y las imágenes en miniatura.
Temas visuales
- Miniaturas de «YouTuber con cara de sorpresa + conjunto de logotipos» — Aparecen repetidamente imágenes de noticias de IA con logotipos neón de OpenAI, Google, Meta, Microsoft y Anthropic, y un hombre sorprendido al lado. Las noticias más recientes del bando propietario usan casi siempre este formato fijo
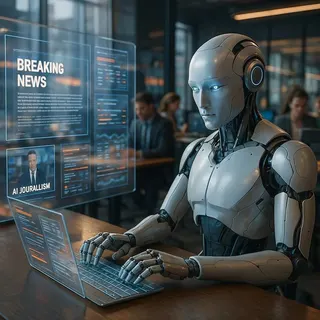
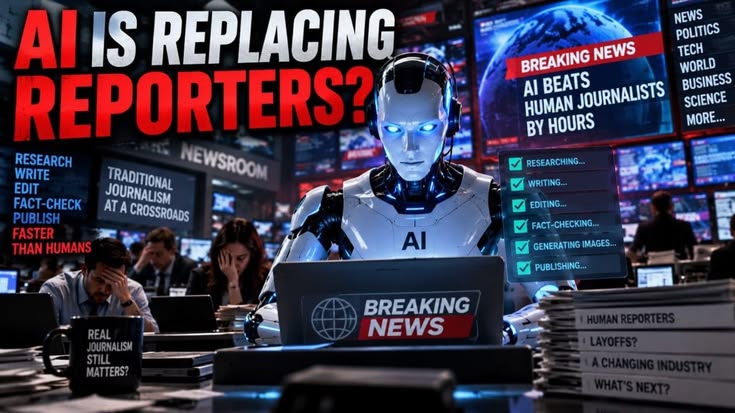
[2, 7, 23, 41] - El robot como presentador de noticias aparece una y otra vez. Androides blancos con traje delante de un panel de «BREAKING NEWS» o imágenes futuristas donde un presentador de IA toma el control de un estudio de noticias
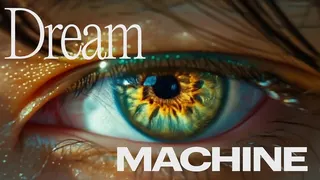
[23, 45] - Imágenes de demostración de retratos fotorrealistas — Rostros de hombres mayores muy trabajados, hasta las arrugas, la barba y la textura, se usan repetidamente como imagen estrella de anuncios de modelos nuevos (AMD Amuse 3.0, primeros planos del ojo de Luma Dream Machine). El realismo es la referencia actual
[43, 47] - Imágenes de comparación en cuadrícula que convierten la misma fuente de vídeo en múltiples estilos — Demostraciones de «coherencia de estilo» que regeneran la misma persona o coche en madera tallada, origami, LEGO, decoración floral y otros materiales
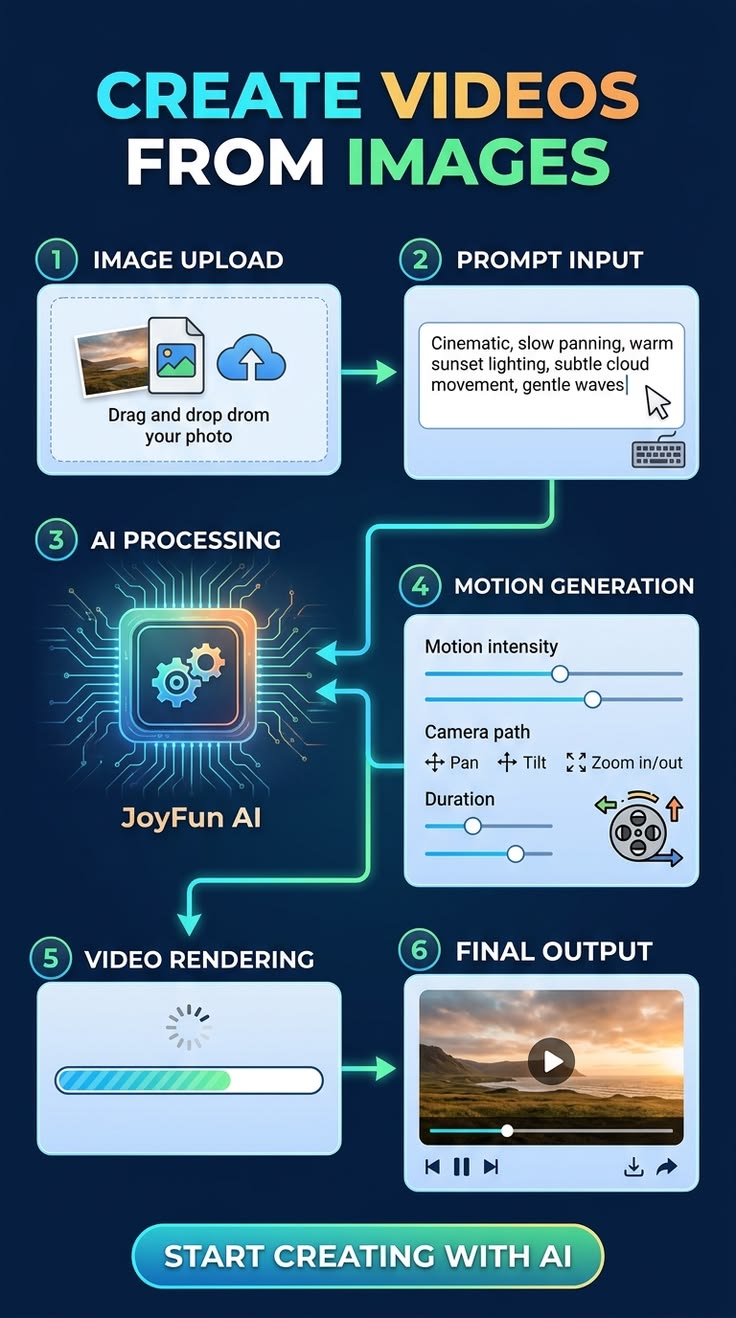
[4] - Maquetas de interfaz futurista de neón — Hay muchas imágenes promocionales abstractas que venden conjuntamente «generación de imagen/vídeo/música/texto» con iconos luminosos, siluetas de cabezas con patrones de circuitos y dashboards holográficos
[5, 9, 22, 50] - Infografías comparativas y tablas de consulta rápida de herramientas — Gráficos de estilo neón/cyber que colocan logotipos de ChatGPT/Midjourney/Gemini/Runway/Pika/Krea, etc., en una cuadrícula y recomiendan «este si pagas, este si quieres gratis»
[40] - Visuales de advertencia sobre detección de falsificaciones y ética de IA — Un robot que sospecha de una imagen de gato con un sello «FAKE», infografías de antes/después de ojos que dicen «no creas solo por lo que ves», etc.; hay una cantidad notable de contenido sobre desconfianza y verificación de IA
[1, 20, 32, 37] - También hay pines cuyo título y su imagen no encajan — Por ejemplo, un título sobre que Stability AI entra en generación de vídeo acompañado realmente de un collage de moodboards de fantasía. Da la impresión de que abundan las miniaturas recicladas para conseguir clics
[29]
Pines destacados
- [2] AI News: Anthropic Leak Shows Us The Future of AI... — Miniatura estándar de «AI NEWS» con los logotipos iluminados de OpenAI, Google, Microsoft y Anthropic. Vídeo-resumen de movimientos de empresas propietarias.
- [4] Google announces ultra-high quality video... — Imagen de comparación en cuadrícula que regenera la misma persona y coche en madera/origami/LEGO/flores. Demostración clara de consistencia de estilo.
- [5] Meta Unveils Muse Image and Muse Video Generative... — Banner de ciencia ficción para «Meta Muse Spark AI Model 2026», que enfatiza la línea de asistentes personales de IA.
- [23] Discover how Grok is revolutionizing video... — Visual de un presentador androide blanco ante un panel «BREAKING NEWS». Una visión de futuro donde la IA crea noticias.
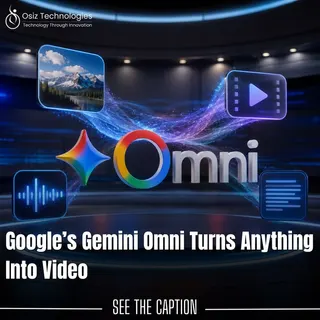
- [26] Google's Gemini Omni Turns Anything Into Video — Logotipo «Omni» en el centro, rodeado de iconos de imagen, vídeo, audio y texto, que promociona integración multimodal.
- [38] Google Unveils Veo 2: Advanced AI Video Generation... — Banner de apariencia oficial de Veo2, con el reclamo «state-of-the-art video generation model» y muestras de vídeo real y animación.
- [43] Introducing Luma Dream Machine - Next Generation AI Video — Primer plano de un ojo con la tipografía «Dream Machine». Imagen simbólica que promociona potencia de generación fotorrealista.
- [47] 'Amuse 3.0', an AI art creation tool that includes... — Herramienta de arte con IA de AMD para ejecución local. La demostración es un retrato fotorrealista de un pescador anciano, que promociona generación seria sobre GPU; es una de las pocas herramientas concretas de tendencia abierta/local.
- [40] Top AI Video Generators of 2025 — Tabla comparativa neón que distribuye ChatGPT Plus, Midjourney, Runway, Pika, Kaiber y otros entre «prioridad calidad» y «prioridad gratis». Información práctica para elegir herramientas.
- [20] 'AI is getting scary good.' — Infografía de advertencia que reúne generación de vídeo con IA, detección de voz y prompt engineering. Transmite una postura de alfabetización en IA generativa: «no creas solo por la apariencia».
Señales
- En Pinterest, las «noticias de IA para generación de imágenes y vídeo» están dominadas de forma abrumadora por miniaturas de noticias del lado propietario (OpenAI, Google Veo/Gemini Omni, Meta Muse, Grok, Midjourney, Runway, Pika). Predomina el formato de «cara sorprendida + conjunto de logotipos», como si las miniaturas de vídeos de YouTube se hubieran convertido directamente en pines: prima el atractivo del clic sobre la profundidad informativa.
- Los temas de código abierto/generación local son escasos. Los únicos nombres concretos son Stability AI (aunque solo en el título; la imagen es un moodboard no relacionado) y AMD Amuse 3.0 (herramienta de ejecución local en GPU). No apareció ni una visual técnica de comunidad, como ComfyUI, Hugging Face o diagramas de arquitectura de modelos de difusión.
- La generación de personas fotorrealistas —caras cuidadas hasta arrugas y texturas— se usa repetidamente en todas las empresas como visual de referencia para decir «esto es lo que se puede hacer ahora», una señal de madurez tecnológica.
- Entre las infografías hay una presencia constante de desconfianza y verificación de contenido generado por IA (detección de falsificaciones, autenticidad de voces, ética), lo que hace visible que el interés por «cómo distinguirlo» y «cómo usarlo correctamente» es tan grande como el interés por generar contenido.
- Por el contrario, están ausentes: pines que traten directamente nombres concretos de modelos abiertos (Stable Diffusion, FLUX, Wan, HunyuanVideo, etc.), capturas de GitHub/blogs técnicos y pines con artículos de investigación o cifras de benchmarks. Por la naturaleza de Pinterest, predominan resúmenes secundarios de noticias, tablas comparativas y banners publicitarios, en lugar de información primaria de comunidades técnicas.
Límites
output/pinterest.pins.mdno incluye clasificación por género (genreestá vacío), y se proporcionó como un único conjunto de 50 elementos; por ello no fue posible hacer los «resúmenes por género» que contempla el manual: se analizó todo como un solo conjunto.- Se abrieron y revisaron visualmente 18 de 50 imágenes, seleccionadas considerando la concreción de los títulos y la dispersión de temas. Las 32 restantes no se comprobaron, pero la repetición de formatos dentro de la muestra fue suficiente para revelar el patrón.
- Varios pines no hacen coincidir título e imagen real (por ejemplo, el título relacionado con Stability AI de
[29]aparece con un moodboard no relacionado); en esos casos se mencionó el contexto del título, no el contenido visual. - No se navegó Pinterest directamente: solo se utilizaron imágenes y títulos recopilados previamente por el trabajador. No pudieron verificarse los números reales de interacción de cada pin (guardados/me gusta) ni el texto de los artículos enlazados.
Acciones recomendadas
- Repetir la etapa de X con palabras clave directas de IA (Midjourney, Sora, Nano Banana, ComfyUI, Flux) en lugar de tendencias genéricas.
- Seguir vigilando el ecosistema Qwen-Image-2.1 (WebUI, LoRA, ControlNet) como indicador principal del impulso del código abierto.
- Seguir la brecha entre costes e ingresos de Sora 2 como indicador indirecto de la rentabilidad de la generación de vídeo propietaria.
- Mapear qué herramientas eligen los usuarios cuando una herramienta propietaria endurece sus barreras de seguridad.
- Ampliar el muestreo de Pinterest más allá de 18 de 50 pines, o buscar una forma de recuperar cifras de interacción.
- Tratar la comunidad !ai_reddit de Lemmy como un espejo de Reddit, no como una señal independiente, al ponderar los hallazgos.
Imágenes recopiladas





























Nota sobre la calidad de los datos
La etapa de X recopiló publicaciones de tendencias genéricas en lugar de búsquedas relacionadas con IA y no aportó nada; YouTube y Pinterest no pudieron confirmar métricas de interacción (visualizaciones/suscriptores o guardados/me gusta) debido al renderizado con JavaScript y a los límites de muestreo, mientras que Reddit y Bluesky se basaron en datos reales recopilados o de API y son las fuentes más fiables en este caso.